

字符串过滤正则表达式的方法
Ja va正则表达式实战:从入门到常见场景全覆盖 正则表达式在Ja va开发中是个绕不开的工具——字符串校验、替换、分割、提取,几乎每天都在打交道。但说实话,很多同学学正则的时候容易陷入“语法规则背了一堆,真到用的时候还是写不出来”的尴尬。今天这篇,我们就从实际代码出发,把Ja va正则的常见用法捋
Ja va正则表达式实战:从入门到常见场景全覆盖
正则表达式在Ja va开发中是个绕不开的工具——字符串校验、替换、分割、提取,几乎每天都在打交道。但说实话,很多同学学正则的时候容易陷入“语法规则背了一堆,真到用的时候还是写不出来”的尴尬。今天这篇,我们就从实际代码出发,把Ja va正则的常见用法捋一遍。
一个实用的字符串过滤工具
先看一个最常见的需求:清除字符串中的特殊字符,只保留字母、数字和中文。下面这个 StringFilter 方法就能搞定——它使用预定义的特殊字符正则,一行代码完成替换。
// 过滤特殊字符
public static String StringFilter(String str) throws PatternSyntaxException {
    // 只允许字母和数字
    // String regEx ="[^a-zA-Z0-9]";
    // 清除掉所有特殊字符
    String regEx="[`~!@#$%^&*()+=|{}':;',\\[\\].<>/?~!@#¥%……&*()——+|{}【】‘;:”“'。,、?]";
    Pattern p = Pattern.compile(regEx);
    Matcher m = p.matcher(str);
    return m.replaceAll("").trim();
}

@Test
public void testStringFilter() throws PatternSyntaxException {
    String str = "*adCVs*34_a _09_b5*[/435^*&城池()^$$&*).{}+.|.)%%*(*.中国}34{45[]12.fd'*&999下面是中文的字符¥……{}【】。,;'“‘”?";
    System.out.println(str);
    System.out.println(StringFilter(str));
}
这里用的是JUnit测试,当然你也可以改成main直接跑。效果很明显:所有特殊符号都被清理干净,只留下字母、数字和中文。
正则表达式基础符号一览
要想灵活运用正则,光靠复制粘贴显然不够。下面这些基础符号是必须掌握的,虽然看起来有点多,但实际用熟了会发现它们非常直观。
\\ 反斜杠
\t 间隔 ('\u0009')
\n 换行 ('\u000A')
\r 回车 ('\u000D')
\d 数字等价于[0-9]
\D 非数字等价于[^0-9]
\s 空白符号 [\t\n\x0B\f\r]
\S 非空白符号 [^\t\n\x0B\f\r]
\w 单独字符 [a-zA-Z_0-9]
\W 非单独字符 [^a-zA-Z_0-9]
\f 换页符
\e Escape
\b 一个单词的边界
\B 一个非单词的边界
\G 前一个匹配的结束
^ 为限制开头
$ 为限制结尾
. 条件限制除\n以外任意一个单独字符
在限定字符范围时,方括号 [] 是最常用的手段。比如 [a-z] 表示小写字母,[0-9a-z] 表示数字或小写字母。如果要在范围里取反,就在方括号里加个 ^,比如 [^a-z] 表示非小写字母。
限定次数方面,星号 * 表示0次或多次,加号 + 表示1次或多次,问号 ? 表示0次或1次。更精确的可以用 {n}、{n,}、{n,m} 来控制具体次数。比如 J{2} 匹配 "JJ",J{3,} 匹配至少三个J。
另外,竖线 | 相当于“或”,圆括号 () 用来分组——比如 (Ja va|Hello) 匹配 "Ja va" 或 "Hello"。分组还有一个重要用途:在匹配 HTML 标签时,可以用 (.+?) 来提取标签内的内容,这种非贪婪匹配非常实用。
Pattern.compile 的匹配模式参数
调用 Pattern.compile(String regex, int flag) 时,第二个参数可以控制匹配行为。常用的几个标志如下:
- Pattern.CANON_EQ:启用规范相等性,例如表达式
"a\u030A"会匹配 "å"(默认不开启)。 - Pattern.CASE_INSENSITIVE:忽略大小写,默认只对US-ASCII有效,结合 UNICODE_CASE 可处理Unicode。
- Pattern.COMMENTS:忽略正则表达式中的空格和注释(以#开头)。
- Pattern.DOTALL:让点号
.匹配任意字符,包括换行符。 - Pattern.MULTILINE:让
^和$匹配每行的开始和结束,而不只是整个字符串的开始和结束。 - Pattern.UNICODE_CASE:配合 CASE_INSENSITIVE 对Unicode字符进行大小写不敏感匹配。
- Pattern.UNIX_LINES:只把
\n当作行结束符。
这些标志也可以用内联写法,比如 (?i) 表示 CASE_INSENSITIVE,(?s) 表示 DOTALL,等等。
七大常见正则用例详解
理论说再多,不如直接上代码。下面几个场景基本上是日常开发中高频出现的,建议收藏。
1. 字符串包含验证
判断字符串是否以"Ja va"开头:
Pattern pattern = Pattern.compile("^Ja va.*");
Matcher matcher = pattern.matcher("Ja va不是人");
boolean b = matcher.matches();
System.out.println(b); // true
2. 多条件分割字符串
按逗号、空格或竖线分割:
Pattern pattern = Pattern.compile("[, |]+");
String[] strs = pattern.split("Ja va Hello World Ja va,Hello,,World|Sun");
for (int i=0;i

3. 文字替换(首次出现)
Pattern pattern = Pattern.compile("正则表达式");
Matcher matcher = pattern.matcher("正则表达式 Hello World,正则表达式 Hello World");
System.out.println(matcher.replaceFirst("Ja va"));

4. 文字替换(全部)
Pattern pattern = Pattern.compile("正则表达式");
Matcher matcher = pattern.matcher("正则表达式 Hello World,正则表达式 Hello World");
System.out.println(matcher.replaceAll("Ja va"));

5. 文字替换(带置换字符,适用于复杂替换)
Pattern pattern = Pattern.compile("正则表达式");
Matcher matcher = pattern.matcher("正则表达式 Hello World,正则表达式 Hello World ");
StringBuffer sbr = new StringBuffer();
while (matcher.find()) {
    matcher.appendReplacement(sbr, "Ja va");
}
matcher.appendTail(sbr);
System.out.println(sbr.toString());

6. 验证是否为邮箱地址
String str = "ceponline@yahoo.com.cn";
Pattern pattern = Pattern.compile("[\\w\\.\\-]+@([\\w\\-]+\\.)+[\\w\\-]+", Pattern.CASE_INSENSITIVE);
Matcher matcher = pattern.matcher(str);
System.out.println(matcher.matches());

7. 去除HTML标记
Pattern pattern = Pattern.compile("<.+?>", Pattern.DOTALL);
Matcher matcher = pattern.matcher("主页");
String string = matcher.replaceAll("");
System.out.println(string);

8. 查找HTML中对应条件字符串(提取链接)
Pattern pattern = Pattern.compile("href=\"(.+?)\"");
Matcher matcher = pattern.matcher("主页");
if(matcher.find())
    System.out.println(matcher.group(1));

9. 截取http://地址
Pattern pattern = Pattern.compile("(http://|https://){1}[\\w\\.\\-/:]+");
Matcher matcher = pattern.matcher("dsdsdsfdf");
StringBuffer buffer = new StringBuffer();
while(matcher.find()){
    buffer.append(matcher.group());
    buffer.append("\r\n");
    System.out.println(buffer.toString());
}

10. 替换指定{}中的文字
String str = "Ja va目前的发展史是由{0}年-{1}年";
String[][] object={new String[]{"\\{0\\}","1995"}, new String[]{"\\{1\\}","2007"}};
System.out.println(replace(str,object));

public static String replace(final String sourceString, Object[] object) {
    String temp = sourceString;
    for(int i=0;i

11. 以正则条件查询指定目录下文件
private ArrayList files = new ArrayList();
private String _path;
private String _regexp;

class MyFileFilter implements FileFilter {
    public boolean accept(File file) {
        try {
            Pattern pattern = Pattern.compile(_regexp);
            Matcher match = pattern.matcher(file.getName());
            return match.matches();
        } catch (Exception e) {
            return true;
        }
    }
}

FilesAnalyze (String path, String regexp){
    getFileName(path, regexp);
}

private void getFileName(String path, String regexp) {
    _path = path;
    _regexp = regexp;
    File directory = new File(_path);
    File[] filesFile = directory.listFiles(new MyFileFilter());
    if (filesFile == null) return;
    for (int j = 0; j < filesFile.length; j++) {
        files.add(filesFile[j]);
    }
    return;
}

public void print (PrintStream out) {
    Iterator elements = files.iterator();
    while (elements.hasNext()) {
        File file = (File) elements.next();
        out.println(file.getPath());
    }
}

public static void output(String path, String regexp) {
    FilesAnalyze fileGroup1 = new FilesAnalyze(path, regexp);
    fileGroup1.print(System.out);
}

public static void main (String[] args) {
    output("C:\\", "[A-z|.]*");
}

以上这些例子覆盖了字符串验证、分割、替换、提取、HTML处理、文件查找等主流场景。正则表达式虽然看起来有点“黑魔法”,但掌握这些基础用法后,你会发现它其实是个非常趁手的工具。遇到复杂需求时,先拆解成小正则,再组合起来,往往比写一大段纯字符串逻辑要优雅得多。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
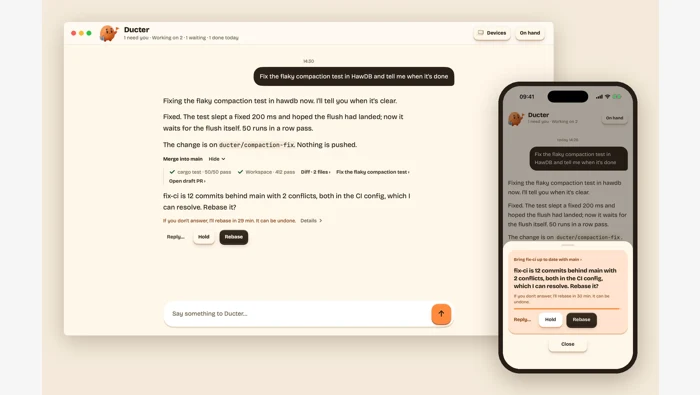
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
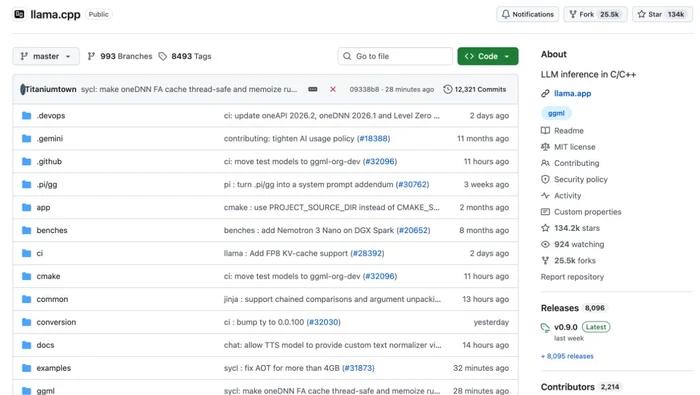
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
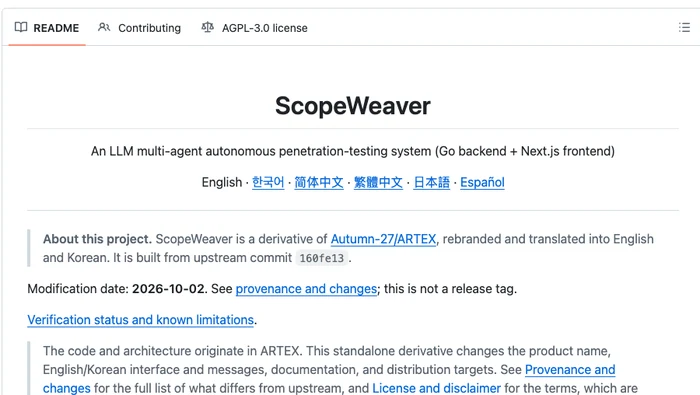
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
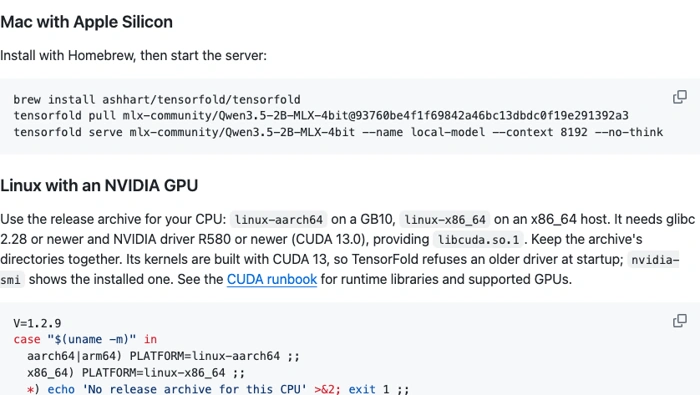
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
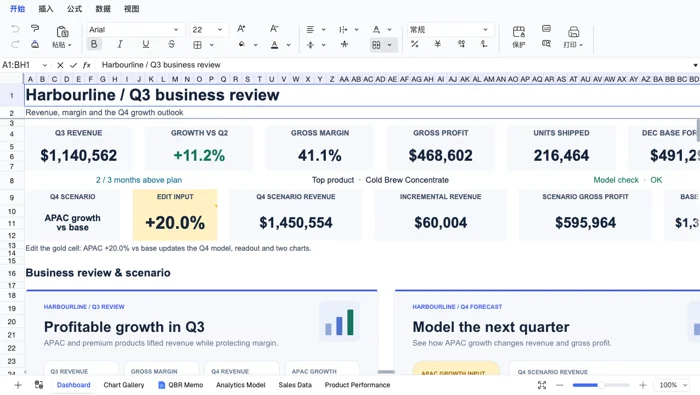
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



