

Python中如何利用公开数据集进行数据分析?
随着大数据时代的到来,数据分析和机器学习已经成为了热门领域。然而,对于初学者来说,如何获取数据集并进行分析和训练模型可能会是一个困难的任务。为了解决这个问题,开源社区已经提供了丰富的数据集,并且Python作为一种流行的编程语言,也提供了各种方法来使用这些数据集。本文介绍在Python中使用开源数据集的方法和工具,例如数据加载、浏览、清洗、可视化和分析。我们
随着大数据时代的到来,数据分析和机器学习已经成为了热门领域。然而,对于初学者来说,如何获取数据集并进行分析和训练模型可能会是一个困难的任务。为了解决这个问题,开源社区已经提供了丰富的数据集,并且Python作为一种流行的编程语言,也提供了各种方法来使用这些数据集。
本文介绍在Python中使用开源数据集的方法和工具,例如数据加载、浏览、清洗、可视化和分析。我们将使用公开的数据集进行实例演示,以帮助读者掌握这些技能。
- 加载数据集
首先,我们需要将数据集加载到Python程序中。有许多开源数据集可以从网络上下载,例如UCI Machine Learning Repository,Kaggle等等。这些数据集一般以CSV、JSON、XML等多种格式进行保存。
在Python中,pandas是一个非常有用的库,我们可以使用pandas通过几行代码来加载CSV格式的数据集:
import pandas as pd

data = pd.read_csv("example.csv")- 数据浏览
一旦数据集被加载到Python中,我们就可以开始浏览这些数据了。我们可以使用pandas的head()方法查看前几行数据:
print(data.head())
如果我们想要查看数据集中的最后几行,我们可以使用tail()方法。
我们也可以使用shape属性来获取数据集的大小:
print(data.shape)
此外,我们可以使用describe()方法来获取数据集的简单统计信息,例如最小值、最大值、平均值等等:
print(data.describe())
- 数据清洗
当我们浏览数据集时,我们可能会发现数据集中存在缺失值、异常值或重复值等问题。在数据分析和机器学习中,这些问题是非常严重的,因此我们需要对它们进行清洗。
对于缺失值,我们可以使用fillna()方法进行填充,以0或者平均值的方式进行:
data.fillna(0, inplace=True)
如果我们想删除数据集中的重复行,可以使用drop_duplicates()方法:
data.drop_duplicates(inplace=True)
对于异常值,我们可以使用标准差来判断是否异常,并将其替换为平均值:
mean = data["col"].mean()
std = data["col"].std()
cut_off = std * 3
lower, upper = mean - cut_off, mean + cut_off
new_data = [x if x > lower and x < upper else mean for x in data["col"]]
data["col"] = new_data
- 数据可视化
数据可视化是数据分析的重要步骤之一,在Python中,我们可以使用Matplotlib和Seaborn等库来进行数据可视化。
例如,我们可以使用Matplotlib库绘制数据集中的折线图:
import matplotlib.pyplot as plt

plt.plot(data["col"])
plt.show()
或者使用Seaborn库的Pairplot方法来进行多个变量的分布图:
import seaborn as sns

sns.pairplot(data)
- 数据分析
在数据可视化之后,我们可以进行更深入的数据分析,例如建立模型、训练模型、预测等等。Python提供了许多库来支持这些操作,例如Scikit-learn和TensorFlow等等。
例如,我们可以使用Scikit-learn库来建立线性回归模型:
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

X = data[["col1", "col2"]]
y = data["target_col"]

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)

model = LinearRegression()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
在以上的例子中,我们使用train_test_split方法将数据集分成了训练集和测试集,然后使用LinearRegression类建立模型,最后使用predict方法对测试集进行预测。
结论
本文介绍了如何在Python中使用开源数据集进行数据分析和机器学习。我们通过使用pandas库来加载和浏览数据集,使用Matplotlib和Seaborn库进行数据可视化,使用Scikit-learn库建立和训练模型。这些技术和工具不仅适用于本文提到的开源数据集,也适用于其他类型的数据集,例如Web数据、传感器数据等等。随着数据分析和机器学习的发展,这些技术和工具也将不断更新和改进,提供更好的性能和易用性。

刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。

近日Cloudflare收购Astro团队,以强化开源Web框架生态。Astro以内容优先、多框架兼容、毫秒级加载著称,收购后继续保持MIT许可,并支持多平台部署。全新Astro6Beta重构开发服务器,原生集成内容安全策略,极大地提升运行性能与开发体验。

要想确认麒麟OS中Python程序的运行状态以及资源占用情况,我们可以这样做:用ps -ef | grep python来筛选进程;通过top命令,按P键排序查看实时负载;使用pgrep -f "script.py"精准获取PID;借助lsof -p PID验证文件打开状态。另外,还可以结合syst
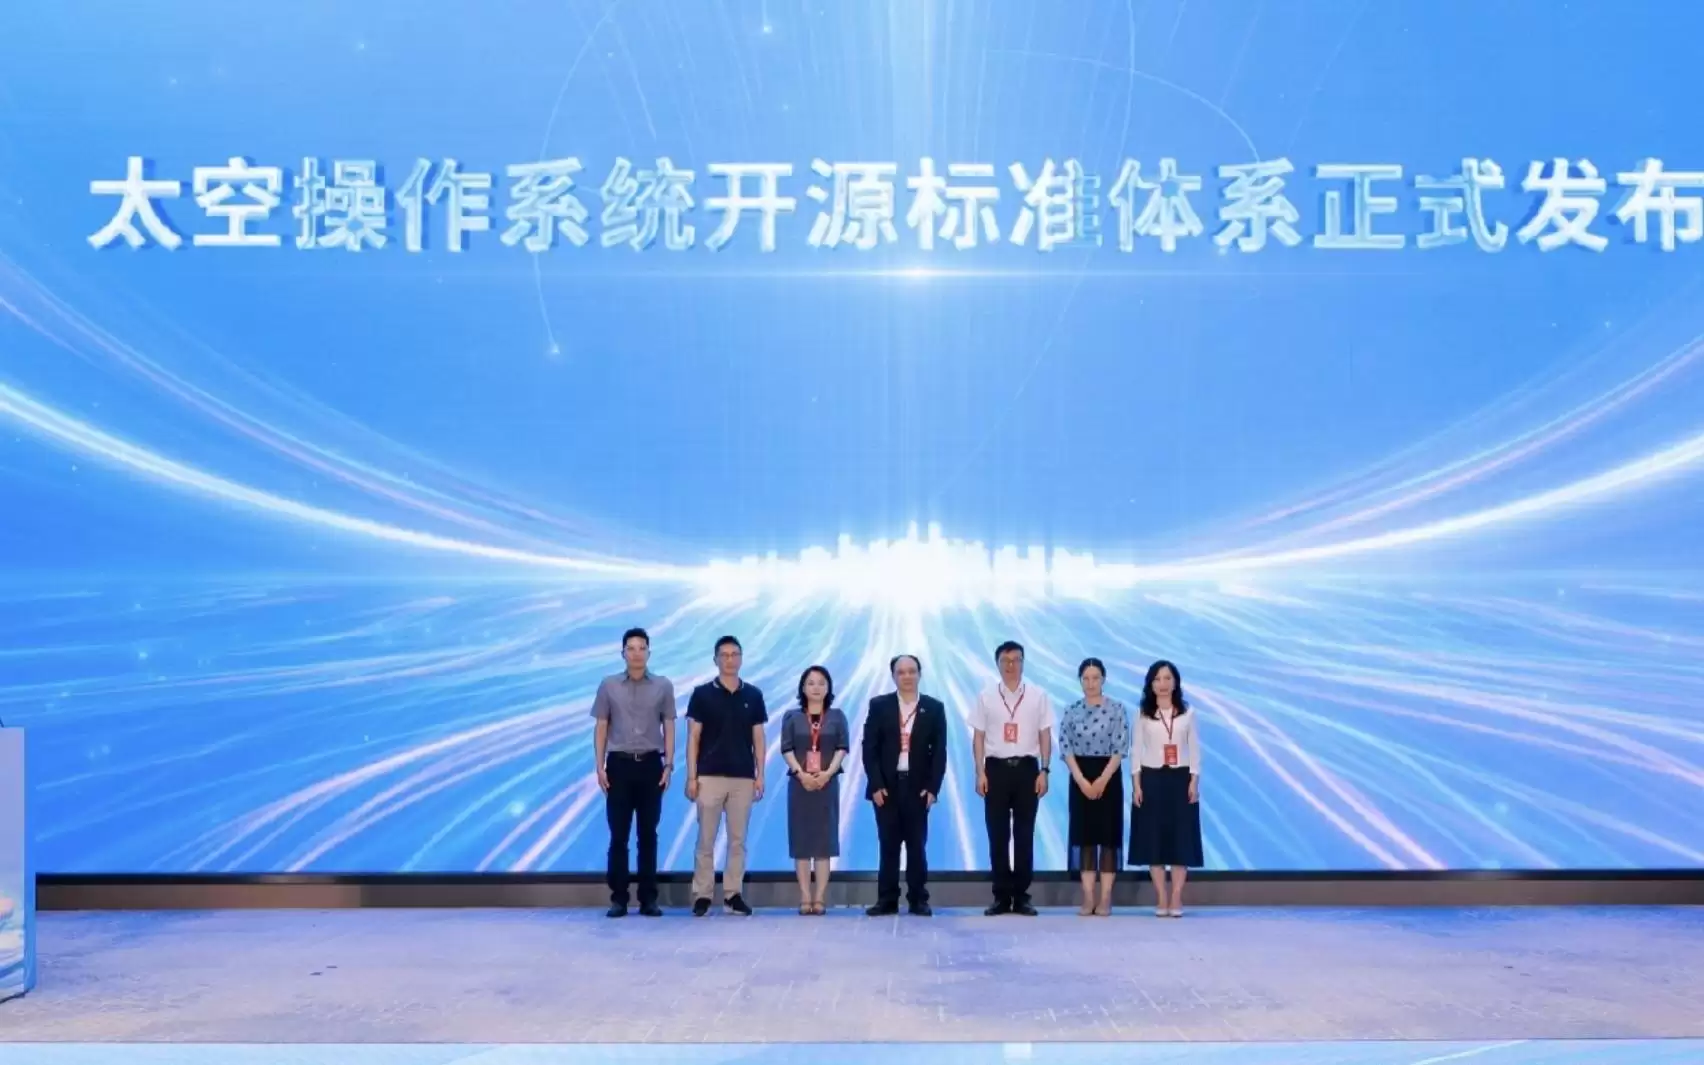
6月29日,2026全球数字经济大会的太空算力论坛在北京海淀举办。这场论坛上,北京太空算力创新中心正式揭牌,同时国内首个太空操作系统开源标准体系也对外亮相。这标志着,我们在太空算力产业的标准化、协同化发展上,迈出了重要一步。活动由全球数字经济大会组委会主办,“北京团队”——市经信局、中关村科学城管委

在Debian系统上配置SSL证书通常涉及以下几个步骤:安装Web服务器:首先,你需要一个Web服务器,比如Apache或Nginx。这里以Apache为例。sudo apt updatesudo apt install apache2获取SSL证书:你可以从Let’s Encrypt免费获取SSL

要想让Python项目在统信UOS上正常运行,得先安装python3、python3-pip、python3-venv、python3-dev以及build-essential等组件。具体操作就是执行sudo apt install命令来一步到位完成安装,同时别忘了配置清华镜像源来给pip加速哦。在
本文首发于 NebulaGraph 公众号NebulaGraph VEditor 是一个拥有高性能、高可定制的所见即所得图可视化编辑器前端库。NebulaGraph VEditor 底层基于 SVG 绘图,它通过合理抽象代码结构以易于二次开发和自定义绘制,极适用于审批流,工作流,血缘关系,ETL 处

李志信 (GitHubID LaurenceLiZhixin),中山大学软件工程专业在校学生,擅长使用 Ja va/Go 语言,专注于云原生和微服务等技术方向。3月19日,初春的杭州,依旧阴雨朦胧。透过 EFC 健身房的落地窗往外看,远处的楼宇、青山、整齐的街道和稀疏的车辆在水雾中若隐若现。午后的小

今日,StreamNative宣布发布并开源首版AWS Simple Queue Service (SQS) connector[1],这着实令人振奋!借助SQS connector,您能够毫不费力地在Pulsar与SQS之间实现数据的流动,进而充分发挥这两种消息系统各自的优势。可以说,这是Stre






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
