

使用Python轻松获取Word文本框中的文字和图片
使用Python的Spire.Doc库可通过遍历文本框对象模型,提取其中的段落文字、表格数据及图片。通过判断子对象类型,读取文字或表格单元格内容,利用ImageBytes属性导出图片。该方法支持嵌套文本框和编码处理,适用于文档自动化迁移与归档。
Word文档里的文本框,是个挺实用的设计——它能把独立的文字段落、表格甚至图片都“打包”起来,放在文档的任意位置。但在实际工作中,比如做文档迁移、数据归档或者批量处理时,经常会遇到一个需求:怎么把这些藏在文本框里的文字和图片“捞”出来?和正文不一样,文本框里的内容并不在文档主段落流里,得通过专门的文档对象模型去遍历和访问。下面就来聊聊,怎么用Python把Word文本框里的文字、表格数据和嵌入的图片,系统性地提取出来。
环境准备
这次我们用到的工具是Spire.Doc for Python。这个库提供了完整的文档对象模型,能很方便地遍历文本框里的子对象,然后按类型分别处理。安装命令很简单:
pip install Spire.Doc
装好之后,在脚本里导入需要的模块就能开工了。
from spire.doc import *
from spire.doc.common import *
遍历文本框并提取文字
在Spire.Doc的对象模型里,文本框对应的是TextBox类型。它的内部内容通过Body属性暴露出来,结构和文档主体很像。文本框里可能既包含段落,也可能嵌套表格,所以需要遍历ChildObjects集合,然后根据每个子对象的DocumentObjectType来判断该走哪条路。这种逐层遍历的方法,能确保不遗漏任何嵌套结构里的文字。
from spire.doc import *
from spire.doc.common import *

inputFile = "/文本框.docx"
outputFile = "ExtractedText.txt"

# 加载文档
document = Document()
document.LoadFromFile(inputFile)

# 检查文档中是否包含文本框
if document.TextBoxes.Count > 0:
    with open(outputFile, 'w', encoding='utf-8') as sw:
        for i in range(document.TextBoxes.Count):
            textbox = document.TextBoxes.get_Item(i)
            # 遍历文本框内的子对象
            for j in range(textbox.Body.ChildObjects.Count):
                obj = textbox.Body.ChildObjects.get_Item(j)
                # 提取段落文字
                if obj.DocumentObjectType == DocumentObjectType.Paragraph:
                    para = obj if isinstance(obj, Paragraph) else None
                    sw.write(para.Text + "n")
                # 提取表格中的文字
                if obj.DocumentObjectType == DocumentObjectType.Table:
                    table = obj if isinstance(obj, Table) else None
                    for row_idx in range(table.Rows.Count):
                        row = table.Rows[row_idx]
                        for cell_idx in range(row.Cells.Count):
                            cell = row.Cells[cell_idx]
                            for para_idx in range(cell.Paragraphs.Count):
                                para = cell.Paragraphs.get_Item(para_idx)
                                sw.write(para.Text + "t")
                        sw.write("n")

document.Close()
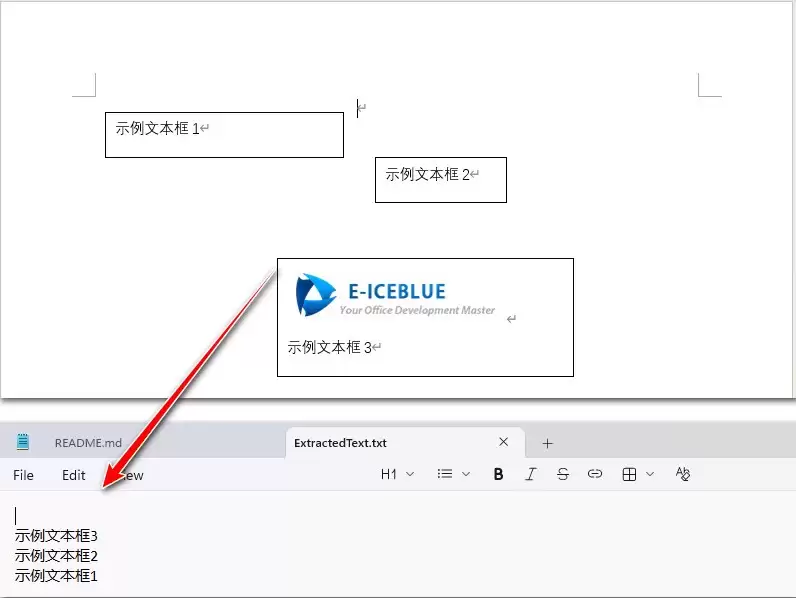
这段代码的逻辑很清晰:先通过document.TextBoxes拿到文档里所有的文本框,然后对每个文本框,用Body.ChildObjects遍历它内部的子对象。碰到Paragraph类型的,直接读Text属性就行;碰到Table类型的,就再往下走一层——遍历表格的行、单元格、单元格里的段落,一个个提取文字。为了让表格结构保留下来,同一行里不同单元格的内容用t制表符隔开,不同行之间用n换行。这样提取出来的文本,后续处理起来就很方便了。
从文本框中读取表格数据
有时候,我们明确知道文本框里装的就是一个表格,而且希望用更结构化的方式去读它。这时候,可以直接通过Body.Tables集合来访问,不用再绕路去遍历ChildObjects。这种方法更直接,适合对文本框内部结构比较熟悉的场景。
from spire.doc import *
from spire.doc.common import *

inputFile = "./Data/TextBoxTable.docx"
outputFile = "TableFromTextBox.txt"

# 加载文档
doc = Document()
doc.LoadFromFile(inputFile)

# 获取第一个文本框
textbox = doc.TextBoxes[0]

# 获取文本框中的第一个表格
table = textbox.Body.Tables[0] if isinstance(textbox.Body.Tables[0], Table) else None

result = ""
for i in range(table.Rows.Count):
    row = table.Rows.get_Item(i)
    for j in range(row.Cells.Count):
        cell = row.Cells.get_Item(j)
        for k in range(cell.Paragraphs.Count):
            paragraph = cell.Paragraphs.get_Item(k)
            result += paragraph.Text + "t"
    result += "n"

with open(outputFile, 'w', encoding='utf-8') as fp:
    fp.write(result)

doc.Close()
这段代码更简短:直接通过doc.TextBoxes[0]拿到第一个文本框,然后通过textbox.Body.Tables[0]拿到它里面的第一个表格。之后按行→单元格→段落的层次结构遍历,把每个单元格的文字拼出来。如果你的表格位置是固定的,这种写法能省下不少遍历开销。
提取文本框中的图片
文本框里的图片,在Spire.Doc里是以DocPicture对象来表示的,它的ImageBytes属性里存着图片的二进制数据。提取图片的思路和提取文字差不多:遍历文本框的子对象,一旦发现类型是Picture的,就读取它的ImageBytes,然后写入文件。不过有个细节要注意——图片通常嵌套在段落里面,所以需要递归遍历所有层级的子对象。
from spire.doc import *
from spire.doc.common import *
import os

inputFile = "./Data/TextBoxWithImages.docx"
outputDir = "ExtractedImages/"

if not os.path.exists(outputDir):
    os.makedirs(outputDir)

# 加载文档
document = Document()
document.LoadFromFile(inputFile)

image_index = 0

# 遍历所有文本框
for i in range(document.TextBoxes.Count):
    textbox = document.TextBoxes.get_Item(i)
    # 遍历文本框中的子对象
    for j in range(textbox.Body.ChildObjects.Count):
        obj = textbox.Body.ChildObjects.get_Item(j)
        # 检查是否为段落,图片通常嵌套在段落中
        if obj.DocumentObjectType == DocumentObjectType.Paragraph:
            para = obj if isinstance(obj, Paragraph) else None
            for k in range(para.ChildObjects.Count):
                child = para.ChildObjects.get_Item(k)
                if child.DocumentObjectType == DocumentObjectType.Picture:
                    picture = child if isinstance(child, DocPicture) else None
                    # 获取图片二进制数据并保存
                    image_bytes = picture.ImageBytes
                    image_path = os.path.join(outputDir, f"Image-{image_index}.png")
                    with open(image_path, 'wb') as img_file:
                        img_file.write(image_bytes)
                    image_index += 1
                    print(f"已保存图片: {image_path}")

document.Close()
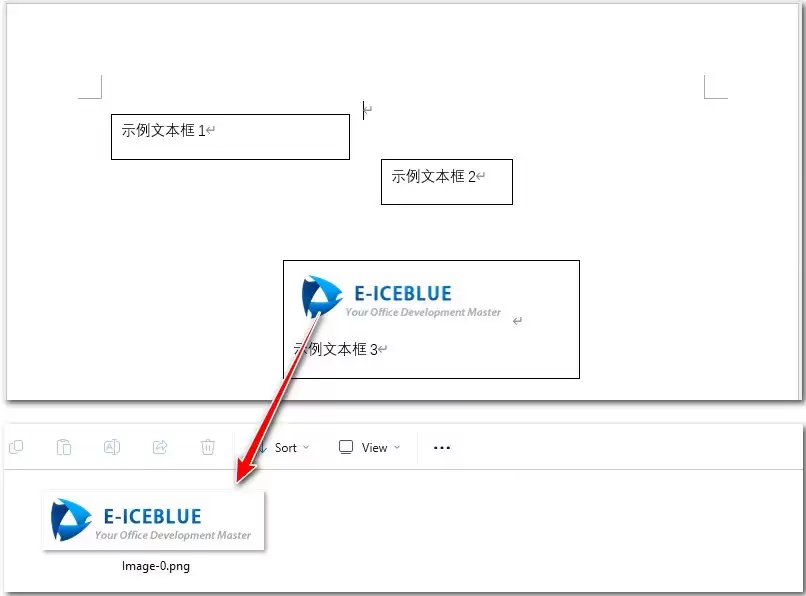
这段代码遍历了文档里所有的文本框。对每个文本框里的每个段落,再进一步遍历段落的ChildObjects集合。一旦发现子对象类型是Picture,就把它转成DocPicture对象,通过ImageBytes拿到原始图片字节流,然后以PNG格式写入文件。ImageBytes返回的是原始图片的字节数据,默认以PNG格式保存;如果原始图片是JPEG或其他格式,你可以根据实际需求修改文件扩展名。每个图片文件用序号命名,避免重名冲突。
实用技巧
同时提取文字和图片
实际应用中,文本框里经常是文字和图片混在一起的。可以把文字和图片的提取逻辑整合到一个遍历流程里:外层遍历到段落时,既提取段落文字,又检查段落里有没有图片子对象。这样一次遍历就能搞定所有内容,效率更高。
处理嵌套文本框
Word文档支持文本框嵌套,就是一个文本框里可能还藏着另一个文本框。如果在提取过程中遇到了DocumentObjectType.TextBox类型的子对象,就需要对它的Body做递归遍历,保证所有层级的内容都能被提取到。写一个递归函数来处理这个逻辑,是个不错的选择。
编码与换行处理
提取的文字写入文件时,强烈建议统一使用UTF-8编码(encoding='utf-8'),避免中文等非ASCII字符出现乱码。另外,不同操作系统对换行符的处理方式不一样——Windows用\r\n,Linux/macOS用\n。如果需要在特定平台上正确显示,可以针对性地调整换行符格式。
总结
这篇文章介绍了如何用Python结合Spire.Doc库,从Word文档的文本框中提取文字和图片。通过遍历文本框对象,结合文档结构,可以识别并读取其中的段落、表格等文本内容;同时,利用图片对象的ImageBytes属性,可以实现文本框内图片的导出。此外,还顺带聊了嵌套文本框、编码处理、换行符解析等常见场景的处理方法。虽然文本框里的内容不属于文档正文流,但借助Spire.Doc提供的对象模型,仍然可以灵活地访问和提取它们。掌握这些方法后,就能进一步应用到Word文档归档、数据迁移、内容分析以及批量文档处理等自动化场景中。
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
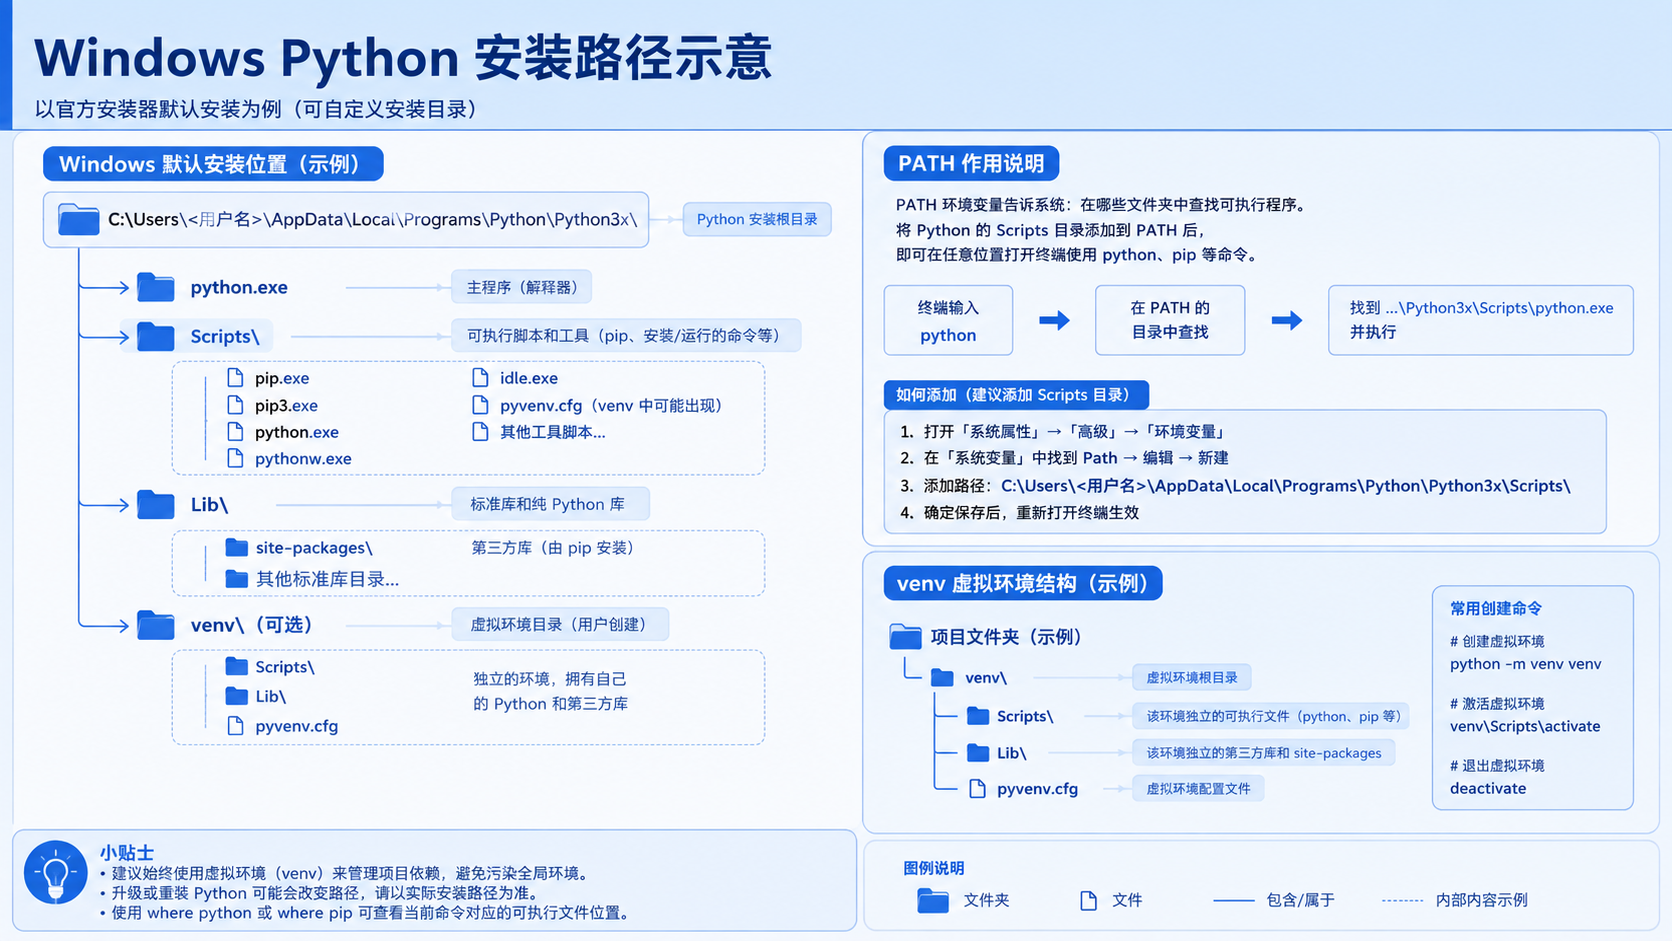
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
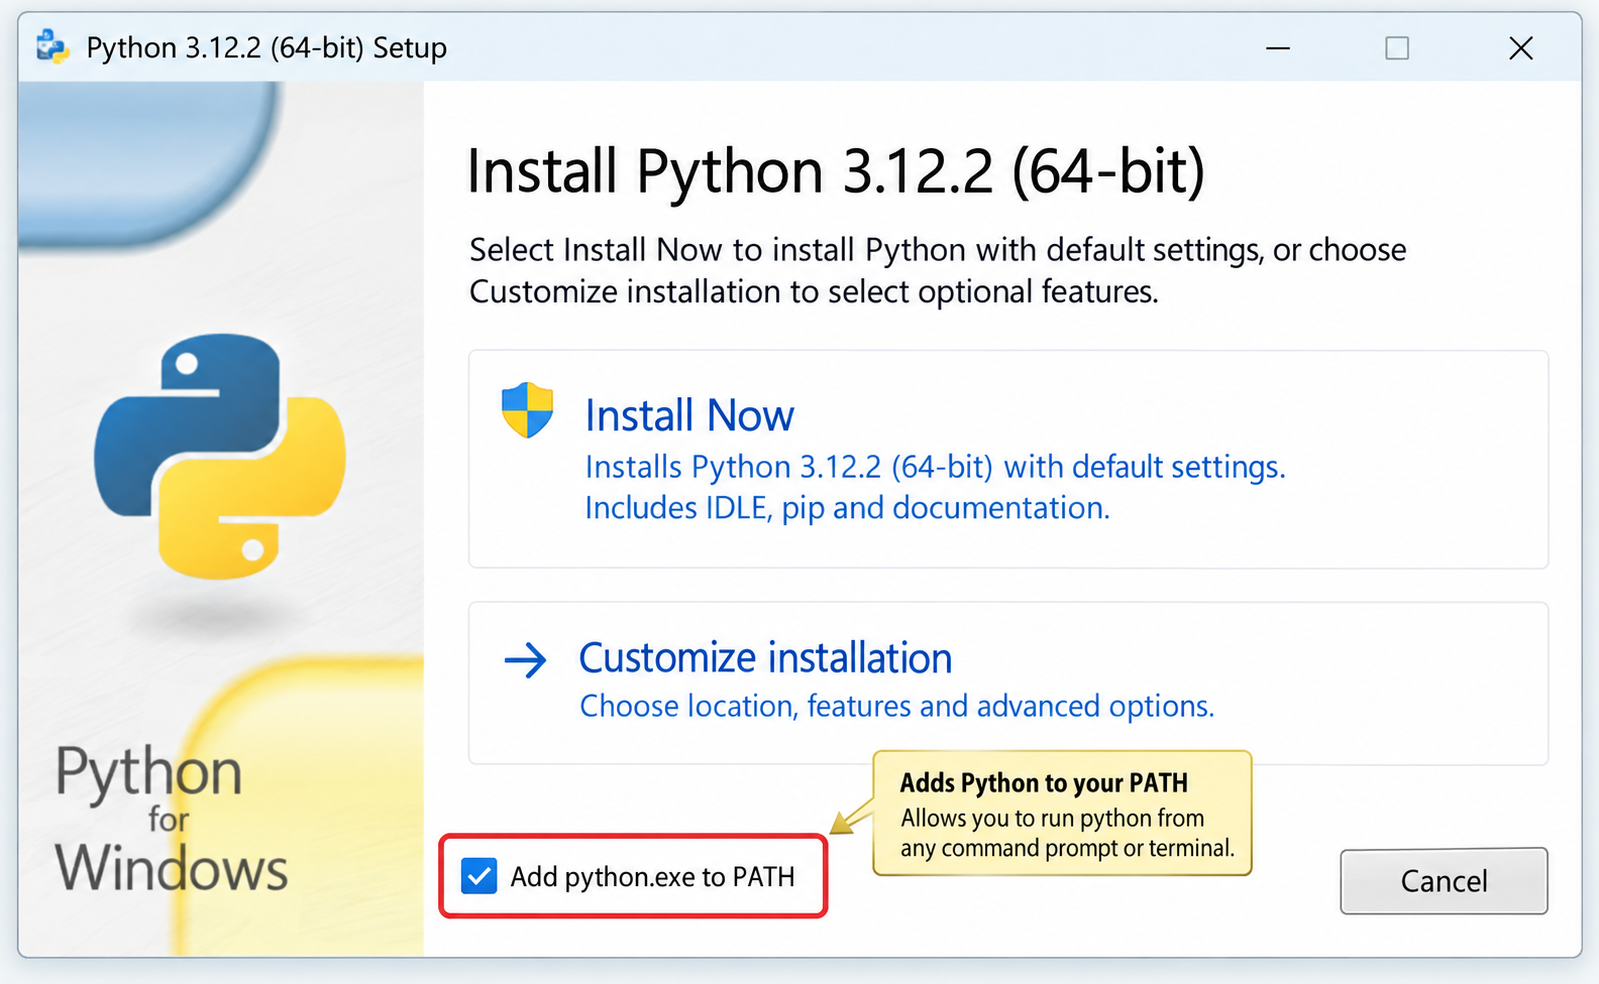
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
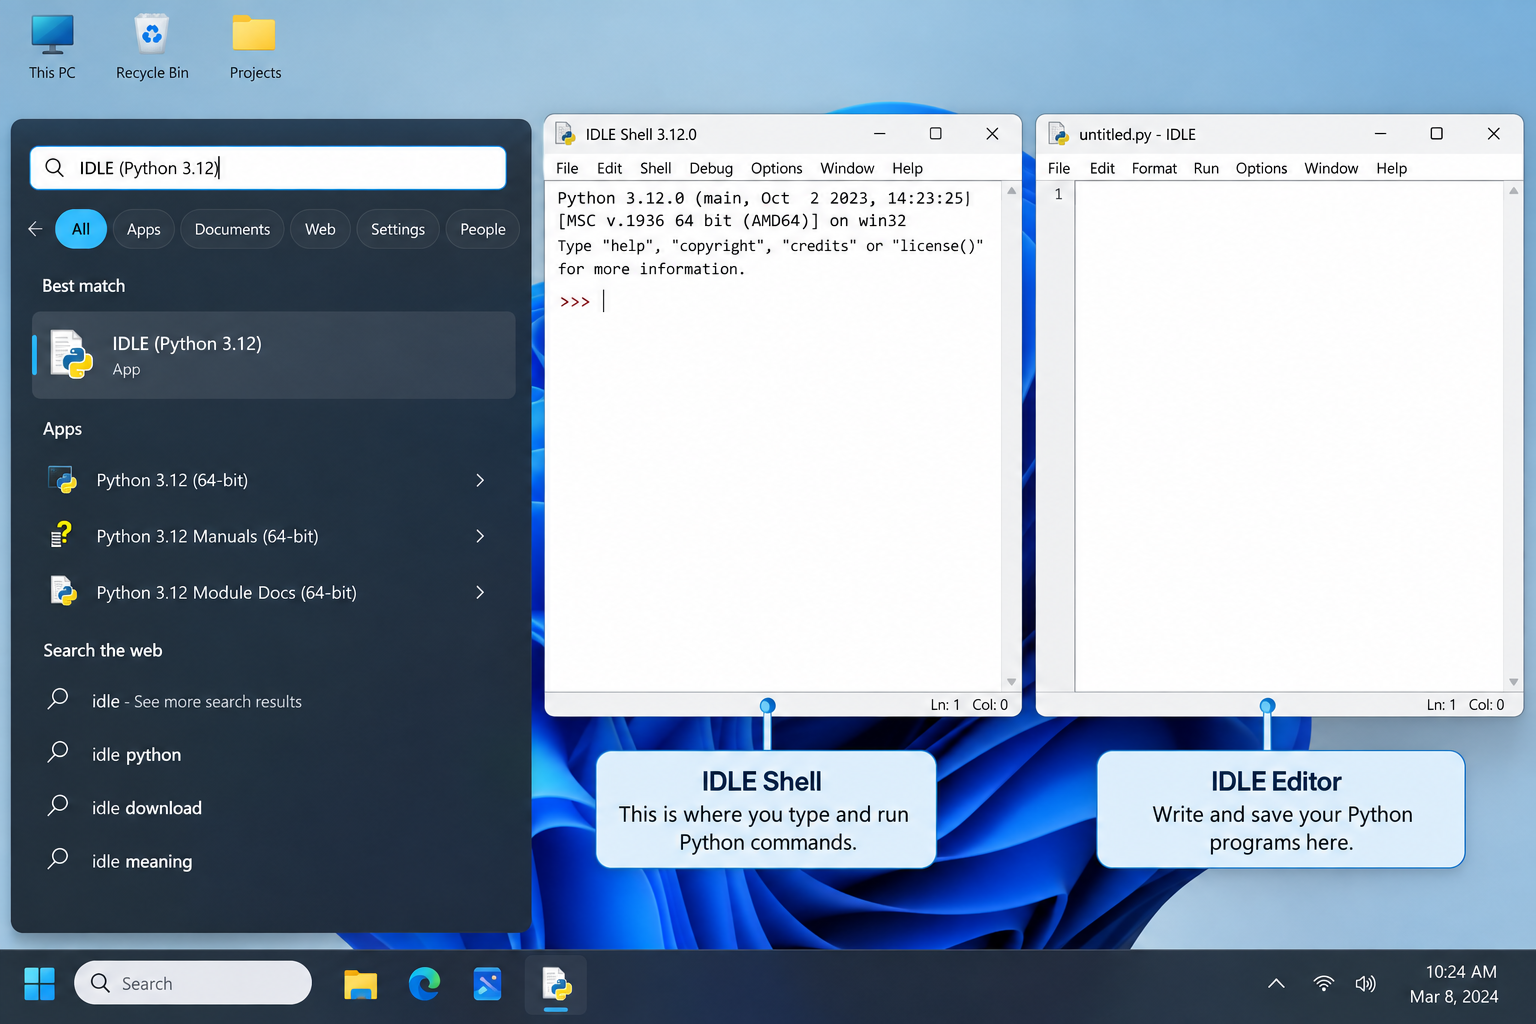
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
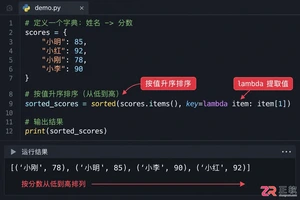
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
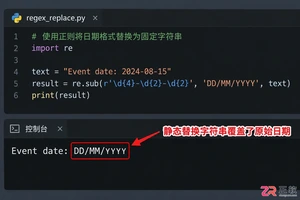
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。



IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。
JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。
JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。
JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,
PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,
PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


