

两周前刚说CUDA神话松动,SemiAnalysis转头点赞英伟达vLLM——AMD追赶的不只是硬件
SemiAnalysis先指出英伟达CUDA护城河遭侵蚀,后又点赞其vLLM推理性能,认为AMD在部分模型支持上仍有差距。推理时代软件生态深度比硬件更关键,英伟达在推理软件栈的积累正成为持久竞争壁垒。
7月13日,半导体研究机构SemiAnalysis在社交平台发布了一则推文,对英伟达在vLLM推理引擎上的性能优化给予了高度评价,同时也毫不客气地指出,AMD在部分模型的vLLM支持上,还有不小的追赶空间。
就在两周前,华尔街见闻还报道过,该机构曾指出英伟达的“CUDA护城河正遭缓慢侵蚀”,最大的竞争压力来自越来越多超大规模云厂商和AI模型公司开始自研ASIC,针对训练或推理等特定场景构建专用芯片体系。
这一前一后两个判断,把AI芯片竞争的焦点从“谁的硬件更强”拉回到一个更根本的问题:在推理时代的规模化部署中,软件生态的深度,可能比单代GPU的硬件领先更具决定性。
每天运行数十亿次推理调用的AI企业,最清楚“部分模型支持良好”和“所有模型稳定优化”之间的差距有多大。规模效应下,这可不是数字游戏,而是实打实的成本差距。
在硬件竞争日趋白热化、自研ASIC不断蚕食推理份额的背景下,英伟达在推理软件栈上的积累深度,正在成为比硬件参数更持久的竞争壁垒。
vLLM的差距,说白了就是生态闭环的差距
vLLM,是当前大语言模型推理领域应用最广泛的开源引擎,没有之一。
SemiAnalysis选择vLLM作为评判基准,这个动作本身就在传递一个判断:开源推理生态,正在成为衡量AI芯片真实性能的关键战场。
以Kimi K2.5这一千亿参数级的混合专家(MoE)模型为例,差距就非常明显了。
英伟达的GB200 NVL72,通过机架级NVLink将72张GPU高速互联,支持宽专家并行(Wide EP)达到8到16的规模。这个架构的好处是,每张GPU承载的专家权重大幅减少,HBM带宽压力随之降低,All-to-All通信也都在高速NVLink域内完成,不用经过较慢的InfiniBand网络。
最终,每GPU吞吐量能做到12,000 token/s以上。相比之下,AMD的MI355X在同一测试中明显逊色,主要原因就在于难以实现同等规模的专家并行与机架级互联。
软件层面,英伟达推出的Dynamo分布式推理框架,把vLLM深度集成进来,专门针对MoE模型实现了预填充与解码分离(Disaggregated Serving)、高效KV缓存传输以及双批次重叠等优化。这套框架在NVL72上能把硬件潜力发挥到极致。而AMD这边,目前主要还是依赖标准vLLM与DISAGG版本,针对超大MoE模型与宽并行场景的深度优化,还没有跟上。
“部分模型”这个措辞背后的全覆盖鸿沟
SemiAnalysis把AMD的落后限定在“部分模型”上,这个措辞很有意思,包含两层信息。
第一,AMD并非全面落后。在通用计算场景中,其MI系列GPU已经具备一定竞争力,Meta近期签署的巨额采购订单,就是最好的证明。
第二,“部分”这个限定,恰恰凸显了当前差距的实质——全面性软件生态覆盖的缺失。
在AI推理场景中,企业客户追求的是什么?是稳定、可预期的部署体验。维护两套软件栈来覆盖不同模型,这个成本在决策时往往是决定性的因素。
AMD要完成从“部分领先”到“全面可用”的跨越,所需的软件工程投入,可能比硬件迭代更耗时。这不仅仅是写更多驱动和适配层的问题,它意味着要在数以千计的模型架构、不断演进的开源框架、以及分散的开发者社区中,建立广泛的兼容性和信任。这可不是一朝一夕的事。
推理时代,软件才是真正的护城河
当AI产业重心从训练向推理迁移,软硬件的战略价值正在发生结构性重估。
训练任务集中、可控,硬件性能差距可以靠资本投入来弥补;但推理是分布式、持续性的,微秒级的延迟差异,在每天数十亿次调用中被成倍放大,直接转化为成本结构的分化。
英伟达的软件生态壁垒,由三个层面叠加构成:
覆盖约400万开发者的CUDA工具链及其二十年积累;对所有主流机器学习框架的优先适配;以及cuDNN、TensorRT、NCCL等优化库形成的深度绑定。
三者叠加产生的迁移成本,远超任何单一硬件参数的差距。这个判断,跟SemiAnalysis两周前的分析形成呼应——当时他们指出,Anthropic已经形成了由谷歌TPU、亚马逊Trainium和英伟达GPU共同构成的多平台算力架构,大量Claude模型训练运行于TPU,Claude Code推理则越来越多部署于Trainium,英伟达GPU的份额正被自研ASIC缓慢侵蚀。
但这次对vLLM性能的正面评价表明,英伟达在推理软件栈深度优化上的领先幅度,并没有随着硬件竞争格局的演变而同步收窄。换句话说,硬件上的仗还没打完,软件上的差距,可能才是更让人头疼的。
1. 从一次典型的“CUDA不可用”报错说起 在Conda创建的PyTorch虚拟环境里跑深度学习代码,十有八九会遇到那个让人血压飙升的错误:RuntimeError: CUDA error: no kernel image is available for execution on the dev
在实际操作中,用QLoRA+PEFT微调大模型时,因CUDA上下文丢失触发的设备断言错误,是不少人都踩过的坑。下面这份排查与修复方案,希望能帮你一次性解决它。 在实际工作中,用QLoRA对Gemma、Llama、Qwen这类大模型做高效微调时,可能会遇到一个颇具迷惑性的报错: RuntimeErro
升级pip至24.0及以上版本,即可自动解决PyTorchCUDA版wheel重复下载问题,缓存机制自动生效,无需任何手动配置,多环境安装时效率显著提升,避免反复下载同一文件。
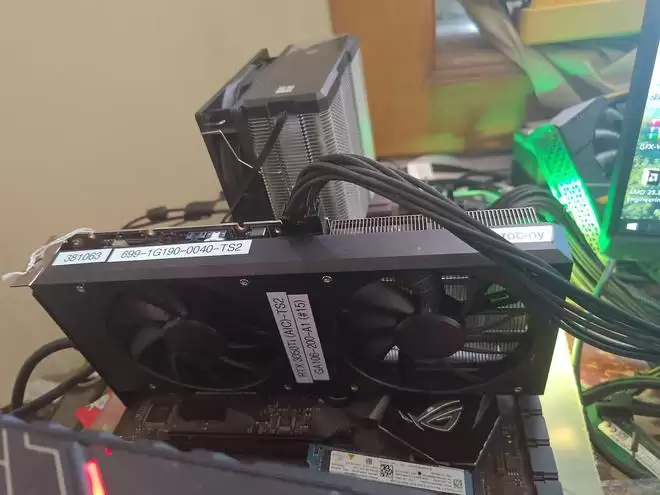
最近,有消息人士在社交平台上放出了一组实物照片和测试数据,主角是一款从未正式推向市场的桌面显卡——NVIDIA GeForce RTX 3050 Ti。说实话,这块卡在RTX 30系产品线里一直是个“只闻其声不见其人”的角色,如今终于露出真容,倒是很有意思。 ▲ 图源:@白给的盖欧卡 从照片和识别信
QLoRA微调Gemma模型时CUDA设备断言失败的完整解决方案 本文详解QLoRA+PEFT微调Gemma等大模型时,因CUDA上下文未正确初始化导致的device >= 0 && device < num_gpus断言错误,提供从环境重置、配置修正到稳健训练的全流程避坑指南。 如果你正在使用QL
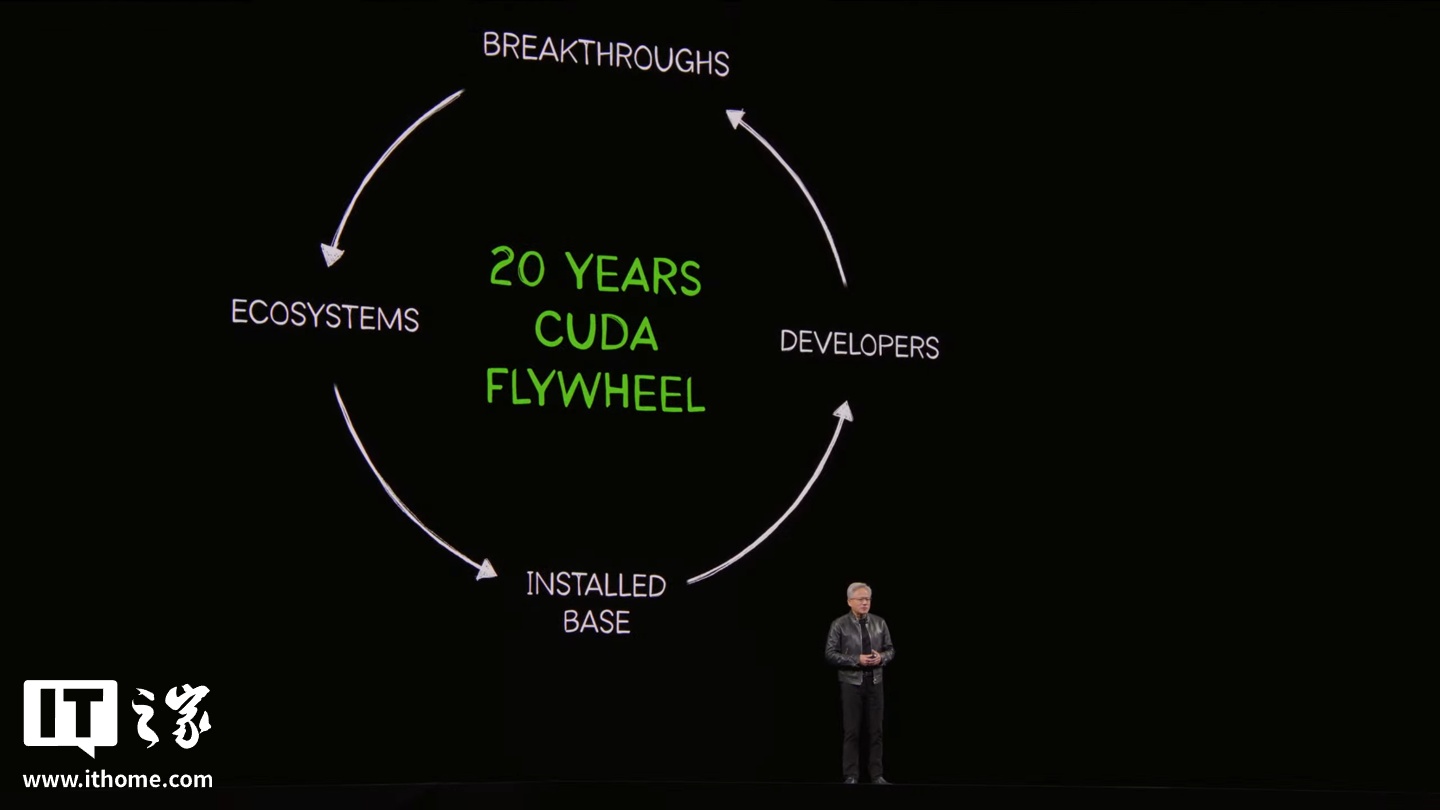
Token:新AI时代的基础构建单元 GPU技术大会(GTC)于3月17日在美国圣何塞正式开幕,英伟达首席执行官黄仁勋在主题演讲中抛出一个重要论断:当下AI时代最基础的构建单元,既不是算法也不是算力,而是看似微小的"Token"(词元)。这一观点为整个行业提供了全新的认知视角。 站在CUDA架构诞生
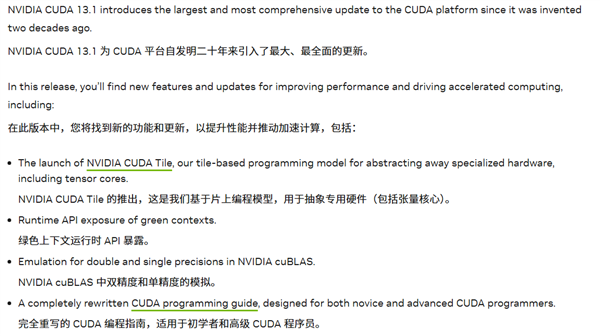
12月7日快讯,NVIDIA近日正式发布CUDA13.1版本,官方宣称这是自2006年CUDA平台问世以来规模最宏大、覆盖最广泛的升级。本次更新最具突破性的特性,是首次引入划时代的CUDATile编程范式,标志着GPU开发正迈向更高层级的抽象化新纪元。长期以来,GPU编程普遍采用SIMT(单指令多线程)架构,开发者需深度介入线程管理、内存访问策略及同步机制等底层细节。而CUDATile则以tile(即数据块或瓦片)为核心单元进行建模,开发者只需聚焦于如何划分数据块并定义其上的计算逻辑,至于线程分发、
无需任何修改转换,AMD显卡也跑起原版CUDA程序了!英国一家初创公司,推出了针对AMD的CUDA程序编译工具,而且免费商用。工具一经发布就引发了网友们的广泛热议,并登顶了HackerNews热榜。该工具名为SCALE,开发者给它的定位是一个GPGPU(通用GPU)编程工具包。目前已有大模型框架llama-cpp等9个程序通过测试,实现了正常运行。与其他实现方式不同,SCALE直接模拟CUDA工具包的安装,不需要转换成其他语言就能源到源地完成编译。因此,像内联PTX这种英伟达专用的中间语言,SCALE同样
本站3月6日消息,近日,网络上出现了对于英伟达CUDA(并行计算平台)兼容相关的报道,被认为是“禁止第三方公司兼容CUDA”。据外媒Tom'sHardware报道,英伟达CUDA11.6及更高版本的EULA(最终用户许可协议)中的某条款提到,“您不能逆向工程、反编译或反汇编使用此SDK生成的任何结果,并在非英伟达平台上进行转译。”对此,国产GPU厂商摩尔线程官方发布声明,表示其MUSA/MUSIFY不涉及英伟达EULA相关条款,开发者可放心使用。摩尔线程表示,MUSA是摩尔线程自主研发、拥有全部知识产权、






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



