

Python实现的循环神经网络算法示例
最近几年,深度学习已经成为人工智能领域的热门话题。在深度学习的技术栈中,循环神经网络(RecurrentNeuralNetworks,简称RNN)是一种非常重要的算法。Python是人工智能领域中非常流行的编程语言,Python的深度学习库TensorFlow也提供了丰富的RNN算法实现。本篇文章将介绍Python中的循环神经网络算法,并给出一个实际的应
最近几年,深度学习已经成为人工智能领域的热门话题。在深度学习的技术栈中,循环神经网络(Recurrent Neural Networks,简称RNN)是一种非常重要的算法。Python是人工智能领域中非常流行的编程语言,Python的深度学习库TensorFlow也提供了丰富的RNN算法实现。本篇文章将介绍Python中的循环神经网络算法,并给出一个实际的应用实例。
一、 循环神经网络简介
循环神经网络(Recurrent Neural Networks,简称RNN)是一种能够处理序列数据的人工神经网络。与传统神经网络不同,RNN能够利用之前的信息来帮助理解当前的输入数据。这种“记忆机制”使RNN在处理语言、时间序列和视频等序列数据时非常有效。
循环神经网络的核心是它的循环结构。在时间序列中,每个时间点上的输入不仅会影响当前的输出,还会影响下一个时间点的输出。RNN通过将当前时间点的输出与上一个时间点的输出结合起来,实现了记忆机制。在训练过程中,RNN自动地学习如何保存历史信息,并利用它们来指导当前的决策。
二、 Python中的循环神经网络算法实现
在Python中,实现RNN算法的最流行的深度学习框架是TensorFlow。TensorFlow为用户提供了各种RNN算法模型,包括基本的RNN、LSTM(长短时记忆网络)和GRU(门控循环单元)等。
下面,我们来看一个基于TensorFlow实现的循环神经网络实例。
我们将使用一个文本生成任务来演示循环神经网络的应用。我们的目标是利用已知的训练文本生成新的的文本。
首先,我们需要准备训练数据。在这个例子中,我们将使用莎士比亚的《哈姆雷特》作为我们的训练文本。我们需要将文本进行预处理,将所有的字符转换为缩写字符集,并将它们转换为数字。
接下来,我们需要构建一个循环神经网络模型。我们将使用LSTM模型。下面是代码的实现:
import tensorflow as tf

#定义超参数
num_epochs = 50
batch_size = 50
learning_rate = 0.01

#读取训练数据
data = open('shakespeare.txt', 'r').read()
chars = list(set(data))
data_size, vocab_size = len(data), len(chars)
char_to_ix = { ch:i for i,ch in enumerate(chars) }
ix_to_char = { i:ch for i,ch in enumerate(chars) }

#定义模型架构
inputs = tf.placeholder(tf.int32, shape=[None, None], name='inputs')
targets = tf.placeholder(tf.int32, shape=[None, None], name='targets')
keep_prob = tf.placeholder(tf.float32, shape=[], name='keep_prob')

#定义LSTM层
lstm_cell = tf.contrib.rnn.BasicLSTMCell(num_units=512)
dropout_cell = tf.contrib.rnn.DropoutWrapper(cell=lstm_cell, output_keep_prob=keep_prob)
outputs, final_state = tf.nn.dynamic_rnn(dropout_cell, inputs, dtype=tf.float32)

#定义输出层
logits = tf.contrib.layers.fully_connected(outputs, num_outputs=vocab_size, activation_fn=None)
predictions = tf.nn.softmax(logits)

#定义损失函数和优化器
loss = tf.reduce_mean(tf.nn.sparse_softmax_cross_entropy_with_logits(logits=logits, labels=targets))
optimizer = tf.train.AdamOptimizer(learning_rate).minimize(loss)
在这个模型中,我们使用了一个单层的LSTM神经网络,并定义了一个dropout层来防止模型出现过拟合。输出层采用全连接层,并使用softmax函数来对生成的文本进行归一化处理。
在训练模型前,我们还需要实现一些辅助函数。比如一个用于生成随机的样本序列的函数,以及一个用于将数字转换回字符的函数。下面是代码的实现:
import random

#生成序列数据样本
def sample_data(data, batch_size, seq_length):
    num_batches = len(data) // (batch_size * seq_length)
    data = data[:num_batches * batch_size * seq_length]
    x_data = np.array(data)
    y_data = np.copy(x_data)
    y_data[:-1] = x_data[1:]
    y_data[-1] = x_data[0]
    x_batches = np.split(x_data.reshape(batch_size, -1), num_batches, axis=1)
    y_batches = np.split(y_data.reshape(batch_size, -1), num_batches, axis=1)
    return x_batches, y_batches

#将数字转换回字符
def to_char(num):
    return ix_to_char[num]
有了这些辅助函数后,我们就可以开始训练模型了。在训练过程中,我们将训练的数据按照batch_size和seq_length分成小块,并分批送入模型进行训练。下面是代码实现:
import numpy as np

#启动会话
with tf.Session() as sess:
    sess.run(tf.global_variables_initializer())

    #开始训练模型
    for epoch in range(num_epochs):
        epoch_loss = 0
        x_batches, y_batches = sample_data(data, batch_size, seq_length)

        for x_batch, y_batch in zip(x_batches, y_batches):
            inputs_, targets_ = np.array(x_batch), np.array(y_batch)
            inputs_ = np.eye(vocab_size)[inputs_]
            targets_ = np.eye(vocab_size)[targets_]
            last_state, _ = sess.run([final_state, optimizer],
                                     feed_dict={inputs:inputs_, targets:targets_, keep_prob:0.5})
            epoch_loss += loss.eval(feed_dict={inputs:inputs_, targets:targets_, keep_prob:1.0})

        #在每个epoch结束时输出损失函数
        print('Epoch {:2d} loss {:3.4f}'.format(epoch+1, epoch_loss))

        #生成新的文本
        start_index = random.randint(0, len(data) - seq_length)
        sample_seq = data[start_index:start_index+seq_length]
        text = sample_seq
        for _ in range(500):
            x_input = np.array([char_to_ix[ch] for ch in text[-seq_length:]])
            x_input = np.eye(vocab_size)[x_input]
            prediction = sess.run(predictions, feed_dict={inputs:np.expand_dims(x_input, 0), keep_prob:1.0})
            prediction = np.argmax(prediction, axis=2)[0]
            text += to_char(prediction[-1])

        print(text)
三、 结论
循环神经网络通过结合当前输入和先前信息的方法,使得可以在处理序列数据时更加准确和高效。在Python中,我们可以使用TensorFlow库中提供的RNN算法,来很方便地实现循环神经网络算法。本文提供了一个基于LSTM的Python实现例子,可以将这种算法应用于文本生成任务之中。
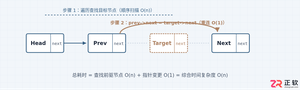
详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。
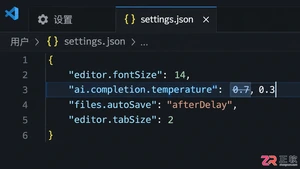
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。