

用Scrapy进行数据分析:爬取特定游戏论坛信息
近年来,使用Python进行数据挖掘和分析越来越普遍。在爬取网站数据方面,Scrapy是一个受欢迎的工具。在本篇文章中,我们将介绍如何使用Scrapy爬取某个游戏论坛的数据,用于后续的数据分析。一、选取目标首先,我们需要选取一个目标网站。在这里,我们选择的是某个游戏论坛。如下图所示,此论坛包含了各种资源,如游戏攻略、游戏下载、玩家交流等。我们的目标是获取其中
近年来,使用Python进行数据挖掘和分析越来越普遍。在爬取网站数据方面,Scrapy是一个受欢迎的工具。在本篇文章中,我们将介绍如何使用Scrapy爬取某个游戏论坛的数据,用于后续的数据分析。
一、选取目标
首先,我们需要选取一个目标网站。在这里,我们选择的是某个游戏论坛。
如下图所示,此论坛包含了各种资源,如游戏攻略、游戏下载、玩家交流等。
我们的目标是获取其中的帖子标题、作者、发布时间、回复数等信息,以便后续数据分析。
二、创建Scrapy项目
在开始爬取数据之前,我们需要创建一个Scrapy项目。在命令行中,输入以下命令:
scrapy startproject forum_spider
这将创建一个名为“forum_spider”的新项目。
三、配置Scrapy设置
在settings.py文件中,我们需要配置一些设置来确保Scrapy可以顺利地从论坛网站中爬取所需的数据。以下是一些常用的设置:
BOT_NAME = 'forum_spider'

SPIDER_MODULES = ['forum_spider.spiders']
NEWSPIDER_MODULE = 'forum_spider.spiders'

ROBOTSTXT_OBEY = False # 忽略robots.txt文件
DOWNLOAD_DELAY = 1 # 下载延迟
COOKIES_ENABLED = False # 关闭cookies
四、编写Spider
在Scrapy中,Spider是用于执行实际工作(即抓取网站)的类。我们需要定义一个Spider以便从论坛中获取所需的数据。
我们可以使用Scrapy的Shell来测试和调试我们的Spider。在命令行中,输入以下命令:
scrapy shell "https://forum.example.com"
这将打开与目标论坛的交互式Python shell。
在shell中,我们可以使用以下命令来测试所需的Selector:
response.xpath("xpath_expression").extract()在这里,"xpath_expression"应该是用于选取所需数据的XPath表达式。
例如,下面的代码用于获取论坛中所有的主题帖:
response.xpath("//td[contains(@id, 'td_threadtitle_')]").extract()当我们已经确定好XPath表达式后,我们可以创建一个Spider。
在spiders文件夹中,我们创建一个名为“forum_spider.py”的新文件。以下是Spider的代码:
import scrapy

class ForumSpider(scrapy.Spider):
    name = "forum"
    start_urls = [
        "https://forum.example.com"
    ]

    def parse(self, response):
        for thread in response.xpath("//td[contains(@id, 'td_threadtitle_')]"):
            yield {
                'title': thread.xpath("a[@class='s xst']/text()").extract_first(),
                'author': thread.xpath("a[@class='xw1']/text()").extract_first(),
                'date': thread.xpath("em/span/@title").extract_first(),
                'replies': thread.xpath("a[@class='xi2']/text()").extract_first()
            }
在上述代码中,我们首先定义了Spider的名字为“forum”,并设置一个起始URL。然后,我们定义了parse()方法来处理论坛页面的响应。
在parse()方法中,我们使用XPath表达式来选取我们需要的数据。接着,我们用yield语句将数据生成为一个Python字典并返回。这意味着我们的Spider将会逐个抓取论坛首页中的所有主题帖,并提取所需的数据。
五、运行Spider
在执行Spider之前,我们需要确保Scrapy已经正确地配置。我们可以使用以下命令测试Spider是否正常工作:
scrapy crawl forum
这将启动我们的Spider并在控制台中输出所抓取的数据。
六、数据分析
当我们成功爬取数据后,可以使用一些Python库(如Pandas和Matplotlib)对数据进行分析和可视化。
我们可以先将爬取的数据存储为CSV文件,以便更方便地进行数据分析和处理。
import pandas as pd

df = pd.read_csv("forum_data.csv")
print(df.head())
这将显示CSV文件中前五行数据。
我们可以使用Pandas和Matplotlib等库来对数据进行统计分析和可视化。
以下是一个简单的示例,在该示例中,我们将数据按照发布时间进行分类,并绘制出发表主题帖的总数。
import matplotlib.pyplot as plt
import pandas as pd

df = pd.read_csv("forum_data.csv")

df['date'] = pd.to_datetime(df['date']) #将时间字符串转化为时间对象
df['month'] = df['date'].dt.month

grouped = df.groupby('month')
counts = grouped.size()

counts.plot(kind='bar')
plt.title('Number of Threads by Month')
plt.xlabel('Month')
plt.ylabel('Count')
plt.show()
在上述代码中,我们将发布时间转化为Python的Datetime对象,并根据月份对数据进行了分组。然后,我们使用Matplotlib创建了一个柱状图,以显示每个月发布的主题帖数。
七、总结
本篇文章介绍了如何使用Scrapy爬取某个游戏论坛的数据,并展示了如何使用Python的Pandas和Matplotlib库进行数据分析和可视化。这些工具都是Python在数据分析领域中非常受欢迎的库,可以用于探索和可视化网站数据。
Pandas是Python数据分析的核心工具,安装使用pipinstallpandas,导入为importpandasaspd。创建DataFrame可从字典或CSV文件读取,如pd.DataFrame(data)或pd.read_csv('your_data.csv')。数据选择可通过列名或条件过滤实现,如df['姓名']或df[df['年龄']>=28]。数据清洗包括填充缺失值fillna()、删除缺失值dropna()和去重drop_duplicates()。类型转换用astype()函数,应
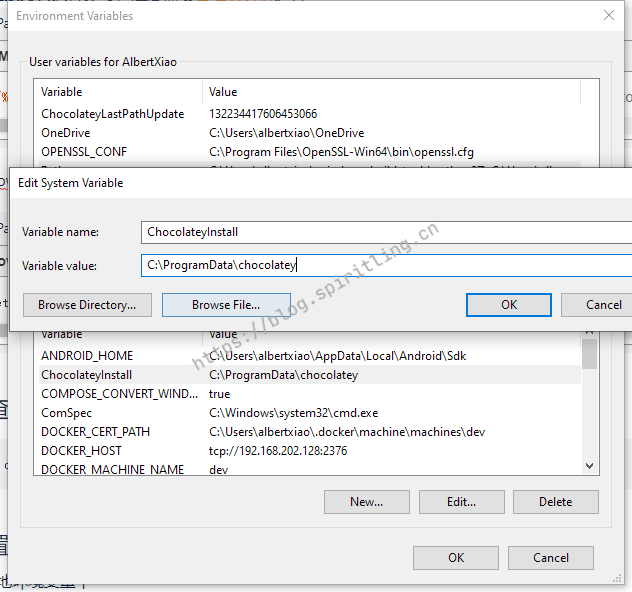
原文链接:https://blog.spiritling.cn/posts/4cb12659/Choco命令行安装直接拷贝执行即可,注意需要管理员身份运行cmd安装:代码语言:javascript代码运行次数:0运行复制@"%SystemRoot%\System32\WindowsPowerShell\v1.0\powershell.exe"-NoProfile-InputFormatNone-ExecutionPolicyBypass-Command"iex((New-ObjectS
Python通过requests、BeautifulSoup等库实现高效房价数据采集,利用pandas进行数据清洗与预处理,结合matplotlib、seaborn可视化分析区域房价分布、面积与价格关系,并可通过scikit-learn构建预测模型,挖掘价格影响因素与市场趋势。
Scrapy架构设计的亮点包括:1.基于Twisted的异步机制提升并发效率;2.中间件机制灵活处理Request和Response;3.组件可扩展性强,支持自定义Spider、Pipeline等;4.清晰的组件划分便于理解和维护。
Go语言以其并发处理、低延迟和强大的标准库,为数据分析创新赋能。通过并发处理,Go语言能同时执行多个分析任务,显著提升性能。其低延迟特性使分析应用程序能够实时处理数据,实现快速响应和洞察。此外,Go语言丰富的标准库提供了数据处理、并发控制和网络连接的库,方便分析师构建健壮、可扩展的分析应用程序。
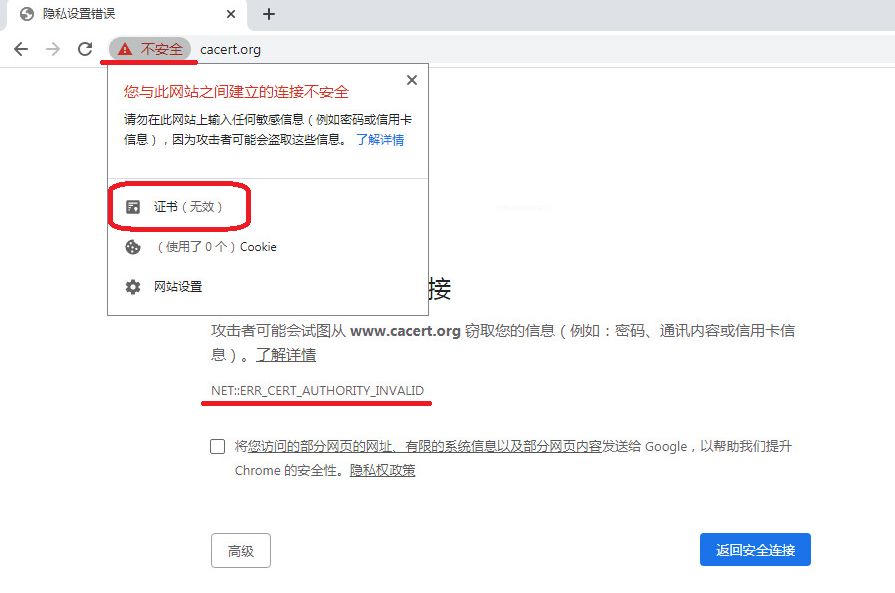
本文作者:jack.zhou(TimelineSec交流群成员)本文共2076字,预计阅读时间为6到7分钟。声明:本文内容仅供学习研究,不得用于非法途径,违者后果自负。0x01简介对于未接触过公钥签名信任体系的读者,可能难以理解此漏洞。我们先不讨论具体的算法和PKI公钥体系,简单介绍一下证书信任关系的建立。在现实生活中,人与人之间、公司与公司之间的信任关系最初是不存在的。信任通常是通过相互认识和交往建立起来的,但这种方法的缺陷在于一个人或公司不可能认识所有其他人和公司。那么,如何在不认识的人或公司之间
Golang为数据分析团队提供了多项优势:出色的并发性和高性能,使用goroutine进行并行处理。简洁易学的语法和强类型系统,缩短开发时间。丰富的针对数据分析的库和工具生态系统,简化任务。

MySQLvs.TiDB:哪个数据库更适合实时数据分析?引言:在现代数据驱动的世界中,实时数据分析对于企业的决策和业务发展至关重要。选择合适的数据库是实现高效实时数据分析的关键。本文将探讨MySQL和TiDB这两种常见的数据库,分析它们在实时数据分析方面的特点和优势,并给出适用场景和代码示例,帮助读者更好地选择最适合自己需求的数据库。一、MySQL数据
PHP作为一种广泛应用于Web开发的编程语言,它的数据查询和分析功能的效率将直接影响到Web应用程序的性能和用户体验。本文将介绍PHP如何实现高效的数据查询和分析功能,提供精准数据支持。一、优化数据库查询操作数据库查询是所有Web应用程序的核心操作之一,因此优化数据库查询能够显著提升应用程序的性能。以下是如何优化PHP应用程序中的数据库查询操作:1.使用索引





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



