

分析Scrapy进行AJAX网站数据爬取的实例案例
随着互联网的发展,越来越多的网站采用了AJAX技术,实现了网页内容的动态加载,提高了用户的交互体验。然而,这也给爬虫带来了一定的挑战,因为传统的爬虫只能抓取静态的网页内容。本文将介绍如何使用Scrapy实现对AJAX网站数据的爬取。一、Scrapy简介Scrapy是一个开源的Python爬虫框架,它可以帮助我们快速地开发并部署爬虫应用。使用Scrapy,我们
随着互联网的发展,越来越多的网站采用了AJAX技术,实现了网页内容的动态加载,提高了用户的交互体验。然而,这也给爬虫带来了一定的挑战,因为传统的爬虫只能抓取静态的网页内容。本文将介绍如何使用Scrapy实现对AJAX网站数据的爬取。
一、Scrapy简介
Scrapy是一个开源的Python爬虫框架,它可以帮助我们快速地开发并部署爬虫应用。使用Scrapy,我们可以轻松地抓取网页、处理数据、以及存储数据。Scrapy还支持多线程、分布式等特性,可以大大提高爬虫的效率,是当前最为流行的爬虫框架之一。
二、AJAX网站的数据抓取挑战
许多网站采用了AJAX技术,通过异步加载数据来实现动态的网页内容和交互效果。在传统的爬虫中,抓取数据的方式是直接从HTML源代码中提取数据。而对AJAX网站的抓取,需要模拟浏览器的行为,先发起AJAX请求,再从返回的数据中提取所需的内容。
三、Scrapy实现AJAX网站数据爬取的步骤
下面,我们将介绍如何使用Scrapy实现对AJAX网站数据的爬取。
- 创建Scrapy项目
首先,我们需要创建一个新的Scrapy项目,可以使用命令行工具创建,如下所示:
scrapy startproject ajax_demo
执行上述命令后,Scrapy会在当前目录下创建一个名为ajax_demo的新项目,包含了项目的基本结构和配置文件。
- 定义Item
在Scrapy中,Item是用来表示从网页中抽取的数据的容器,类似于一个Python字典。在本例中,我们定义一个Item类来保存从AJAX请求中抓取的数据,如下所示:
class AjaxDemoItem(Item):
    name = Field()
    price = Field()
    description = Field()
我们定义的Item包括商品名称、价格和描述三个字段。
- 定义Spider
Scrapy中的Spider负责从网站中抓取数据,因此,我们需要定义一个Spider来处理AJAX请求。在本例中,我们使用Python的requests库发送AJAX请求,并从返回的JSON数据中提取Item数据。Spider的代码如下所示:
import json
import requests
from scrapy import Spider
from scrapy.http import Request
from ajax_demo.items import AjaxDemoItem


class AjaxSpider(Spider):
    name = "ajax_spider"
    allowed_domains = ["example.com"]
    start_urls = ["http://www.example.com/products"]

    def parse(self, response):
        page = 1
        url = "http://www.example.com/ajax/products?page={}".format(page)
        yield Request(url, callback=self.parse_ajax)

    def parse_ajax(self, response):
        data = json.loads(response.text)
        for product in data["products"]:
            item = AjaxDemoItem()
            item["name"] = product["name"]
            item["price"] = product["price"]
            item["description"] = product["description"]
            yield item
在上述代码中,我们定义了一个名为AjaxSpider的Spider,设置了爬取网站的域名和起始URL。在parse方法中,我们发送了一个AJAX请求,获取第一页数据。在parse_ajax方法中,我们使用json.loads解析返回的JSON数据,并从中提取出Item数据。
- 启动爬虫
最后,我们需要启动爬虫,使用下面的命令进行启动:
scrapy crawl ajax_spider -o products.csv
执行该命令后,Scrapy将启动AjaxSpider爬虫,发送AJAX请求并抽取数据,将结果保存到products.csv文件中。
四、总结
本文介绍了如何使用Scrapy实现对AJAX网站数据的爬取。首先,我们创建了一个新的Scrapy项目,并定义了Item类和Spider类。然后,我们使用Python的requests库发送AJAX请求,并从返回的JSON数据中提取Item数据。最后,我们启动了爬虫,并将结果保存到CSV文件中。Scrapy框架的强大和灵活使得我们能够轻松地应对网站的各种形式,并提取所需数据,是一个非常优秀的爬虫开发框架。
IE浏览器怀旧版在线网址:一次精准的技术时光回溯 最近,不少老用户和怀旧爱好者在反复搜索一个问题:那个经典的Internet Explorer,如今还能在哪里原汁原味地体验到?答案指向一个特定的地址:https://ie.microsoft.com/legacy/。 这个网站远不止是一个简单的“皮肤
最近研究了一下怎么爬取那些Ja vaScript渲染后的网页内容,折腾了一圈,发现核心武器还是得靠Puppeteer。不过它是个Node库,想在PHP里用还得再套一层,这里用到了`spatie/browsershot`这个包。下面把整个流程和踩坑点都捋一遍。 ## 环境依赖 先看看环境要求,其实不算
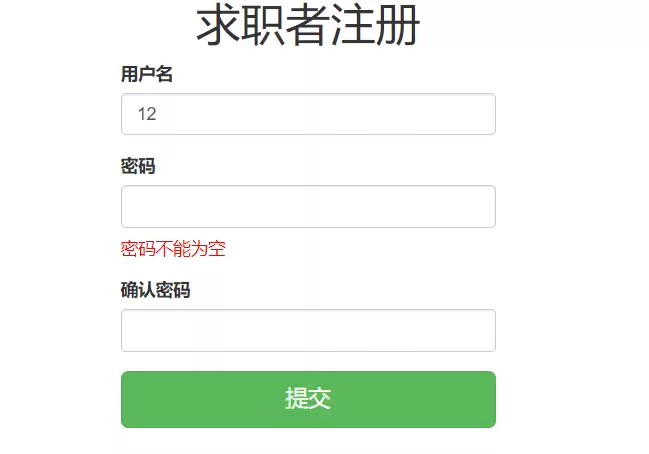
采用AJAX与SpringMVC的异步验证,通过XMLHttpRequest对象实现局部数据交换,利用@ResponseBody返回JSON或字符串,结合@RequestBody解析请求体,完成表单无刷新校验,包括用户名重复检测与密码一致性验证。该方法提升交互效率,减少带宽占用,有效确保数据准确性,提升用户体验。
AJAX使网页无需整体刷新即可与服务器交换数据并局部更新,实现无刷新体验。通过PHP实例,用户在输入框键入字符时,JavaScript创建XMLHttpRequest对象向PHP文件发送请求,服务器查找匹配姓名并返回结果,实现实时提示。跨域请求需采用JSONP或CORS解决方案。
解析XML时,本地文件用ElementTree.parse(),网络字符串用fromstring()。命名空间需显式声明或使用“.//tag”模糊匹配。文本为空时用strip()判断,含子标签用itertext()拼接。findall()查直接子节点,iter()深度遍历,需按需选用。
基于SQLite实现爬虫断点续传,需建表含url、status、updated_at三列,使用INSERTORIGNORE防重。请求前将URL标记为pending,成功后更新为success,失败更新为error。重启时对error状态URL设置冷却时间再重置为pending,避免无限重试,并记录更新时间用于超时重试判断。
爬虫数据提取最可靠的验证方式是回溯HTML节点层级,确认选择器命中目标元素。需用开发者工具定位真实结构,避免被动态class、JS渲染干扰。使用属性锚定和结构断言,区分服务端与客户端渲染,并用正则校验提取结果格式,确保每次抓取流程中嵌入验证。
调试爬虫核心:让变量“开口说话”,在发送请求后立即检查response.status_code、url和text[:200]内容。必须使用Debug模式而非Run,并确保未勾选RunwithPythonConsole。常见问题:HTTP200但response.text为空或包含反爬代码,需检查请求头(如User-Agent)和解码方式。若Beautiful
动态下拉菜单爬取常见问题包括元素未加载、被遮挡或嵌套iframe、事件未触发及反爬拦截。解决方案涉及使用WebDriverWait等待可点击、切换iframe、执行JavaScript点击、触发change事件,以及隐藏自动化特征以规避反爬。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



