

Layer 6 AI:训练大模型时别让它"跑偏"
该研究揭示了强化学习训练中大语言模型崩溃的根源,发现正优势与谷值词、负优势与峰值词的更新会引发高熵或低熵崩溃。基于此提出赢家优势策略优化(WAPO),仅对优于平均水平的答案进行更新,在数学和多步推理任务中显著提升稳定性,尤其避免模型输出乱码或陷入重复循环。
师从加拿大Layer 6 AI研究团队的一篇预印本,论文编号为arXiv:2606.16154。有兴趣的读者,可以用这个编号检索完整原文。
一、模型训练的"崩溃"困局
想象一下,一个平时成绩不错的学生,某天在考卷上突然胡言乱语——要么写满无意义的重复数字,要么用中、英、日、阿拉伯文混搭出乱码。这种荒诞的场景,在大语言模型的训练中正高频上演。
研究团队记录到两种典型"崩溃":高熵崩溃,模型输出像乱了套的大脑,内容混杂着各种语言、代码片段和乱码;低熵崩溃,模型则走向另一个极端,输出变得极度单调,比如无限重复长串零或某个固定模板,像是紧张到说不出话来。
这两种崩溃的幕后黑手,都是同一样东西:强化学习训练过程的不稳定性。这项研究的目标很明确——揪出这种不稳定性的根源,并给出一个简单有效的解法。
二、强化学习训练究竟是怎么回事
要深入理解这项研究,得先弄明白大语言模型训练中的强化学习具体在做什么。
普通大众熟悉的预训练,是让模型"看了海量文字后预测下一个词"。但为了让模型真正"会做题"——比如解数学题、处理多步骤问题——研究人员发明了带有可验证奖励的强化学习(RLVR)。
可以这样理解:给模型出一道数学题,它能生成多种解法,答对给奖励,答错扣分。通过反复尝试,模型会逐渐走向"更可能答对"的方向。听起来很合理,但实际执行中问题不少。
目前最主流的训练方法是GRPO(群组相对策略优化)。核心逻辑是:对同一道题,让"旧版本模型"先生成一批答案,根据优劣给每个答案打一个相对分(称为"优势值"),然后用来更新"新版本模型"。关键问题在于,新旧模型之间存在差距,用旧模型生成的样本来训练新模型,就像用三年前的菜谱指导今天的厨师。
为了控制这种"偏离",研究人员引入了重要性比率截断机制:如果新旧模型在某个词上的概率差距过大,就把这个词的训练信号截掉。直觉上这很稳健——差距越大的地方越不可信,截掉它们似乎是个好策略。
但Layer 6 AI的研究团队做了一个实验,直接推翻了这一直觉。他们发现,截断阈值调得越严——也就是截掉更多"差距大"的词——训练崩溃得越彻底、越频繁。截得越狠,问题越严重。这说明,"与旧模型差距大"本身并非崩溃的根本原因,问题一定另有根源。
三、一把手术刀:解剖每一个词的梯度效果
研究团队转换视角:不问"这个词离旧模型有多远",而是问"更新这个词,会把模型在当前位置的概率分布变成什么样"。
要理解这个思路,先要明白语言模型如何"选词"。在每个生成步骤,模型会为词汇表中的每个词打分,然后通过softmax函数转化为概率。比如在"我今天吃了___"这个位置,"饭"可能有30%的概率,"苹果"有20%,"汽车"可能只有0.001%。
训练时,模型生成了某个词,并依据正确答案获得奖励信号,随后对模型参数进行微调。这个调整会如何影响下次遇到同样位置时各词的概率?
研究团队推导出一个数学公式(论文中的方程1),揭示了一个出人意料的规律:对于所有未被采样到的词,其概率变化取决于三个因素:采样到这个词的概率、该未采样词自身的概率,以及一个叫C(p)的参考值。C(p)等于所有词概率的平方和,像一个"标尺",衡量当前概率分布的集中或分散程度。
更直观地说,每个词都有一个"地位":若其概率高于C(p)阈值,称为峰值词(Peak);低于阈值,则是谷值词(Valley)。同时,采样词的奖励信号有正负之分——若答案优于平均水平,优势值为正;反之为负。
这样一来,每一次对某个词的训练,都可以归入四个格子之一:正优势+峰值词(Pos-peak)、正优势+谷值词(Pos-valley)、负优势+峰值词(Neg-peak)、负优势+谷值词(Neg-valley)。
这四个格子对模型的影响截然不同。研究团队通过理论推导和实验验证,发现Pos-valley和Neg-peak这两类更新会让模型分布变得更混乱、更随机,是推动高熵崩溃的主要力量。Pos-peak更新则让分布更集中、更确定,是稳定的。而Neg-valley更新虽短期内能降低混乱度,但在模型整体已较高熵时,反而会把分布过度压缩,引发低熵崩溃。
这一发现非常关键:决定训练是否崩溃的,不是某个词"离旧模型有多远",而是"这个词在当前模型中属于峰值还是谷值,以及它携带的是正还是负奖励信号"。
四、实验验证:把四种训练方式分开测试
为验证理论,研究团队进行了一组极为干净的实验:用SmolLM3-3B模型在NuminaMath-LEAN数学数据集上训练,每次只激活四个格子中的一个,观察训练走向。
结果完全符合理论预测。仅做Pos-peak训练,模型非常稳定,熵持续下降,但成绩快速到顶后不再进步——模型只是在强化已擅长的事,不探索新路径。仅做Pos-valley或Neg-peak训练,模型熵迅速飙升,随后生成内容崩溃为乱码。仅做Neg-valley训练,模型早期有所进步,但后期陷入过度自信,生成内容单调重复,出现低熵崩溃。
将四格子按"正/负优势"或"峰值/谷值"两两组合测试时,结论进一步明朗:正优势(Pos)方向的训练——只强化那些优于平均水平的答案——在稳定性和最终表现上最为均衡,与主流基线方法DAPO的表现相当。换言之,从安全性和有效性来看,"只强化赢家"是个简单而有力的策略。
五、WAPO的提出:只从赢家身上学
基于上述发现,研究团队提出了一个名为赢家优势策略优化(Winner Advantage Policy Optimization,WAPO)的方法。
其核心思想极简:在一批答案中,只对优势值为正(优于平均水平)的答案进行策略梯度更新,那些更差的答案直接忽略,不产生任何训练信号。如果一道题的所有回答都错了(没有"赢家"),这道题对本轮训练无任何贡献。
打个比方:老师批改作业,只从做对的题里总结经验,错误题目不处理。这与常规的"分析错题"截然不同,但在该场景下更有效。
WAPO并非简单粗暴地"扔掉失败案例"。它保留了GRPO家族方法的核心机制:重要性比率(修正新旧模型差距)、截断(避免单次更新步子太大)、以及以组为单位的优势归一化(让每道题内的答案相互比较)。唯一的改变,就是把所有负优势项的贡献置零。
研究团队还从理论上证明了WAPO的梯度方向正确。在简化的"二元奖励"场景(答对1分,答错0分)下,WAPO的梯度更新方向与"直接最大化答对概率"的梯度方向一致,只是多了个自适应权重因子1-qx(qx为当前模型在该题上的答对率)。这个权重因子特性良好:当一道题答对率已很高时,权重自动缩小,模型不会在已掌握题目上浪费时间;当题目很难时,权重较大,模型会把更多注意力放在这道题上。这是一种天然的"难题优先"机制。
同时,研究团队还比较了另两个只使用正样本的方法。PSR不使用截断和相对优势归一化,学习效率低,成绩很快遇到天花板。RAFT++按答案长度归一化,结果模型学会了"写短答案"的策略,后期专门产出极短的模板化回答,如"思考了一下,答案是3。答案:3"——这显然是偷懒式崩溃,虽然形式未乱,但学习质量极差。WAPO通过保留相对优势归一化和截断,有效规避了这两个问题。
六、大规模实验:跨任务、跨模型的全面验证
研究团队在四个数据集和三个模型家族上进行了系统实验,覆盖数学推理和多步问答两大类任务。
数学推理方面,选用了Math-500(500道标准数学题)和NuminaMath-LEAN(两万多道数学竞赛题)。多步问答方面,选用了Hotpot-QA和OTT-QA(要求模型先搜索信息再综合推理,难度远超单轮问答)。三个测试模型分别为Qwen3-4B、SmolLM3-3B和Gemma3-4B,参数量在3到4亿之间。
对比的基线方法有GRPO(标准版)、DAPO(改进长度归一化和截断策略)、GSPO(用序列级别比率替换词级别比率)。每种方法都经过了针对各数据集的调参,确保公平。
实验结果呈现出非常清晰的规律。在多步问答任务上,WAPO的优势最为突出。在OTT-QA上,与次优稳定基线相比,WAPO在Qwen3-4B上领先9.9个百分点,在Gemma3-4B上领先3.2个百分点。在Hotpot-QA上,WAPO分别领先4.5和10.6个百分点。DAPO在这些任务中频繁崩溃——Hotpot-QA的三个模型里有两个崩溃;OTT-QA的Qwen3-4B在100步内彻底失败,无法输出有效数字。GRPO和GSPO相对稳定,但常在训练中途停止进步,而WAPO能持续提升到最后。
在数学任务上,WAPO的表现与最强基线基本持平,只在训练初期偶尔略慢——这恰是"难题优先"权重因子带来的保守性,不在已擅长题目上猛追。从最终成绩来看,WAPO能追上并与其他方法并驾齐驱。
研究团队还测试了WAPO的"泛化能力":把在Hotpot-QA上训练好的模型拿去处理2wiki问答(全新多步问答数据集),把在NuminaMath-LEAN上训练好的模型拿去应付AIME'25(顶级数学竞赛题集)。在2wiki测试中,WAPO在三个模型家族上全面领先其他方法,说明它学到的不是针对特定数据集的技巧,而是更通用的推理能力。在AIME'25上,各方法整体差距不大,WAPO与其他方法基本持平,而该任务本身已是极高难度。
此外,研究团队还考察了一个容易被忽视的指标:pass@k(k次尝试中至少答对一次的概率)。该指标衡量模型的"探索多样性"——若模型总输出相同内容,其pass@k曲线会很快平坦。结果显示,WAPO在pass@k上的表现优于或持平其他基线,说明虽只用正样本训练,但它并未变成只会走老路的僵化模型,仍保持了良好的探索能力。
七、说到底,这项研究改变了什么
归根结底,这项研究做了一件简单却极具价值的事:它不再把训练不稳定的原因归咎于"模型跑偏了",而是深入每个词的训练信号层面,搞清楚了"哪类更新有害、哪类有益"。这好比医生不满足于诊断"身体不好",而是精确指出"是这两根神经的信号传导出了问题"。
这种分析视角带来了极简解法——WAPO。它只做了一件事——去掉负优势的更新——却在多个任务和模型上显著提升了训练稳定性,尤其在困难的多步推理任务上。
对普通用户而言,这项研究意味着未来的AI助手在学习新能力时,更不易"走火入魔"输出乱码或陷入循环,整个训练过程更可控、更稳定,最终效果更佳。研究团队已开源完整代码,有兴趣的开发者可通过论文中提供的GitHub地址自行验证。
对研究人员来说,这篇工作也提出了值得深挖的方向:负优势样本中是否也有部分有价值,只是当前难以从粗粒度奖励信号中区分?该分析框架能否扩展到更大模型或更复杂任务(如编程、文字转SQL)?若更能精细识别和利用负样本中的有效信号,训练效率是否还能提升?
若你对这些好奇,值得去读读原文,编号arXiv:2606.16154。所有理论推导和实验细节,都在那里等你。
Q&A
Q1:WAPO方法与普通GRPO训练方式有何本质区别?
A:GRPO训练时,无论答案好坏,都会影响模型参数更新——好的被强化,差的被抑制。WAPO则完全忽略那些比平均差答案,只从较好的答案中提取经验。用于更新模型的机制(截断、重要性比率、相对优势归一化)保持不变,唯一改动就是把负优势的贡献置零。
Q2:为什么截断更多"离旧模型远的词"反而导致崩溃?
A:研究发现,截断阈值越严,受影响最大的是那些概率本就极低的词。这些低概率词在负优势更新中,原本是"降低混乱度"的力量(Neg-valley类型)。若把它们的更新信号也截断,剩下的训练信号中熵增效应(来自Neg-peak和Pos-valley类型)会相对更占主导,反而让模型越训越乱,加速崩溃。
Q3:WAPO在数学任务上为何有时比GRPO或GSPO慢?
A:WAPO使用自适应权重因子——当一道题答对率已较高时,会自动减小更新力度。这意味着训练初期,在相对容易的题目上,WAPO的学习步伐较为保守,看起来追得慢。但这种保守在后期会带来好处:模型不会因过度强化简单题而丧失探索难题的能力,最终成绩能追平甚至超越其他方法,尤其在困难任务上。
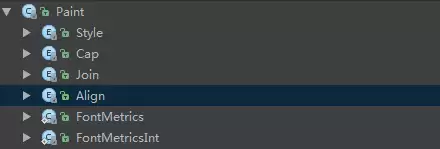
本节引言: 在 Android 基础入门教程——8.3.1 三个绘图工具类详解 Paint 的方法参数那一节里,其实已经接触过几个很关键的东西:Paint.Style、Paint.Cap、Paint.Join 等。它们本质上都是 Paint 里的枚举值,很多相关效果,正是通过设置这些枚举值来完成的。
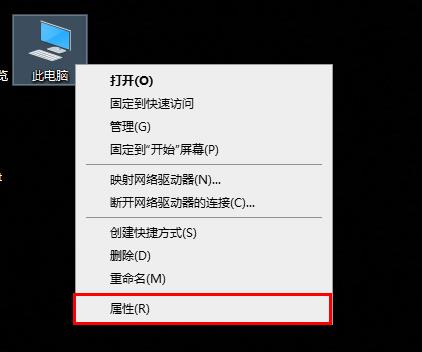
不少小伙伴都反映在edge浏览器上登录网站的时候都提示tls安全设置未设置为默认设置,那么该怎么去进行设置呢?下面就一起来看看设置的方法吧。edge浏览器tls安全设置未设置为默认设置怎么办:1、右击此电脑点击“属性”。2、点击“控制面板”。3、点击查看方式的下拉,选择“大图标”。4、在控制面板中点击“Internet选项”。5、在新窗口选择“高级”,勾选“使用TLS1.0/1.1/1.2”前面的√,点击“确定”即可。6、开启之后如果还是不行,那先点击下方“重置”后再重复上述操作试试看。

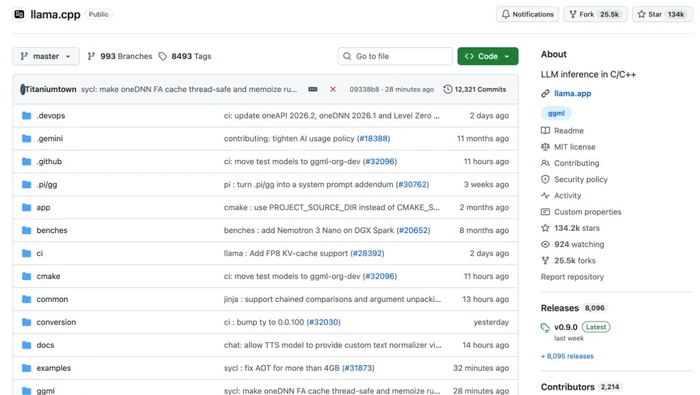
llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。
MiniMax-H3-Image新增DiffSynth-Studio文档推荐后,配置选择应围绕具体推理配方和独立训练流程展开。文档中的24GB GPU方案分别配合32GB或8GB主机RAM,所用量化、CPU或磁盘卸载方式不同;新增文档入口本身没有发布模型新权重或标注一个新的框架版本。
识别Ollama完整rc0预发布标签,区分MLX并发、Vulkan集成显卡mmap、llama.cpp b12257与CLI集成更新边界。
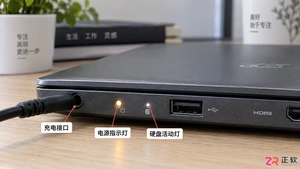
宏基笔记本遇到开机没反应、电源灯亮但屏幕黑屏,或者按下电源键完全无反应的情况该怎么办?本文通过界面与状态指示灯的观察,分步骤介绍静电释放、内存重插及外接显示器测试等实用方法,助你自行解决常见启动故障。
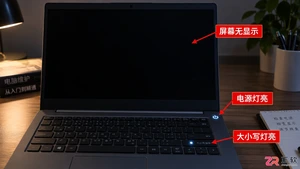
惠普笔记本开机时电源键和大小写锁定键亮起,但屏幕无反应?这通常是嵌入式控制器(EC)逻辑错误或静电干扰所致。本文详解如何通过移除外设、长按电源键进行硬件复位来恢复正常启动,并提供BIOS恢复及进一步硬件检测的建议。
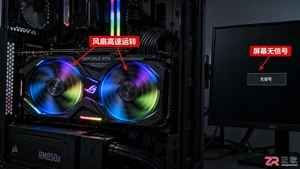
遇到电脑黑屏伴随显卡风扇狂转?这往往是显卡过热保护、供电不足或驱动崩溃的信号。本文详解如何通过观察指示灯、重置驱动、检查线缆及清理灰尘来解决该问题,避免盲目更换硬件。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



