

二叉树最大深度怎么算递归计算方法详解
详解二叉树最大深度的递归计算原理,通过分解左右子树高度差与基准条件,提供清晰的代码实现与复杂度分析,帮助开发者掌握树形结构遍历的核心逻辑。
计算二叉树最大深度的核心判断非常直接:树的深度等于其左子树深度与右子树深度中较大者加一。这个定义天然契合递归结构,因为每个子树本身也是一棵二叉树。只要处理好空节点这一基准情况,递归就能自动完成从叶子到根的深度累加。不要试图用循环去模拟这种层级嵌套,除非你明确需要避免栈溢出。最小复现场景是一个只有根节点的树,其深度为1;若根节点为空,深度为0。理解了这个边界,后续的逻辑推导就不会偏离轨道。
递归的因果链条为何成立
递归之所以能算出最大深度,是因为它将大问题拆解成了结构完全相同的子问题。当我们站在任意一个节点时,我们并不关心整棵树的全貌,只关心两件事:左边有多深,右边有多深。
深度计算的因果关系是单向且局部的:当前节点的深度依赖于子节点的返回值。如果左子节点返回2,右子节点返回3,那么当前节点的深度必然是4(3+1)。这种依赖关系一直传递到叶子节点。叶子节点的左右子节点均为空,空节点返回0,因此叶子节点的计算结果为 max(0, 0) + 1 = 1。这个1回传给父节点,成为父节点计算的基础。
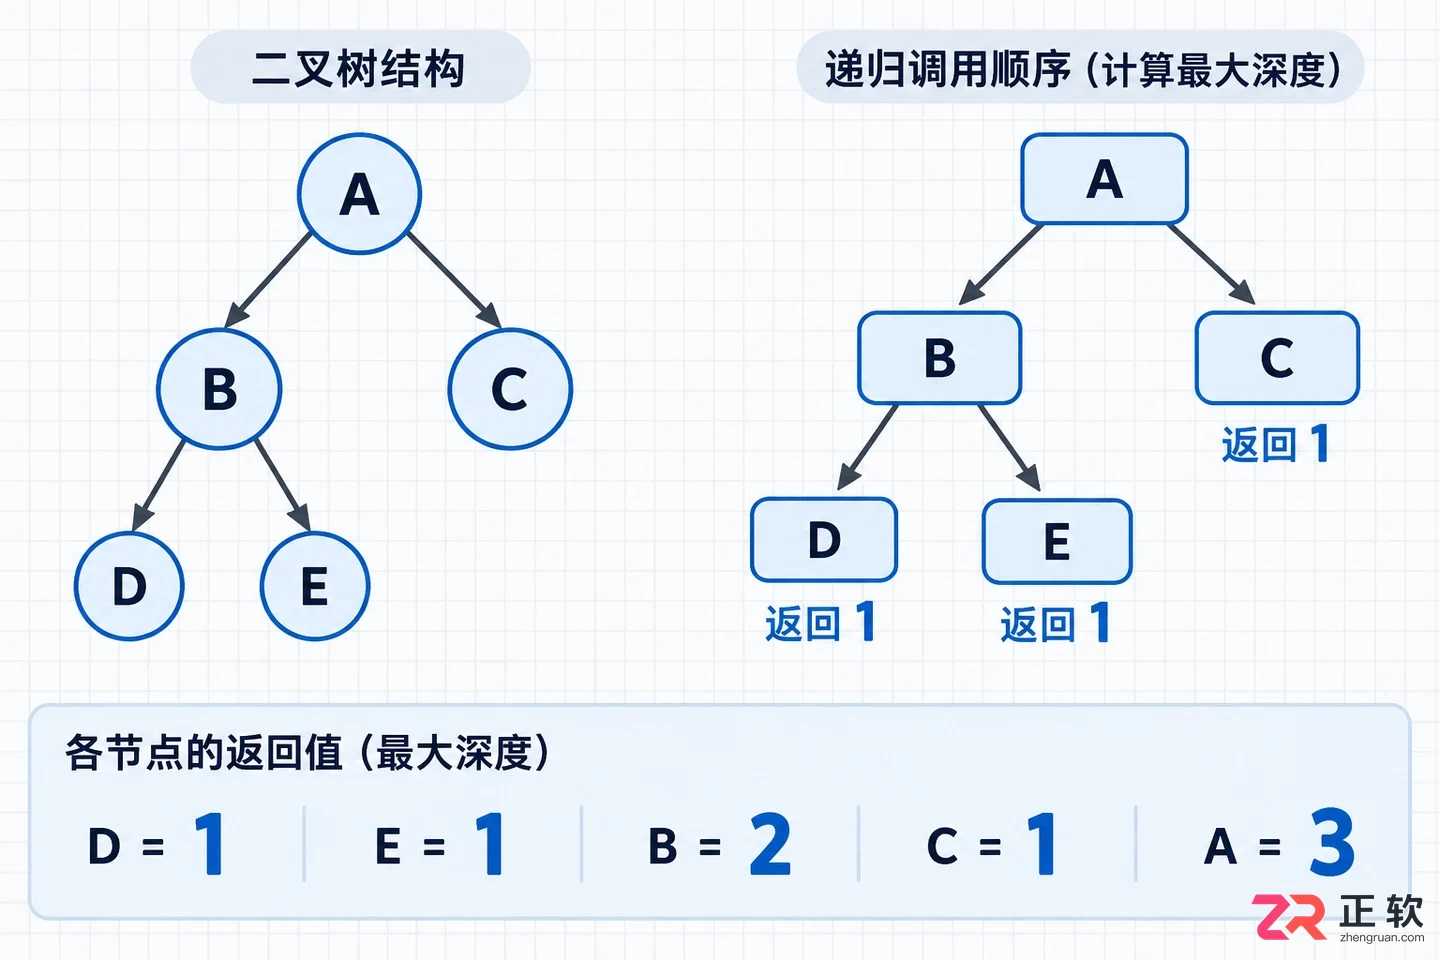
递归调用栈与深度返回值的因果对应关系
这个过程没有全局状态共享,每个函数调用栈帧只保存当前层的局部变量。这就是为什么递归代码通常极短,但思维负担在于信任“子问题已解决”这一假设。如果你纠结于每一步的具体跳转,反而容易陷入细节迷宫。只需确认两点:基准条件能否终止递归,递推公式是否覆盖了所有非基准情况。
代码实现与执行轨迹
以Python为例,递归实现几乎是对数学定义的直译。关键在于处理 root is None 的情况,这是递归的出口。如果没有这个出口,程序会尝试访问空对象的属性,导致运行时错误。
class TreeNode:
    def __init__(self, val=0, left=None, right=None):
        self.val = val
        self.left = left
        self.right = right

def maxDepth(root: TreeNode) -> int:
    # 基准条件:空节点深度为0
    if root is None:
        return 0

    # 递归计算左右子树深度
    left_depth = maxDepth(root.left)
    right_depth = maxDepth(root.right)

    # 当前节点深度 = 较大子树深度 + 1
    return max(left_depth, right_depth) + 1
这段代码的执行轨迹是自底向上的。假设树结构为 1 -> (2, 3),即根节点1,左子2,右子3。调用 maxDepth(1) 时,它会先挂起,去计算 maxDepth(2)。maxDepth(2) 发现左右均为空,返回0,于是 maxDepth(2) 返回1。同理 maxDepth(3) 返回1。最后回到根节点,max(1, 1) + 1 得到结果2。
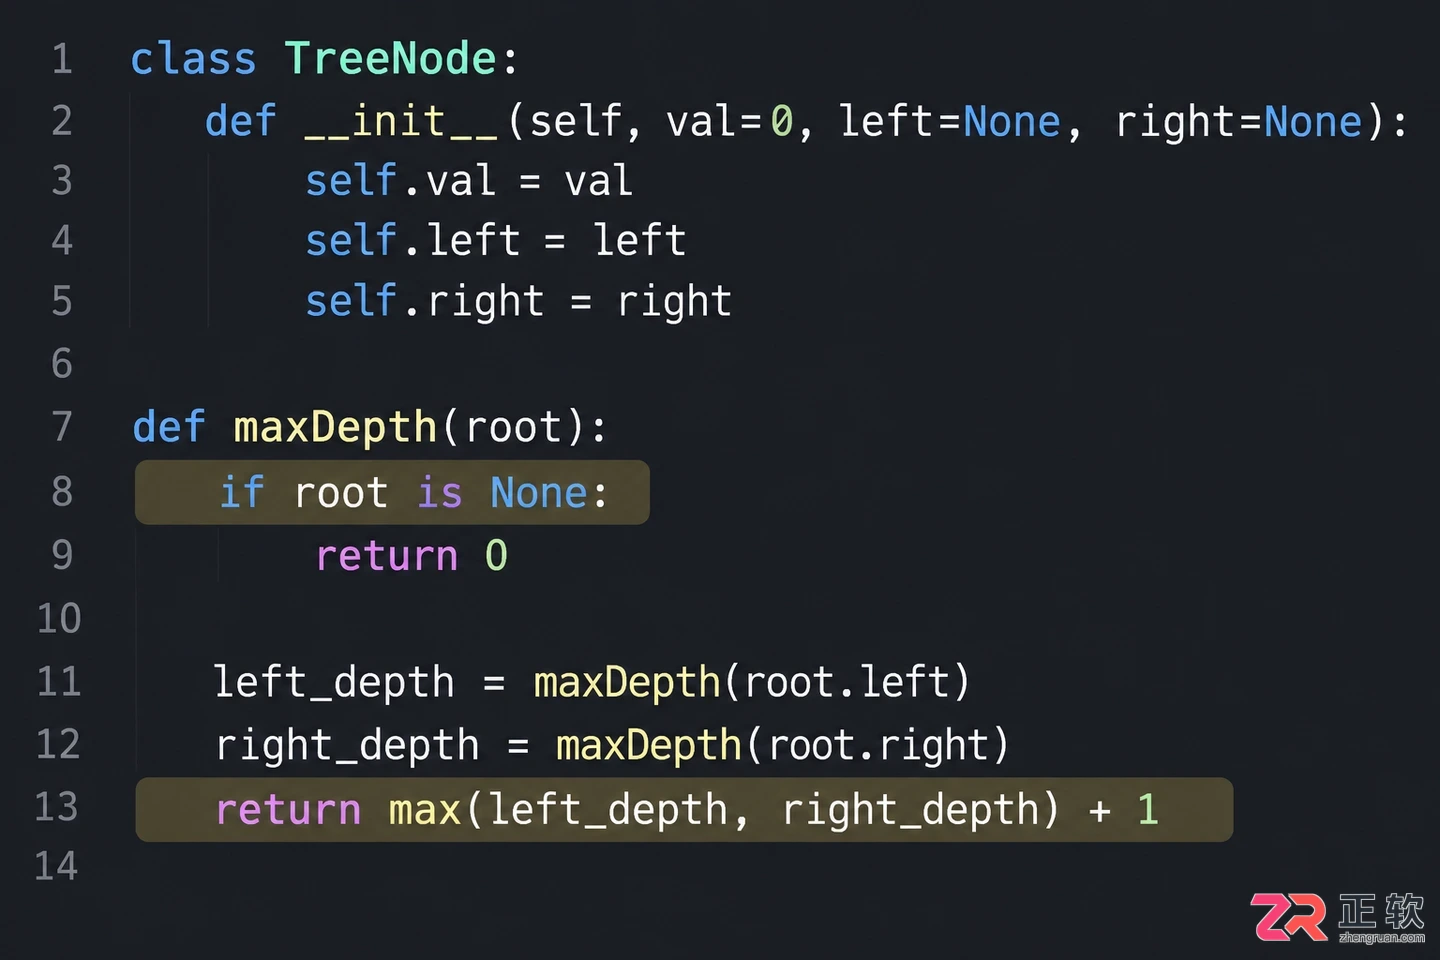
Python实现二叉树最大深度递归算法
在Java或C++等静态语言中,逻辑完全一致,只是语法稍显繁琐。需要注意的是,递归深度受限于调用栈大小。对于平衡二叉树,深度为 log(N),栈空间消耗很小;但对于退化成链表的二叉树,深度为 N,可能导致栈溢出(Stack Overflow)。
class Solution {
    public int maxDepth(TreeNode root) {
        if (root == null) {
            return 0;
        }
        int leftDepth = maxDepth(root.left);
        int rightDepth = maxDepth(root.right);
        return Math.max(leftDepth, rightDepth) + 1;
    }
}
什么时候不该用递归
虽然递归写法简洁,但它不是万能药。当二叉树极度不平衡,甚至退化为单链表时,递归深度可能达到数万层,这会耗尽线程栈空间。此时,递归不再是优雅的选择,而是潜在的崩溃点。
替代方案是使用广度优先搜索(BFS)或迭代式深度优先搜索(DFS)。BFS按层遍历,每遍历完一层,深度计数器加一。这种方法的空间复杂度取决于最宽层的节点数,而不是树的深度,因此在极端情况下更稳定。
from collections import deque

def maxDepthIterative(root: TreeNode) -> int:
    if not root:
        return 0

    queue = deque([root])
    depth = 0

    while queue:
        depth += 1
        level_size = len(queue)
        for _ in range(level_size):
            node = queue.popleft()
            if node.left:
                queue.append(node.left)
            if node.right:
                queue.append(node.right)

    return depth
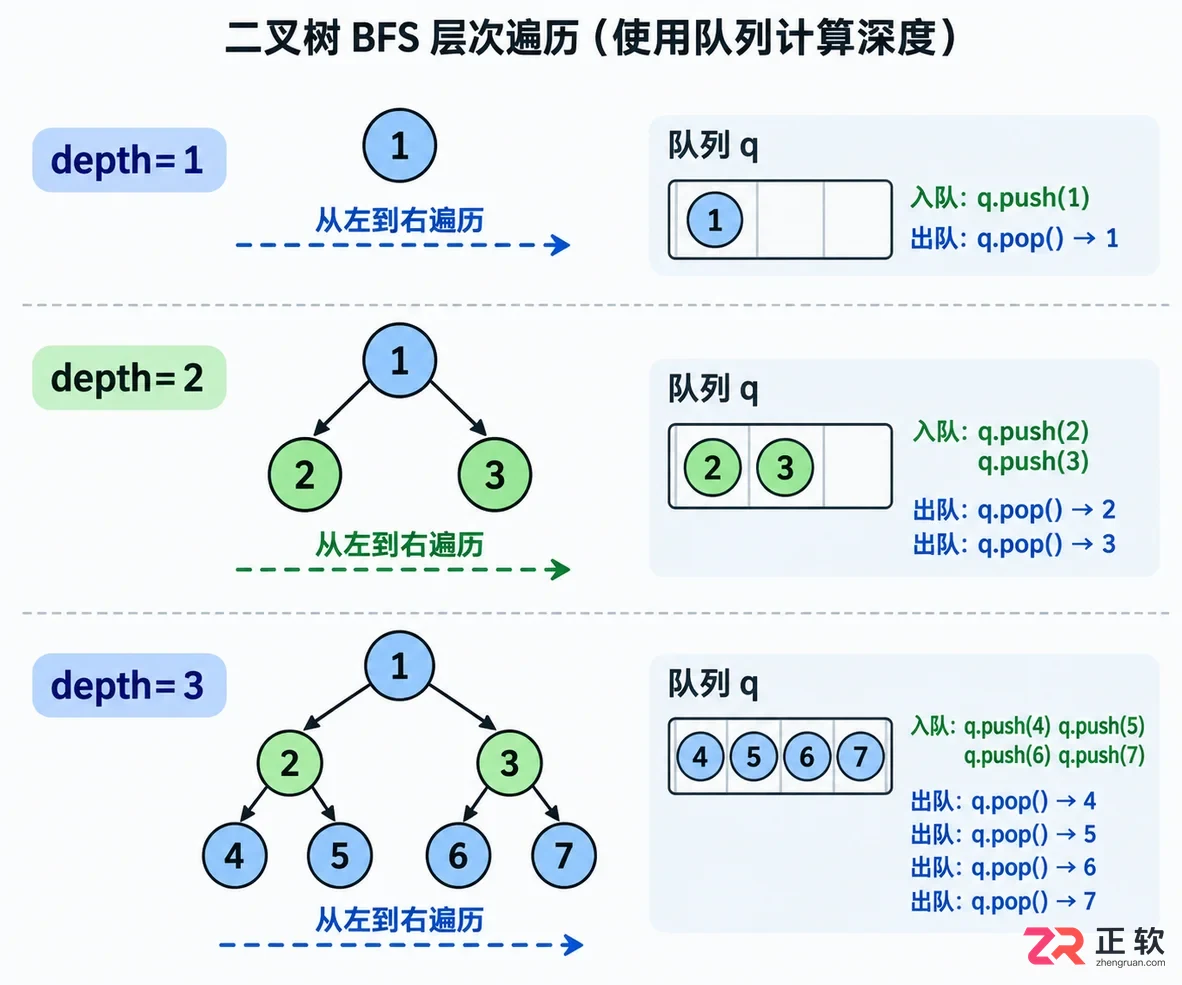
使用队列进行层次遍历计算深度
迭代写法虽然代码量增加,但消除了函数调用的开销和栈溢出风险。在实际工程中,如果输入数据的树结构不可控,优先选择迭代或显式栈实现的DFS。递归适用于结构相对平衡、深度可控的场景,或者作为快速原型验证逻辑正确性的手段。
掌握二叉树深度的计算,本质上是掌握如何将树形结构的整体属性分解为局部属性的叠加。递归提供了最自然的分解视角,而迭代提供了最稳定的执行保障。根据数据特征选择工具,比盲目追求代码简短更重要。
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
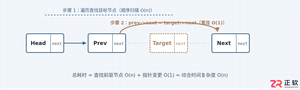
详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。
编程语言仅为工具,真正决定高度的是数据结构和算法及计算机底层逻辑理解。建议从C语言入门,打好基本功。根据目标选择深入方向,避免同时学习多门语言。最终目标是学会用程序解决问题,语言只是实践载体。
引言 编程,是一门实践科学。这意味着,学习它的最佳方式就是动手去敲代码。但这是否意味着,我们可以因此轻视理论的学习呢? 入门编程 如果你去各大技术社区提问“该如何入门编程”,五花八门的答案会瞬间涌来。 不过,仔细梳理一下,无外乎以下几种流派: 学院派 他们推荐从C语言入手,并辅以数据结构、操作系统等
LRU缓存通过哈希表与双向链表结合,实现O(1)读写与淘汰;哈希表快速定位节点,双向链表维护访问顺序,最近访问节点移至头部,超出容量时移除尾部最久未使用节点。
数据结构和算法在移动开发中至关重要,可帮助构建高效应用程序。常见的实用数据结构包括链表和队列,适用于联系人列表和消息队列等场景。排序算法(如联系人按姓名排序)和搜索算法(如二分查找)可高效处理数据。通过选择和使用适当的数据结构和算法,开发人员可以显著提高移动应用程序的性能和用户体验。
在OOPPHP中,有以下数据结构设计模式:阵列模式:表示有序元素序列;链表模式:表示可增长的有序元素序列;堆栈模式:表示后进先出元素序列;队列模式:表示先进先出元素序列;树状模式:表示分层结构;图形模式:表示具有节点和边界的结构。
B树是一种用于快速存储和检索数据的平衡搜索树。利用联合索引、前缀索引和正确的平衡策略可优化B树索引的性能。具体而言,选择合适的阶数、使用联合索引、使用前缀索引和选择正确的平衡策略可以显著提高B树索引的性能。
C++中的内存对齐是一种编译器优化技术,通过让数据在内存中的起始地址成为特定值(通常是2的幂)的倍数来提高数据访问效率。具体来说,内存对齐的主要原因是现代CPU以字为单位访问内存,如果数据地址不是字大小的倍数,CPU可能需要两次访问,降低执行效率。例如,一个结构体structExample{chara;intb;}在32位系统上,int需要4字节对齐,编译器会插入填充字节以满足对齐要求。在实际应用中,合理使用内存对齐可以显著提升程序性能,但过度对齐可能导致内存浪费,因此需要在性能和内存使用之间找到平衡。通





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



