

deepseek怎么加脚本代码及具体操作步骤
了解DeepSeek模型如何处理代码任务。本文详解通过API接入、提示词优化及本地环境配合,实现脚本生成与自动运行的具体步骤,避免对模型功能的误解。
很多开发者初次接触 DeepSeek 时,会下意识寻找一个“插件管理器”或“脚本上传入口”,期望像给浏览器安装扩展那样,直接把一段 Python 或 JavaScript 代码塞进模型里,让它永久具备某种新能力。这种期待源于对传统软件架构的惯性思维,但在大语言模型(LLM)的语境下,这是一个根本性的概念错位。
DeepSeek 本质上是一个预训练的语言模型,它的“知识”和“能力”固化在权重参数中,并不支持用户在运行时动态注入可执行代码来修改其核心行为。你无法在对话框里上传一个 .py 文件并命令它“以后都按这个逻辑回答”。
但这并不意味着我们无法让 DeepSeek 处理脚本任务。正确的做法是将“代码生成”与“代码执行”分离:让 DeepSeek 负责编写和优化代码,而由你的本地环境或服务器负责运行这些代码。本文将拆解这一工作流的具体操作步骤,从 API 接入到自动化闭环,帮你建立正确的使用范式。
理解模型边界:生成而非执行
在动手之前,必须明确 DeepSeek 的角色定位。它是一个代码生成器,而不是代码解释器。当你输入“写一个爬取网页标题的脚本”时,它输出的是文本形式的代码字符串,而不是真正去访问网络。
这种分离带来了两个关键影响:
- 安全性:模型不会在你的服务器上意外执行恶意代码,因为代码从未在模型端运行。
- 灵活性:生成的代码可以在任何支持该语言的环境中运行,不受模型沙箱限制。
因此,“加脚本”的实际含义是:构建一个系统,其中 DeepSeek 作为智能编码助手,根据你的需求动态生成脚本,并由外部程序接管执行结果。
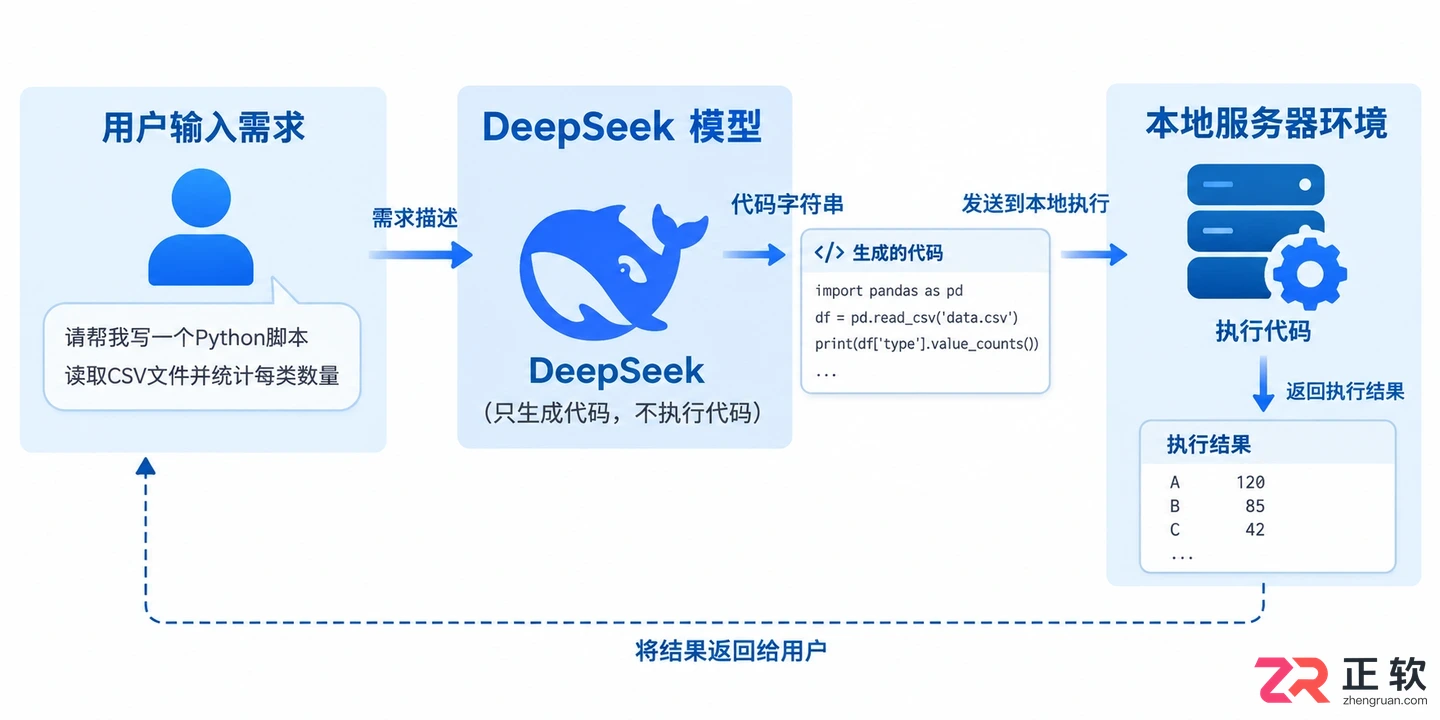
DeepSeek代码生成与执行分离的工作流示意图
1. 通过 API 接入模型能力
要实现自动化脚本生成,第一步是通过 API 与 DeepSeek 建立连接。相比网页对话框,API 允许你将模型的输出直接传递给后续的处理程序。
首先,你需要获取 DeepSeek 的 API Key。登录官方平台后,在控制台创建新的密钥。注意保管好这串字符,它相当于你的身份凭证。
接下来,使用标准的 HTTP 请求库进行调用。以下是一个使用 Python requests 库的最小化示例,展示如何发送指令并接收代码响应:
import requests
import json

api_key = "your_deepseek_api_key"
url = "https://api.deepseek.com/v1/chat/completions"

headers = {
    "Content-Type": "application/json",
    "Authorization": f"Bearer {api_key}"
}

payload = {
    "model": "deepseek-coder",
    "messages": [
        {"role": "system", "content": "你是一个专业的Python工程师,只输出代码,不包含解释。"},
        {"role": "user", "content": "写一个函数,计算列表中的平均值。"}
    ],
    "temperature": 0.1
}

response = requests.post(url, headers=headers, json=payload)
data = response.json()
code_content = data['choices'][0]['message']['content']
print(code_content)
在这个例子中,我们将 model 指定为 deepseek-coder,这是专门针对代码任务优化的版本。temperature 设为较低值,以确保生成的代码语法稳定、可预测。
2. 优化提示词以获取可执行脚本
API 调通后,你会发现模型输出的代码有时包含 Markdown 标记(如 ```python),或者附带了多余的注释。为了让脚本能直接被后续程序执行,需要精心设计提示词(Prompt)。
有效的提示词应包含三个要素:角色设定、输出格式约束、具体任务描述。
例如,不要只说“写个脚本”,而是说:
“你是一个后端开发专家。请编写一个 Python 脚本,用于读取 CSV 文件并统计每列的空值数量。要求:1. 仅输出纯代码,无 Markdown 包裹;2. 使用 pandas 库;3. 包含必要的异常处理。”
这种明确的约束能大幅减少后期清洗数据的工作量。如果模型依然输出 Markdown 标记,你可以在代码层面对响应内容进行简单的字符串替换处理:
def clean_code(raw_text):
    # 移除常见的 Markdown 代码块标记
    cleaned = raw_text.replace("```python", "").replace("```", "").strip()
    return cleaned

clean_script = clean_code(code_content)
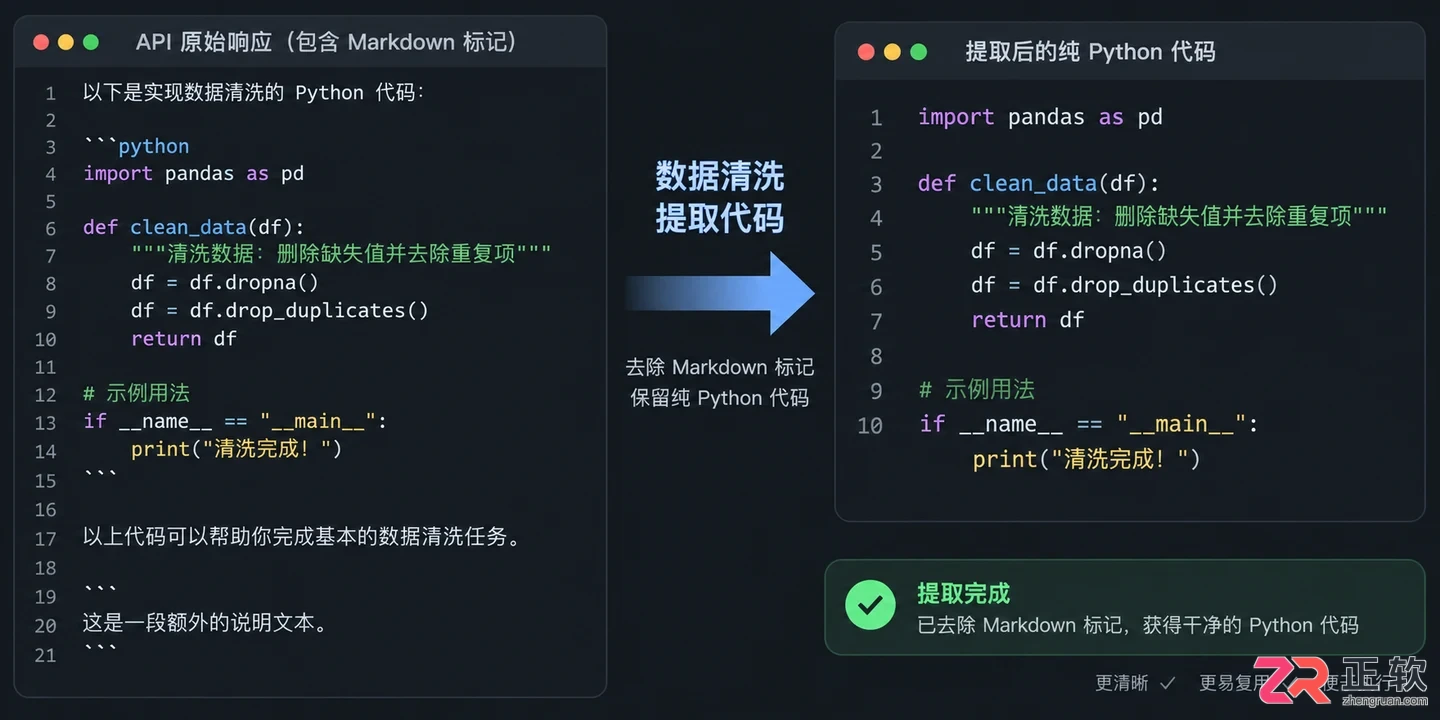
API响应数据清洗与代码提取过程
3. 在本地环境中安全执行生成的代码
拿到清洗后的代码字符串后,下一步是让它在你的环境中跑起来。这里存在一个常见的误区:直接使用 Python 的 exec() 函数执行任意字符串。
虽然 exec() 能快速验证代码,但它极具危险性。如果模型被诱导生成了删除文件或窃取数据的代码,exec() 会照单全收。因此,建议采用更隔离的执行方式。
一种稳妥的做法是将生成的代码写入临时文件,然后在子进程中运行。这样可以利用操作系统的权限控制,限制脚本的资源访问。
import subprocess
import tempfile
import os

def run_generated_script(code_str):
    # 创建临时文件
    with tempfile.NamedTemporaryFile(mode='w', suffix='.py', delete=False) as tmp_file:
        tmp_file.write(code_str)
        tmp_path = tmp_file.name

    try:
        # 在子进程中执行,捕获输出
        result = subprocess.run(
            ['python', tmp_path],
            capture_output=True,
            text=True,
            timeout=10  # 设置超时防止死循环
        )
        return result.stdout, result.stderr
    finally:
        # 清理临时文件
        os.remove(tmp_path)

stdout, stderr = run_generated_script(clean_script)
if stderr:
    print(f"执行错误: {stderr}")
else:
    print(f"执行结果: {stdout}")
这种方式不仅安全,还能方便地捕获标准输出和错误信息,便于调试模型生成的代码逻辑。
4. 构建自动化反馈闭环
单次生成往往不够完美。在实际工程中,我们常需要“生成-执行-报错-修正”的循环。DeepSeek 支持多轮对话上下文,我们可以利用这一点构建自动修复机制。
当脚本执行出错时,将错误信息(stderr)连同原始代码一起发回给模型,要求它修复 bug。
操作逻辑如下:
- 发送初始需求,获取代码 V1。
- 执行 V1,若报错,捕获错误信息。
- 构造新提示词:“之前的代码执行报错,错误信息如下:[Error Msg]。请修复代码并重新输出。”
- 发送新提示词,获取代码 V2。
- 重复直至成功或达到最大重试次数。
这种机制模拟了人类程序员调试的过程,能显著提高最终脚本的可用性。需要注意的是,务必设置最大重试上限(如 3 次),避免因模型陷入逻辑死胡同而产生无限循环的 API 调用。
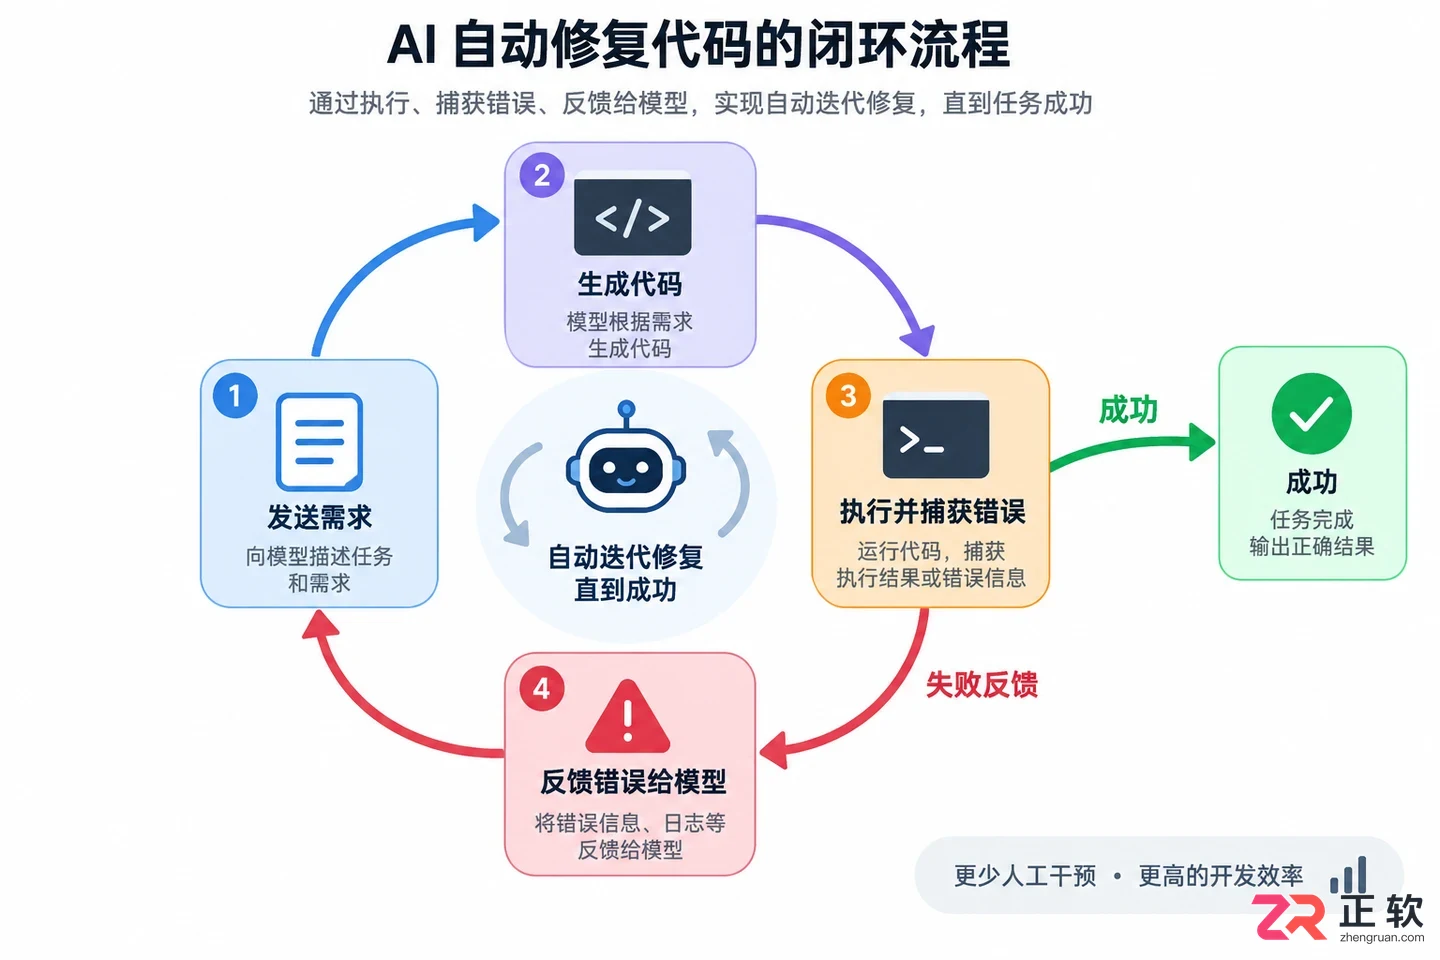
生成-执行-修复的自动化闭环流程
例外情况:何时不建议使用此流程
尽管上述流程覆盖了大多数场景,但仍有几种情况不适合让 DeepSeek 生成脚本:
首先是高度确定的业务逻辑。如果你的计算规则固定且复杂,硬编码比依赖模型生成更可靠。模型可能会在细微的逻辑分支上产生幻觉,导致数据偏差。
其次是对实时性要求极高的场景。API 调用和网络传输存在延迟,通常在秒级。如果需要毫秒级的脚本响应,本地预编译的代码库是唯一选择。
最后是涉及敏感数据的处理。虽然我们可以控制执行环境,但将包含内部数据结构或隐私信息的提示词发送给云端模型仍存在合规风险。此类场景应使用本地部署的开源模型,或在发送前对数据进行脱敏处理。
小结
DeepSeek 不能像插件一样“加载”脚本,但它能通过 API 成为你自动化工作流中的智能编码引擎。关键在于转变思路:不追求在模型内部执行代码,而是构建一个“模型生成+本地执行+反馈修正”的外部闭环。
通过规范 API 调用、严格清洗输出、安全执行代码以及建立自动修复机制,你可以将 DeepSeek 的代码能力无缝集成到现有的开发体系中。记住,模型是副驾驶,方向盘和刹车始终掌握在你构建的系统手中。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
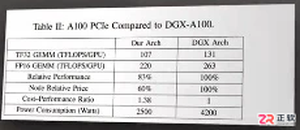
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。
DeepSeek返回空内容时,先检查content是否只有空格,再查看finish_reason、reasoning_content、tool_calls和流式事件。JSON模式提示不完整、输出预算不足、内容过滤、工具调用未处理或SSE解析错误都可能造成“看起来为空”。
DeepSeek开启流式输出只需在API请求中设置stream=true并逐块读取SSE事件。Chat Completions以data: [DONE]结束,Responses API则以response.completed、response.incomplete或response.failed结束,两种协议不能混用同一套结束判断。
DeepSeek开启JSON模式需要在请求中设置response_format为json_object,并在系统或用户提示词中明确要求输出JSON及字段示例,同时设置足够的max_tokens。返回后仍应解析和校验字段,空白内容或截断时执行重试。
DeepSeek-V4提示词可按“目标+背景+输入+约束+输出格式+验收标准+示例”编写。先明确要完成的任务,再提供必要材料和边界,最后规定可检查的输出结构,比堆砌角色词或空泛要求“更专业”更稳定。
DeepSeek上传文件提示超限时,先确认是在App、网页还是API中上传,再检查单文件大小、格式、图片尺寸、文件数量和账号存储配额。App或网页可压缩、拆分后重传;API图片文件单个最大64 MiB,并只支持JPEG、PNG、GIF和WebP。
DeepSeek-V4-Pro的推理强度可通过API的reasoning_effort设置为low、high或max,并配合thinking启用思考模式;网页和App通常只提供模式切换,不一定开放细粒度强度。本文给出参数、代码和无效配置排查方法。
DeepSeek账号密码忘记后,可在官方登录页切换到密码登录并点击“忘记密码”,使用绑定手机号或邮箱完成身份验证,再设置新密码。通过Apple、Google或微信注册的账号应优先使用原第三方方式登录。
手机收不到DeepSeek验证码时,先核对国家区号和手机号,等待发送倒计时结束,再检查短信拦截、网络和运营商状态;仍收不到可改用密码、Apple或其他已绑定方式登录,并通过官方反馈渠道处理账号问题。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



