

PDF里的表格怎么提取到Excel?行列错位怎么修正
围绕PDF表格提取到Excel后的行列错位问题,介绍PDF.cn在线转换、WPS本地表格模式和OCR区域识别三条路线,并说明上传、参数选择、下载核对、合并单元格修正、数字与日期格式检查及结果验收方法,适用于文字型PDF、复杂表格及扫描件处理。
可以提取。文字能够选中、表格边框较清楚的文件,可先用PDF转Excel生成工作簿;若导出后出现行列错位,应先判断问题来自合并单元格、跨页表头还是扫描识别,再按对应方式修正。扫描型PDF不含可直接诿取的文字层,通常要改走OCR区域识别路线。
方法一:用PDF转Excel在线提取文字型表格
适用场景:PDF中的文字可以选中,表格线和列间距相对清楚,希望快速导出为XLSX后继续编辑。限制:跨页表头、纵向合并单元格和多层嵌套表格可能需要手动整理;扫描件或拍照生成的PDF不保证直接得到规整单元格。
第 1 步:找到工具入口。进入PDF.cn后,在转换工具区域找到对应入口,先确认处理方向是从PDF导出到Excel,避免进入方向相反的功能。
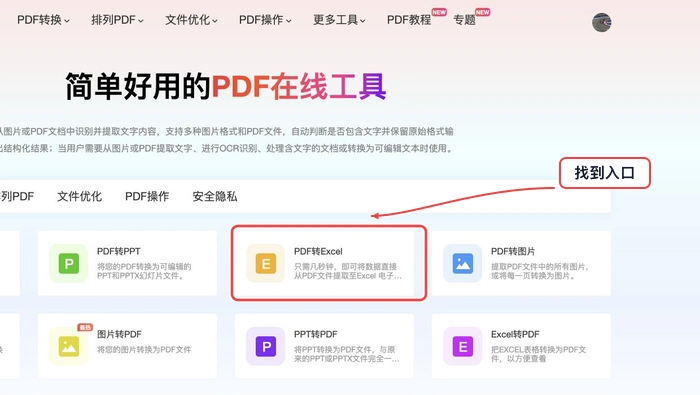
找到工具入口
第 2 步:选择并上传文件。点击页面中的文件选择区域,加入待处理的PDF。上传前可先关闭正在占用文件的程序,并确认文件不是空白页或只有封面。
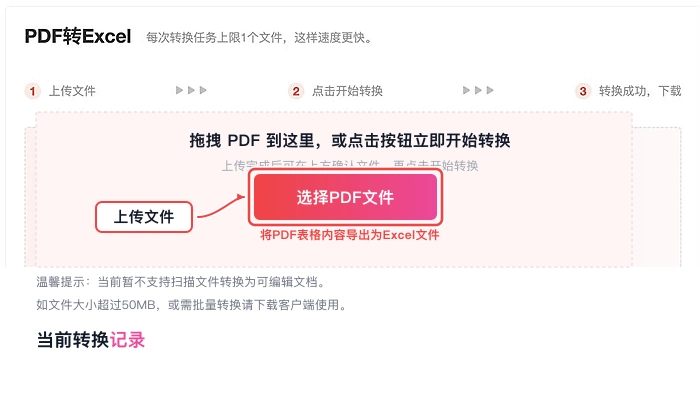
选择并上传文件
第 3 步:核对上传状态。文件出现在列表后,检查文件名、大小和上传状态是否与本地原件一致。若选错文件,应先从列表移除再重新添加,不要直接带着错误文件继续。
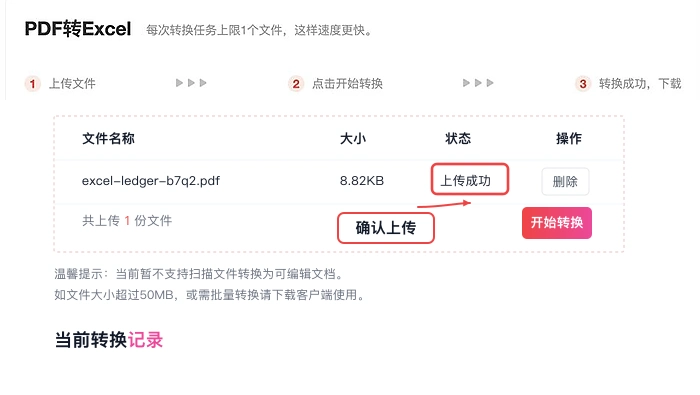
核对上传状态
第 4 步:开始处理。确认列表中的文件无误后再启动转换。处理期间保留当前页面,避免重复点击造成同一文件被多次提交。
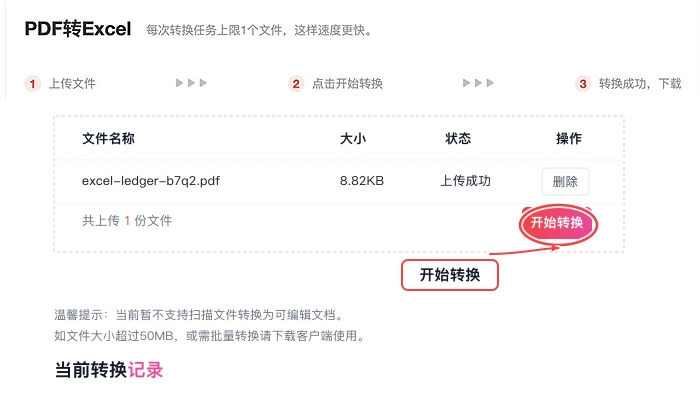
设置参数并开始处理
第 5 步:下载并检查结果。状态显示转换完成后下载文件。打开工作簿,先对照PDF检查页数、工作表数量、表头、第一行与最后一行,再抽查金额、日期、小数点和负号。
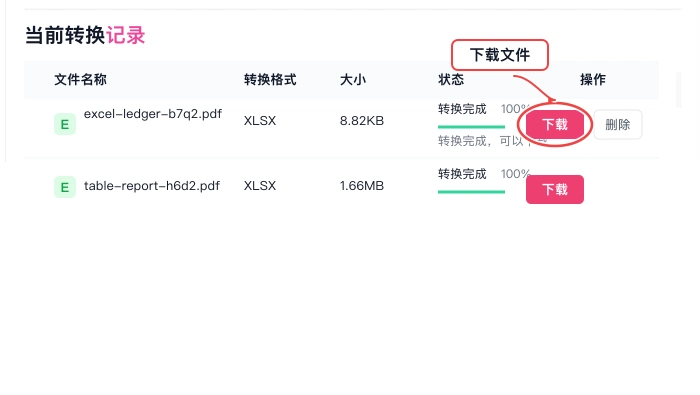
下载结果并检查
完成后怎么验收:选取一页结构最复杂的表格,逐项比对列标题、记录数和关键合计值。如果只有少数标题单元格偏移,可在Excel中局部取消合并、移动数据后再按视觉需要合并;若整张表都串列,应回到原文件重新转换或改用第三种方法。
方法二:用WPS本地转换并选择表格模式
适用场景:电脑上已有WPS,希望在本地转换界面中预览文件,并根据表格特点选择转换模式。限制:PDF中只保存了显示结果时,原公式、筛选关系和数据验证规则通常无法还原;复杂版式仍可能产生拆列或错行。
第 1 步:加入文件并确认输出方向。在WPS PDF转换界面选择“转为Excel”,添加目标PDF,并核对页数、输出范围及文件勾选状态。只处理部分页面时,应先记下原PDF的页码范围,便于导出后复核。
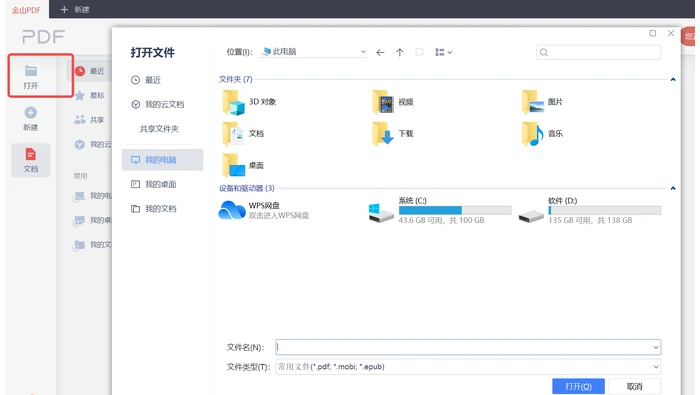
在WPS中选择转为Excel,并核对文件与输出范围
第 2 步:按表格特征选择转换模式。表格结构普通时可先使用自动选择;更重视原页面位置时,可尝试布局优先;需要后续修改单元格内容时,可比较编辑优先的结果。不要只看外观,应以列数据是否对应为判断标准。
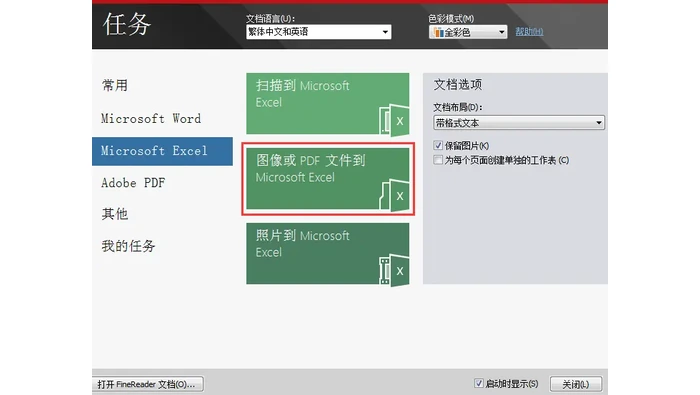
根据表格结构比较自动选择、布局优先和编辑优先
完成后怎么验收:对同一复杂页面分别查看表头和数据区。若布局优先的外观更接近原稿,但数字落在不可连续编辑的区域,可换编辑优先再比较;最终保留记录数、关键字段和合计值都能对上的版本。
方法三:扫描表格用OCR区域识别
适用场景:PDF页面实际是图片,文字无法选中,或表格存在印章、底纹、倾斜和模糊线条。限制:OCR会受到清晰度、字体、边框断裂和拍摄角度影响,识别后必须人工核对,不能承诺完整恢复复杂排版。
第 1 步:先做表格识别。在带OCR的本地工具中打开扫描PDF,选择表格识别功能,让工具区分普通文字与单元格区域。页面倾斜时应先校正方向;同页包含多个表格时,宜分区域处理,减少标题和页脚混入数据区。
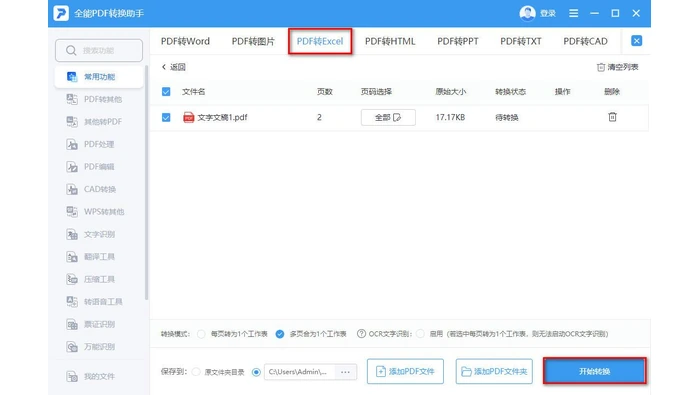
对扫描页面启用表格识别并检查识别区域
第 2 步:在预览中校正表格区域。进入带页面预览的转换界面后,重点检查识别框是否覆盖完整表格。遇到多层表头或边框缺失,可使用界面提供的表格区域、结构分析等选项重新划定范围,再执行转换。
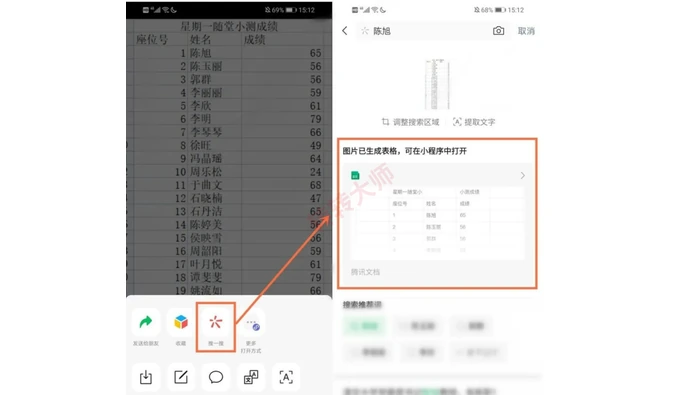
在页面预览中检查表格区域与结构分析结果
完成后怎么验收:逐列抽查容易误识别的“0/O”“1/I”、小数点、负号和日期分隔符,再比较首尾记录及合计值。若某一列从中间开始整体偏移,应返回OCR阶段缩小识别范围,而不是在Excel中逐格搬移整张表。
三条路线怎么选
| 文件特征 | 优先路线 | 重点检查 |
|---|---|---|
| 文字可选中,表格边界清晰 | 在线转换 | 表头、列数、合计值 |
| 希望在本地预览并比较表格模式 | WPS本地转换 | 布局与可编辑性的平衡 |
| 文字不可选中,页面是扫描图 | OCR区域识别 | 识别框、数字和符号 |
行列错位排查与修正
| 表现 | 常见原因 | 修正方式 | 验收点 |
|---|---|---|---|
| 表头正常,数据从某行开始串列 | 原表存在纵向合并或跨页断点 | 取消问题区域的合并,按关键字段对齐后再处理标题单元格 | 每行关键编号与原稿一致 |
| 一个表头被拆成多列 | 多层表头或不规则边框 | 保留数据列,单独重建表头,避免整列盲目合并 | 列名与数据含义一一对应 |
| 编号前导零消失或日期变化 | Excel自动套用数字或日期格式 | 对编号列使用文本格式,对日期列按原稿统一格式 | 抽查首尾编号与日期 |
| 扫描表格整块偏移 | OCR区域包含页眉、页脚或相邻表格 | 返回识别阶段重新框选单一表格区域 | 列数与原表一致,合计值无误 |
修正前建议保留一份原始导出文件,并在副本中操作。不要仅凭页面看起来整齐就覆盖原结果,至少要用记录数、唯一编号、金额合计或其他关键字段进行交叉核对。
常见问题
转换后能恢复原来的Excel公式吗?
通常不能。PDF主要保存页面显示结果,公式、筛选条件和数据验证等工作簿逻辑往往已经不存在,导出后需要按业务规则重新建立。
为什么同一张表被拆到多个工作表?
跨页、重复表头或版式变化都可能触发表格分段。先逐段核对列结构,只有关键列完全对应时再合并,不要直接把所有区域首尾拼接。
行列错位能不能全部自动修好?
简单边框表格通常更容易保持结构,但复杂合并、扫描噪点和倾斜页面仍需人工校正。判断是否可用,应以数据准确性为准,而不是以视觉相似度为准。
参考来源
表格结构越复杂,越应先选一页做小范围验证,再决定是否批量处理。后续需要处理更多PDF转换、识别和排版问题时,可以继续关注极轻PDF网站的实用教程。
PDF转Excel的一键转换适合边界清楚的普通表格,复杂报表仍需按文件类型选择PDF.cn在线转换、桌面识别或OCR加人工校对三种方法;文章重点处理合并单元格、数字串行、日期误识别和扫描表格错位。转换后还需核对行列数、合计值和关键字段格式。
PDF转Excel准确度受表格结构和扫描质量影响。文章提供在线转换五步流程,并说明合并单元格、跨页表头、数字日期和错位数据的校对方法。
PDF转Excel常遇表格行列错位、数字错格等问题。本文详解在线与本地两种转换路径,重点解析如何区分电子版与扫描版PDF,并提供从上传、转换到下载的全流程操作指南。通过规范的文件预处理与关键数据核对步骤,帮助用户快速定位并修复转换后的格式错误,确保数据准确性。
本文针对PDF表格转Excel后出现的乱码与错位问题,提供基于极轻PDF(pdf.cn)的在线转换流程及数据校对方法。核心步骤包括:确认文件类型(非扫描件)、上传PDF、执行转换并下载XLSX文件。重点排查源文件编码、多余空格及合并单元格导致的错位,建议对金额、日期等关键列进行抽样核对。若源文件为截图或模糊扫描件,不建议在线硬转,需先进行OCR处理。
本文提供PDF转Excel的三种实操方法:在线工具(极轻PDF)、Adobe Acrobat及Excel内置导入功能。重点涵盖文件备份、上传转换步骤及结果核对(表头、行列、格式)。适用于表格类PDF转换,解决错位与格式丢失问题,附失败处理方案。
本文基于极轻PDF(pdf.cn)在线工具,详解PDF转Excel的操作流程。核心步骤包括:进入工具入口、上传文件、确认状态、开始转换及下载结果。重点强调转换前需备份原文件,转换后需核对表头、行列错位、合并单元格及数字格式。若处理失败,可通过刷新重试或联系官方客服解决。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



