

abbyy finereader怎么拆分pdf 页面提取与文件分
是一种图片文字识别软件。FineReader提供快速、准确、方便的方式来扫描文件、PDF格式、数字或移动电话图像转换成可编辑的格式
学习如何在 ABBYY FineReader PDF 16 (Windows) 中拆分 PDF 文件。包括如何精准提取指定页面生成新文件,以及如何按固定页数批量拆分大型文档,保留原文件并验证输出结果。
在 ABBYY FineReader PDF 中处理文档时,拆分操作通常对应两个不同需求:要么是从长文档中精准取出几页关键内容,要么是将整份大文件按规则切割成多个小文件以便分发。直接删除不需要的页面会破坏原件,而使用软件内置的提取与拆分功能,可以在保留源文件完整性的同时,快速生成独立的新 PDF。
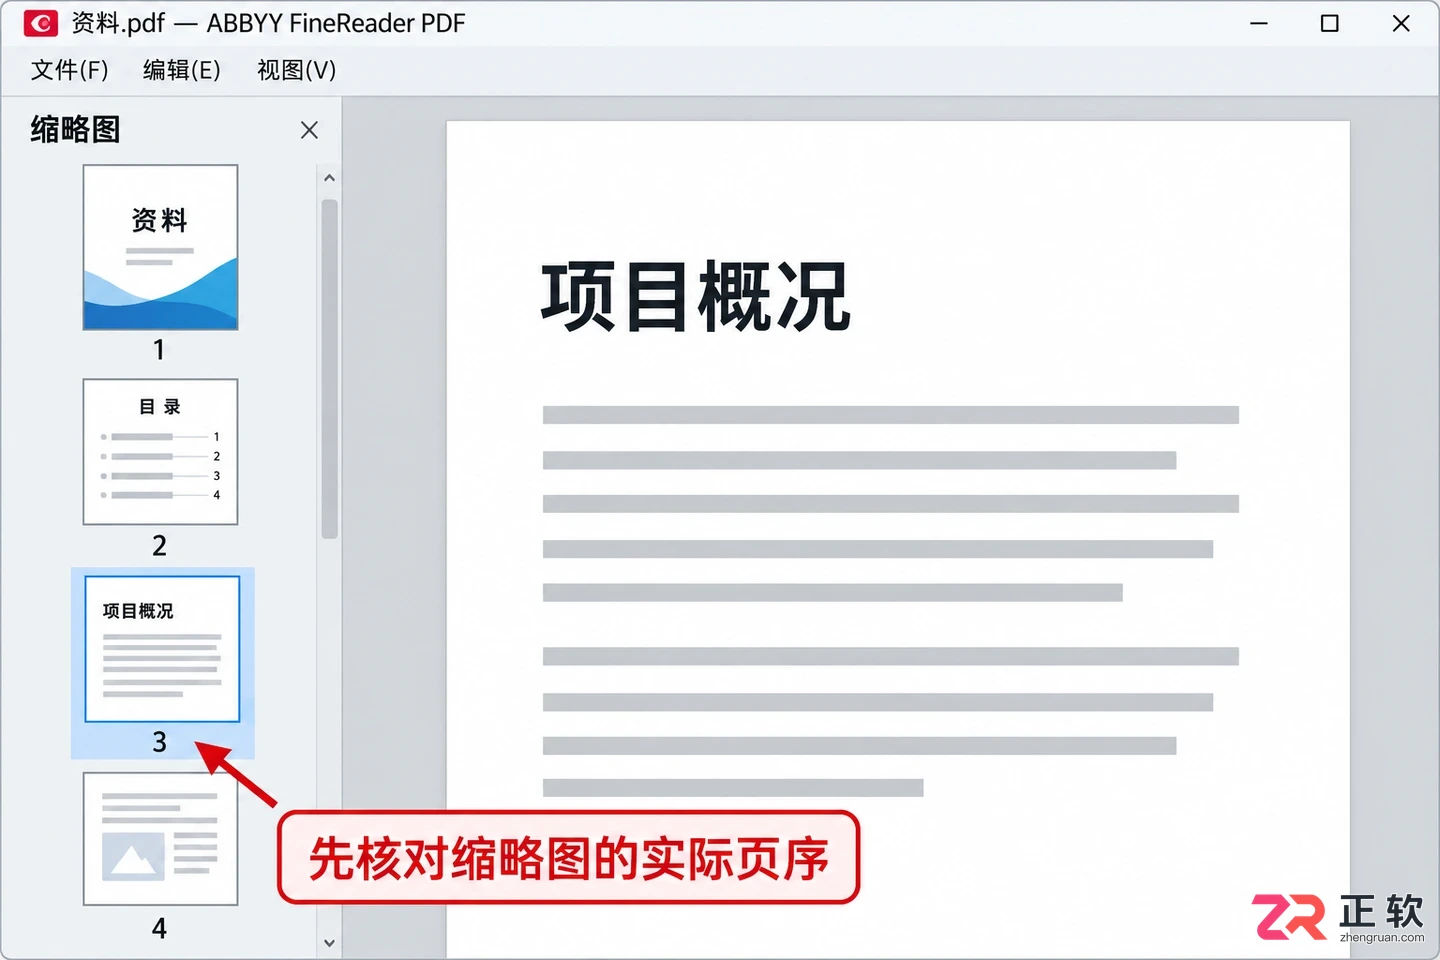
FineReader PDF 编辑器界面,左侧为页面缩略图,用于核对实际页序
以下操作以 Windows 版 ABBYY FineReader PDF 16 为例,先演示如何提取第 3 至第 5 页,再展示如何将一份 23 页的文档按每份最多 10 页进行批量拆分。
1. 打开 PDF 并核对实际页面顺序
启动 FineReader PDF,在【主页】点击【打开】加载目标 PDF 文件。进入编辑器后,左侧通常会显示页面缩略图面板。如果未显示,可在【视图】菜单中开启【缩略图】。
在开始选择页面前,务必滚动浏览确认页面的实际物理顺序。文档中的印刷页码(如罗马数字目录、封面)往往与软件识别的第 1 页、第 2 页不一致。例如,用户眼中的“第 3 页”可能是软件序列中的第 5 页。选中页面前,请双击缩略图查看具体内容,避免因页码偏移导致提取错误。
若文档受密码保护或限制编辑,需先输入正确密码获取权限。对于带有数字签名的文件,拆分后的新文件将不再包含原始签名效力,操作前请确认合规性。
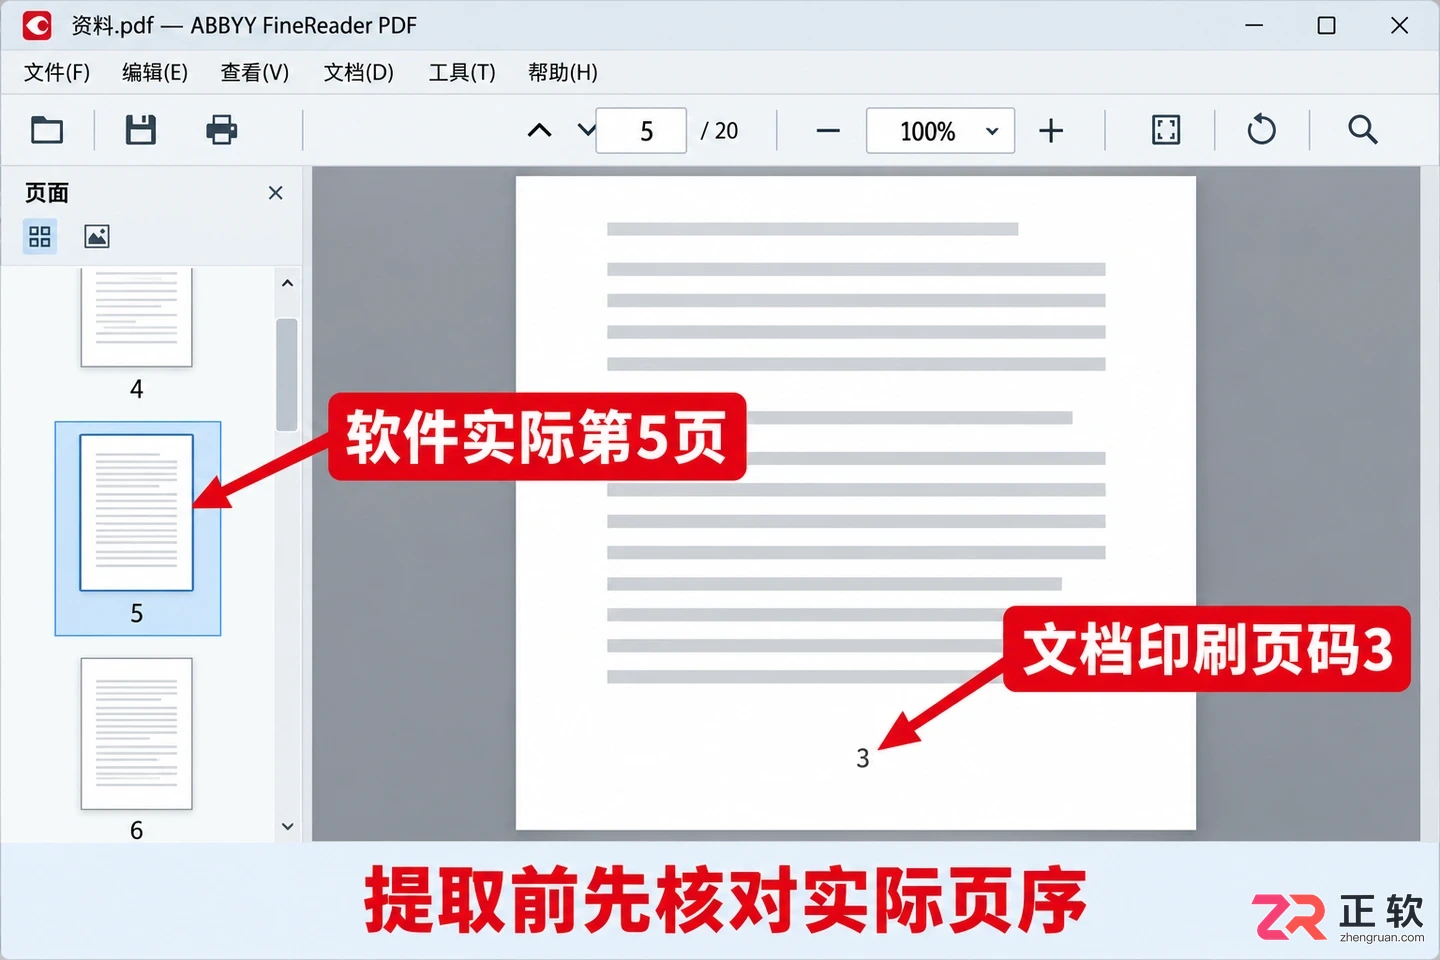
1. 打开 PDF 并核对实际页面顺序
2. 选中指定页面并创建新 PDF
假设需要提取实际顺序的第 3 至第 5 页:
- 在左侧缩略图面板中,单击选中第 3 页。
- 按住键盘上的 Shift 键,单击第 5 页。此时第 3、4、5 页应全部处于高亮选中状态。
- 若需选择不连续的页面(如第 1、3、7 页),则按住 Ctrl 键逐个单击。
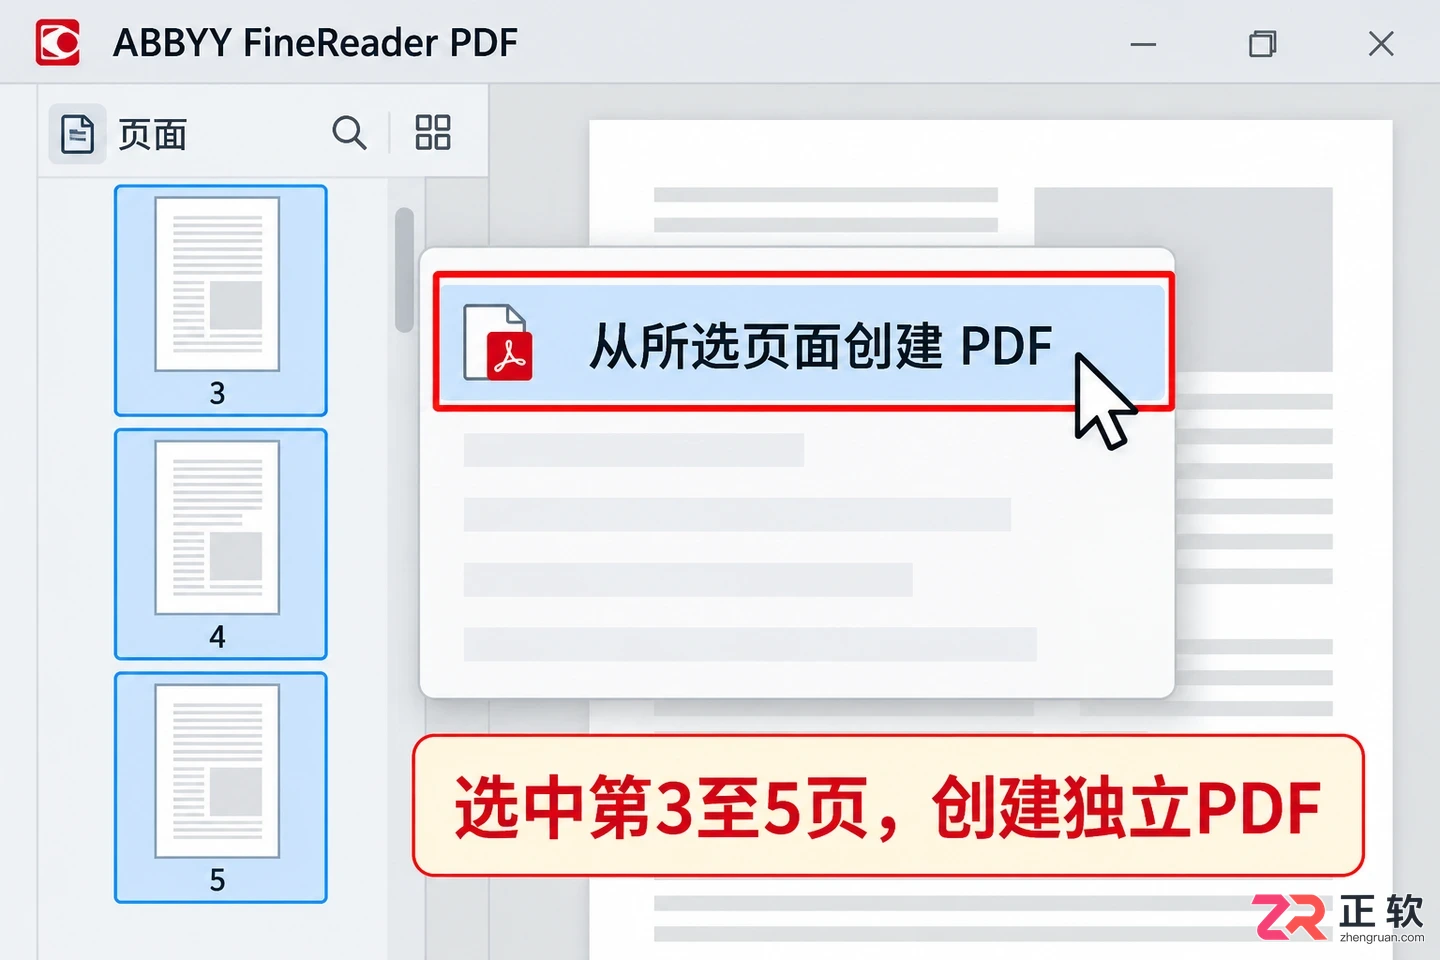
右键菜单中选择“从所选页面创建 PDF”
保持选中状态,在任意被选中的缩略图上点击鼠标右键,选择【从所选页面创建 PDF】(Create PDF from Selected Pages)。系统会在一个新的 FineReader 窗口中打开仅包含这三页的新文档。
检查新窗口中的内容无误后,点击【文件】>【保存】,将其命名为“资料_第3至5页.pdf”。此过程直接生成新文件,无需对原文档进行任何删除或修改操作。
3. 使用“拆分文档”功能批量分卷
当需要将整份文档(例如 23 页)拆分为多个小文件时,回到原始 PDF 窗口。点击顶部菜单栏的【组织页面】(Organize Pages),在工具栏中找到并点击【拆分文档】(Split Document)。
注意区分“拆分文档”与扫描功能中的“拆分对开页”。前者是将多页 PDF 切割为多个独立文件,后者是将单张扫描图中的左右两页分开。此处应选择前者。
在弹出的拆分设置窗口中,FineReader 提供了三种拆分依据:
- 按文件大小:适合有邮件附件体积限制的场景。
- 按页数:适合统一分卷,如每 10 页一个文件。
- 按顶级书签:适合结构清晰、已预设书签的文档。
本例选择【按页数】(By page count)。
4. 设置拆分参数与输出路径
在【按页数】选项下,输入【页数】(Page count)为 10。这表示每个新生成的 PDF 文件最多包含 10 页。
对于一份 23 页的文档,系统将自动将其拆分为三个文件:
- 文件 1:第 1-10 页
- 文件 2:第 11-20 页
- 文件 3:第 21-23 页
在【文件名】设置区域,建议添加前缀和编号格式(如“报告_部分_01.pdf”),以便后续识别顺序。点击【更改】按钮,选择一个空的专用文件夹作为输出目录,避免与原有文件混淆。
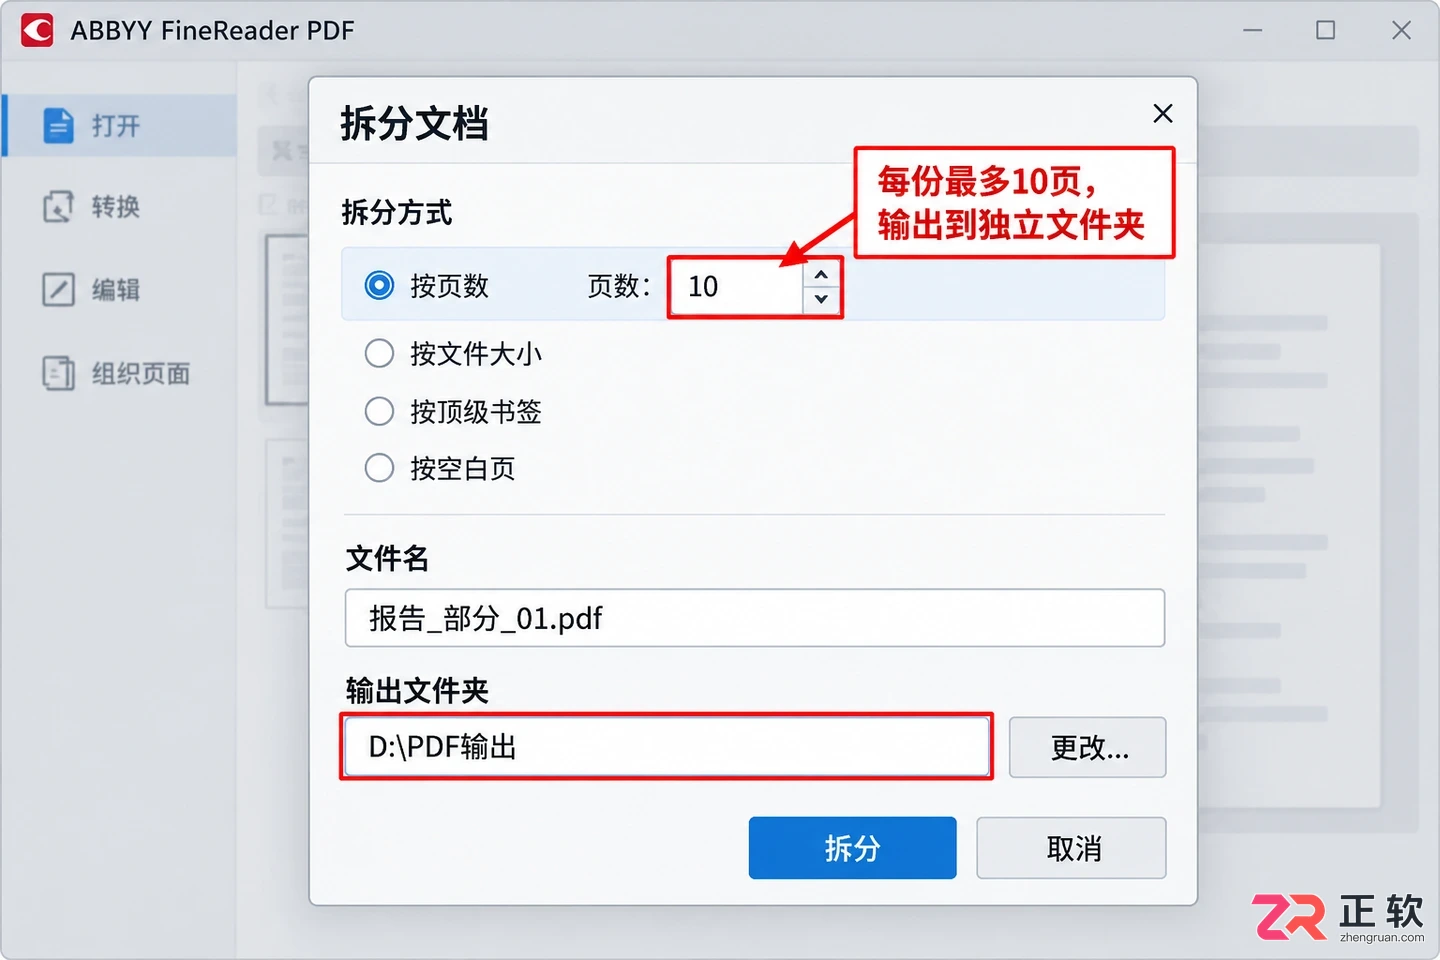
设置按页数拆分,每份最多10页,并指定输出文件夹
确认设置无误后,点击【拆分】(Split)按钮。处理完成后,系统通常会自动打开输出文件夹。
5. 验证拆分结果与注意事项
拆分结束后,需重点检查以下两点:
- 页面完整性:逐个打开生成的文件,核对总页数是否符合预期(10+10+3=23),并确保没有漏页或页序颠倒。
- 附件与书签:按页数拆分时,原始文档中的书签结构不会保留到新文件中,嵌入的附件会被提取并保存在输出目录下的“Attachments”文件夹中。如果原文档依赖书签导航,拆分后的文件将失去该功能,需手动重新建立或改用其他分发方式。
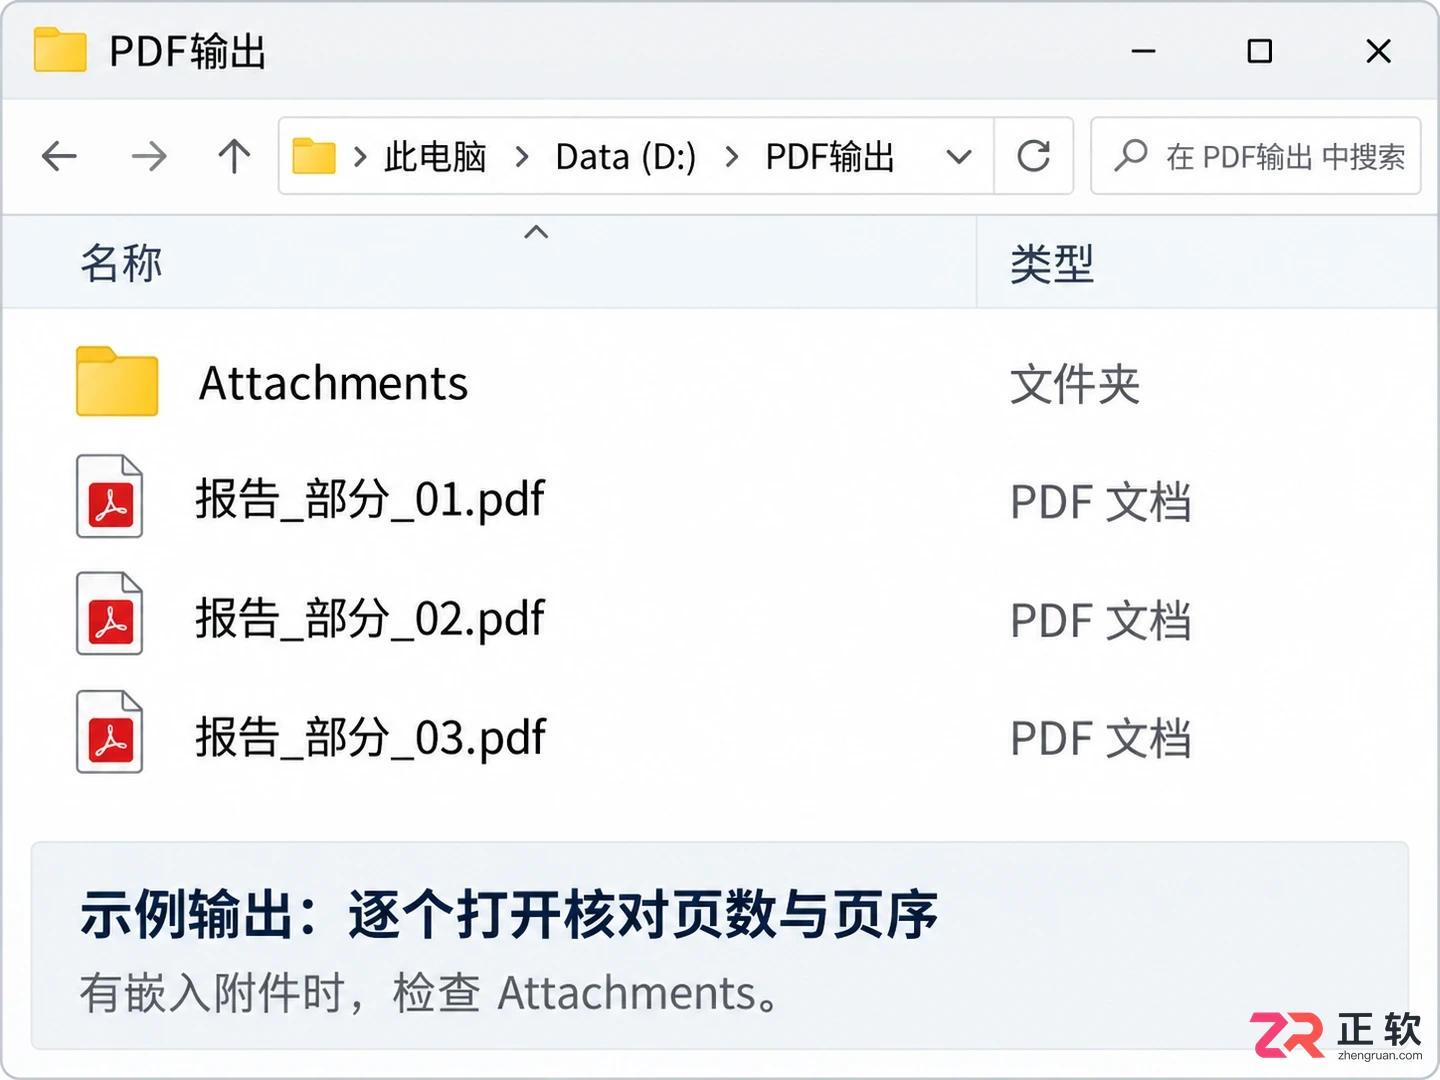
输出文件夹中生成的拆分文件及附件目录
最后,请记住拆分操作不涉及 OCR 文字识别。如果原 PDF 是扫描图片型,拆分后的文件依然是图片型,若需搜索文字,仍需单独执行 OCR 识别。保留好原始文件及输出清单,即可安全完成 PDF 的页面提取与分卷工作。
不知道QQ邮箱收件人该填QQ号还是邮箱?本文教你正确填写完整邮箱地址,避开全角符号和空格陷阱,掌握多人发送时的分隔技巧与密送用法,让邮件精准送达。
学习如何在Vue项目中设置文件上传格式限制。本文介绍使用HTML accept属性进行基础过滤,以及结合JavaScript进行严格后缀名校验的方法,确保只允许指定类型的文件被上传。
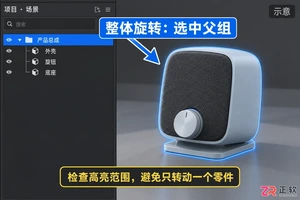
学习如何在KeyShot Windows版中正确旋转3D模型。掌握移动工具的全局与局部轴切换、位置面板数值输入及旋转中心调整,避免模型绕远点旋转或零件错位,实现精准的产品姿态控制。
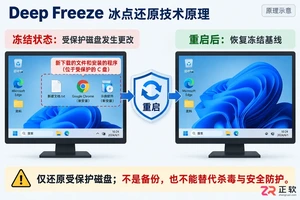
新手指南:如何在 Windows 上正确安装和配置冰点还原(Deep Freeze)。涵盖冻结磁盘选择、管理密码设置、重启还原验证及安全的解冻维护流程,确保系统稳定且数据不丢失。
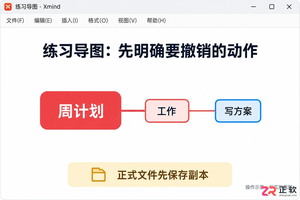
掌握Xmind Windows版的撤销技巧:使用Ctrl+Z撤回误删主题,Ctrl+Shift+Z重做恢复。本文通过实例演示操作步骤、焦点判断及快捷键自定义检查方法,避免数据丢失。
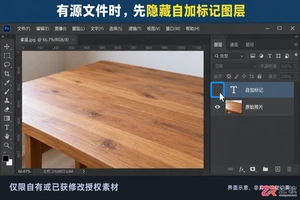
学习如何在Windows版Photoshop中去除图片上的文字标记或水印。教程涵盖检查源文件、使用内容识别填充新建图层、仿制图章修整接缝及最终验证导出,适用于背景相对简单的自有图片处理。
想知道即梦AI数字人怎么生成口播视频?本文详解从准备授权人物图片、录制本地音频,到上传素材、设置动作提示词及检查口型同步的完整操作步骤,助你高效制作自然的数字人讲话视频。
文章从PDF.cn在线解锁、本地PDF编辑器处理、已知权限密码后移除安全设置三条路线展开,分别说明上传与密码输入、桌面端打开与另存、安全菜单检查及结果复核,并对适用场景、限制和选择条件进行对照,帮助按文件敏感度、数量和密码掌握情况选择更稳妥的PDF取消密码保护方式。
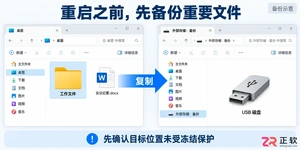
掌握冰点还原(Deep Freeze)在Windows下的正确解冻方法。区分“下次启动解冻”与“持续解冻”的应用场景,学习如何通过快捷键进入管理界面、设置重启次数、验证状态并恢复保护,避免数据丢失与维护失误。
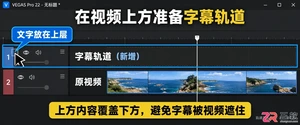
学习如何在 VEGAS Pro 中使用 Titles & Text 插件添加中文硬字幕。涵盖轨道创建、字体样式调整、时间轴对齐及渲染输出 MP4 的完整步骤,适合短视频固定字幕制作。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



