

DeepSeek-V4-Flash是什么和V4-Pro有什么区别
DeepSeek-V4-Flash是V4系列中强调速度、吞吐量和成本的轻量模型,V4-Pro则面向复杂推理、Agent和工具调用任务。本文结合当前模型路由,说明两者在能力、速度、上下文、API名称和适用场景上的区别。
DeepSeek-V4-Flash是V4系列中强调速度、吞吐量和成本的轻量模型,V4-Pro则面向复杂推理、Agent和工具调用任务。本文结合当前模型路由,说明两者在能力、速度、上下文、API名称和适用场景上的区别。
DeepSeek-V4-Flash是什么,当前还能直接调用吗?
DeepSeek-V4-Flash是V4系列中的高速度、低成本模型,当前旧名称仍可调用,但官方已经将其兼容路由到更新的V4.1-Flash。
DeepSeek在2026年4月发布V4系列时,将Flash定位为快速、经济的版本,将Pro定位为能力更强的版本。到了2026年10月,官方网页和App已经升级到V4.1-Flash-1017;API中推荐使用 deepseek-flash 获取当前Flash模型。
因此,“V4-Flash”现在既可以表示最初的V4 Flash型号,也可能被用户用来泛指当前Flash路线。写代码时不要只看旧教程,应该先请求模型列表,确认账号当前能看到的模型ID。
V4-Flash和V4-Pro在速度、能力和功能上有什么区别?
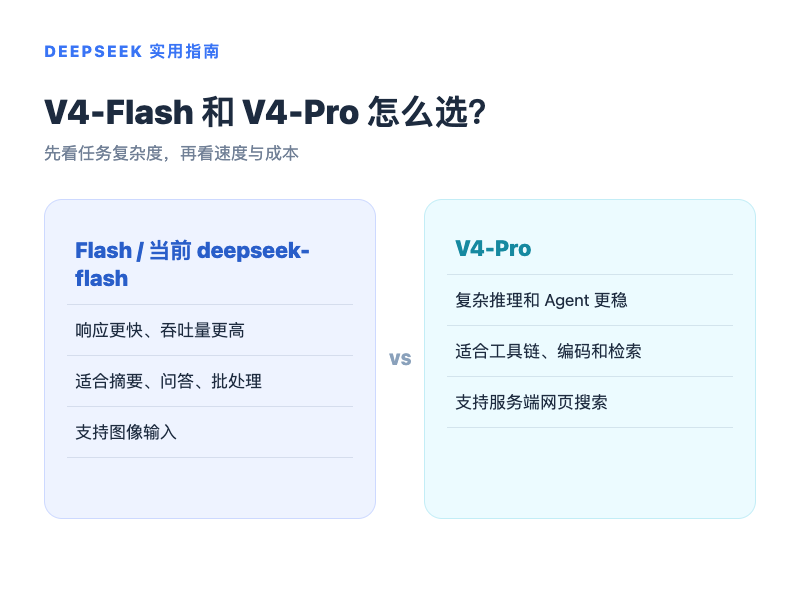
两者最核心的区别是任务取向:Flash优先速度和单位成本,Pro优先复杂推理、Agent执行和工具能力。
| 比较项 | V4-Flash / 当前Flash | V4-Pro |
|---|---|---|
| 主要定位 | 快速响应、高吞吐、经济调用 | 复杂推理、Agent和生产任务 |
| 常见场景 | 摘要、分类、普通问答、批量生成 | 复杂编码、长流程工具调用、深度分析 |
| 上下文 | V4系列官方服务均以百万级上下文为核心能力 | 同属V4系列,适合更复杂的上下文任务 |
| 图像输入 | 当前 deepseek-flash 支持图像输入 | 官方文档中V4-Pro主要处理文本任务 |
| 网页搜索 | Responses API下不作为服务端网页搜索模型 | Responses API可使用服务端web_search工具 |
日常问答和复杂Agent任务分别应该选哪个模型?
日常问答、内容整理和高并发任务优先选Flash,复杂编码、工具链和结果错误成本较高的任务优先选Pro。
- 大量短请求:先用Flash,减少等待时间和调用成本。
- 复杂代码仓库:先用Pro,并提高推理强度后再评估结果。
- 图像理解:选择当前deepseek-flash,因为官方文档明确列出了图像输入能力。
- 服务端网页搜索:选择V4-Pro,并按Responses API的工具格式配置。
如果业务无法预判难度,可以先让Flash完成分类或初稿,再把低置信度、复杂工具调用和关键决策转交Pro。这样比所有请求都固定使用Pro更容易控制速度和费用。
旧版V4-Flash代码怎么改才不会调用错模型?
旧代码应把模型名改为当前推荐的deepseek-flash,并在程序启动时读取模型列表,而不是永久写死旧版本名称。
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

models = client.models.list()
print([item.id for item in models.data])

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "用三点概括这段材料"}],
)
print(response.choices[0].message.content)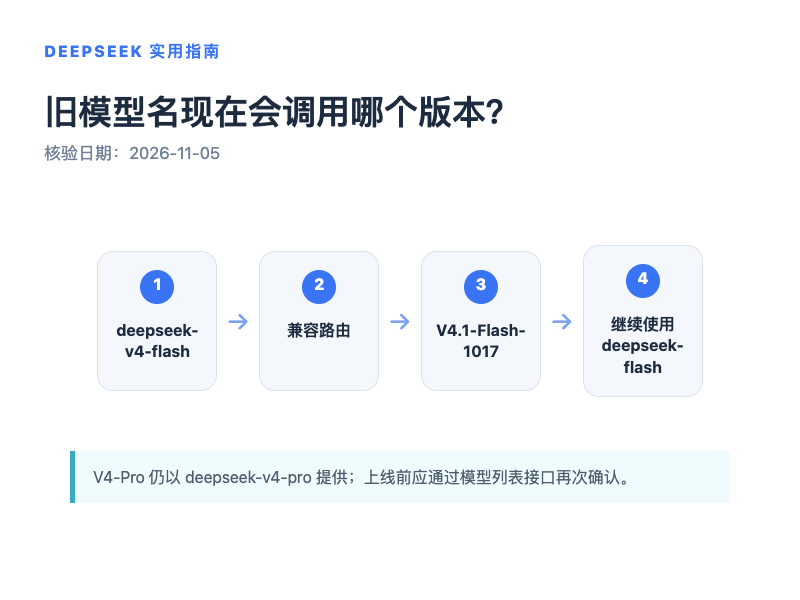
程序上线前还应检查输入模态、推理强度和工具支持,而不能只根据模型名称推断能力。模型路由会更新,模型列表接口和官方更新日志才是最终依据。
选择V4模型时还需要注意哪些问题?
V4-Pro一定比Flash回答得更好吗?
不一定。简单摘要、分类和短问答使用Pro可能只增加等待和成本,应该用同一组业务样本比较正确率与响应时间。
模型名称不变是否代表底层版本不变?
不代表。兼容模型名可能被官方路由到更新版本,生产系统应记录返回的模型信息并定期查看更新日志。
V4开放权重是否等于可以低成本本地运行?
不等于。还要评估许可证、显存、推理框架、量化精度和运维成本,不能只根据“开放权重”决定部署。
模型选择错误怎么快速发现?
先检查简单请求是否延迟过高,再检查复杂任务是否频繁失败;排查时固定输入和参数,分别记录超时、错误结果和重试次数,才能判断是模型选择问题还是业务代码问题。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
本周AI领域热点集中在DeepSeek编程效率、可灵30秒视频生成及特斯拉Roadster飞行演示。本文不罗列参数,而是从普通用户视角出发,分析如何正确评估编程助手的真实成本、视频生成的控制能力以及硬件展示的落地限制,助你透过现象看本质。
了解如何在 Codex 中通过 CC Switch 添加和配置第三方模型供应商。本文详解 API Key、请求地址及模型参数的设置方法,明确接入前提与注意事项。
本文纠正DeepSeek需要下载安装的常见误解,提供官方网页版直接访问方法,并介绍适合开发者的API集成方案,帮助用户高效使用DeepSeek大模型。
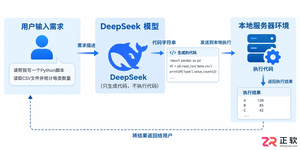
了解DeepSeek模型如何处理代码任务。本文详解通过API接入、提示词优化及本地环境配合,实现脚本生成与自动运行的具体步骤,避免对模型功能的误解。
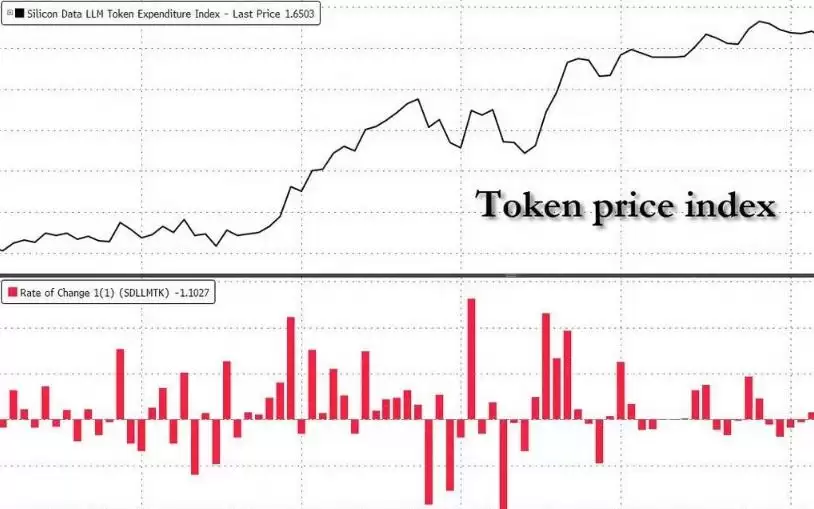
微软考虑以中国开源模型DeepSeekV4替代OpenAI等昂贵模型,以应对成本压力。高盛提出“价值万亿的问题”:更低智能成本是创造需求还是摧毁定价权?Token价格持续下跌,行业转向多模型灵活调配。
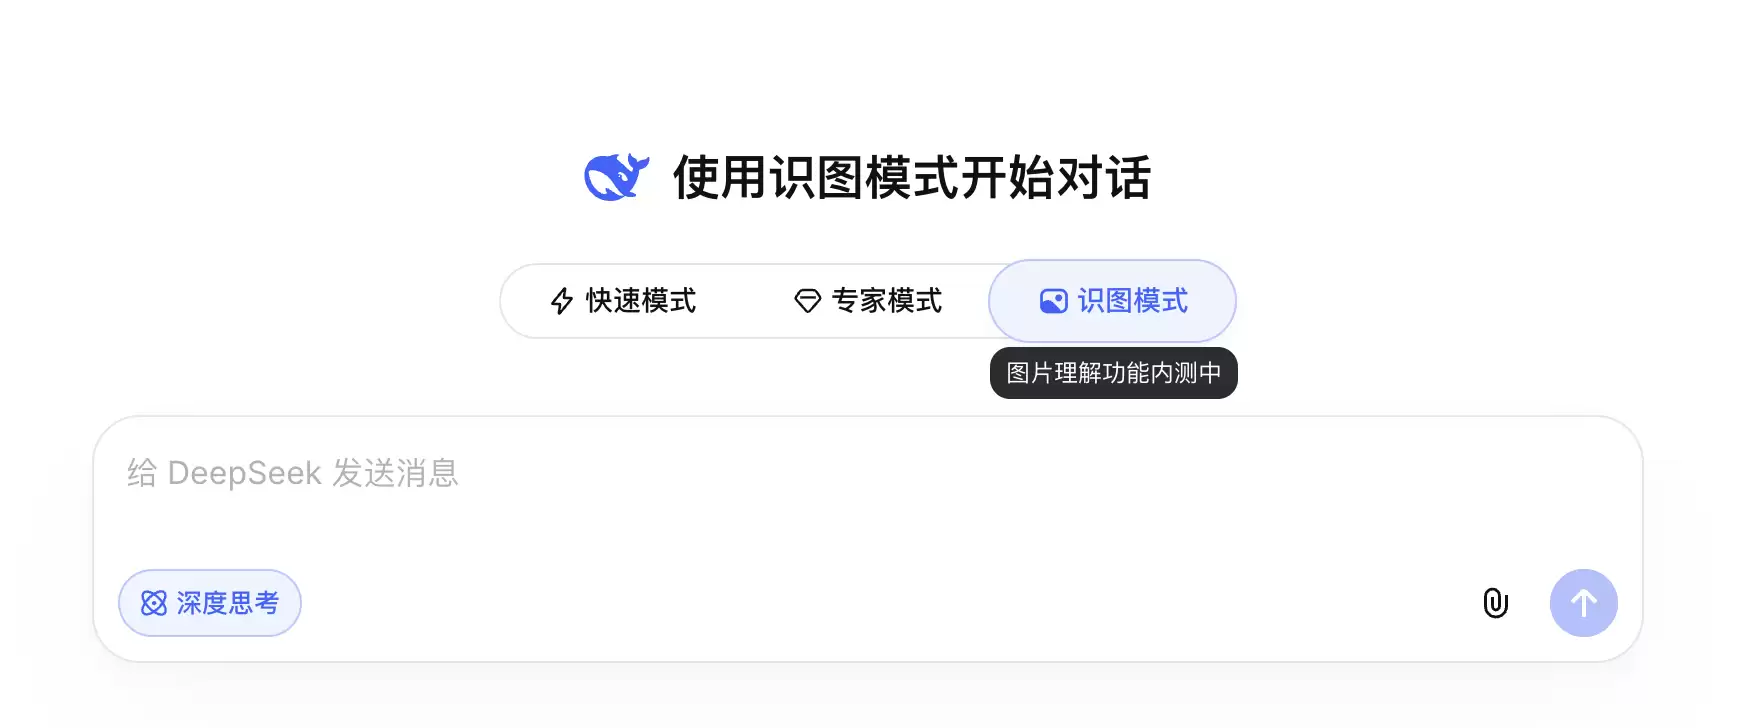
DeepSeek识图模式疑似面向所有用户全量上线,新增识图模式。实测能识别建筑场景,准确指出外滩建筑与拱桥;但无法识别冷门人物如佛得角守门员。此前测试中可辨认“绿色鸭腿”非鹅腿并提示隐患。用户反馈其识图能力超国产平均,与海外顶级模型尚有差距。官方尚未正式宣布上线。
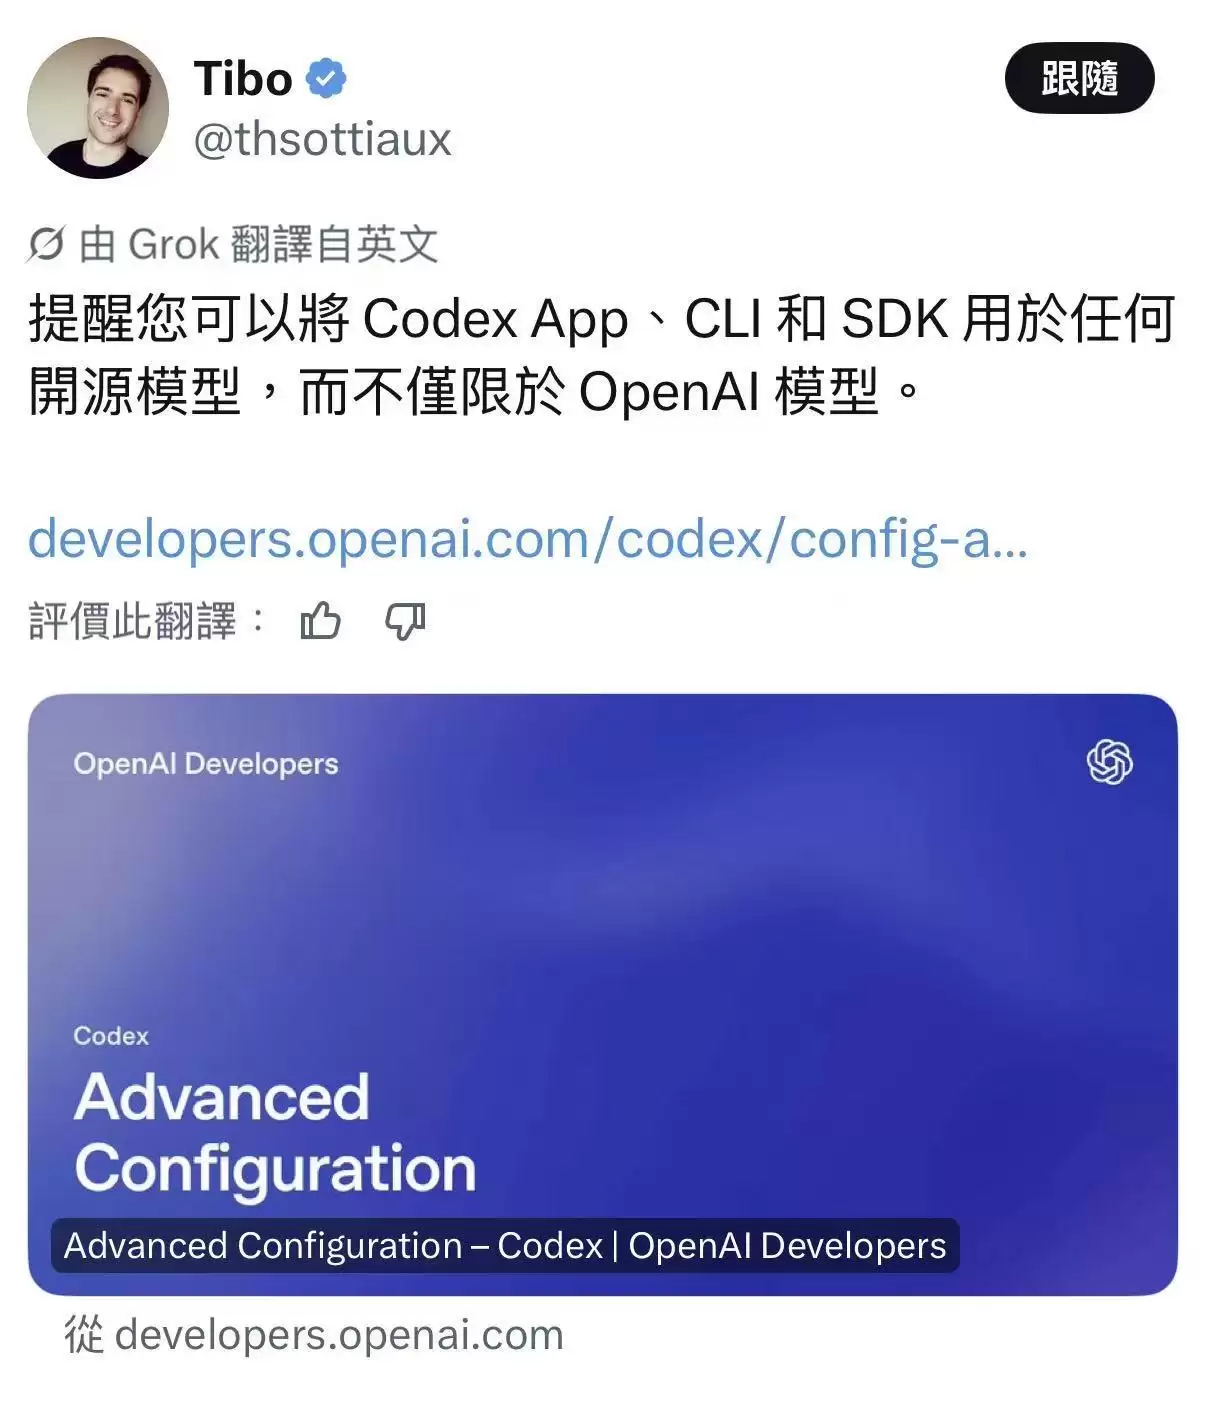
OpenAICodex开放第三方模型接入,但实际门槛较高。当前仅支持ResponsesAPI协议,国产模型如DeepSeek需通过本地转接桥才能使用,速度较慢但成本极低。这一开放为国产模型提供成熟工作台,但OpenAI仍控制关键标准,开放程度有限。
DeepSeek内测的“识图模式”将自家创始人梁文锋反复误识别为字节跳动张一鸣,且自信断言“百分百确定”。被指出错误后,模型陷入混乱,接连给出张小龙、王兴等答案。DeepSeek解释其不具备真正人脸识别能力,仅读取图片文本。与此同时,市场传出该公司完成超500亿元首轮融资。
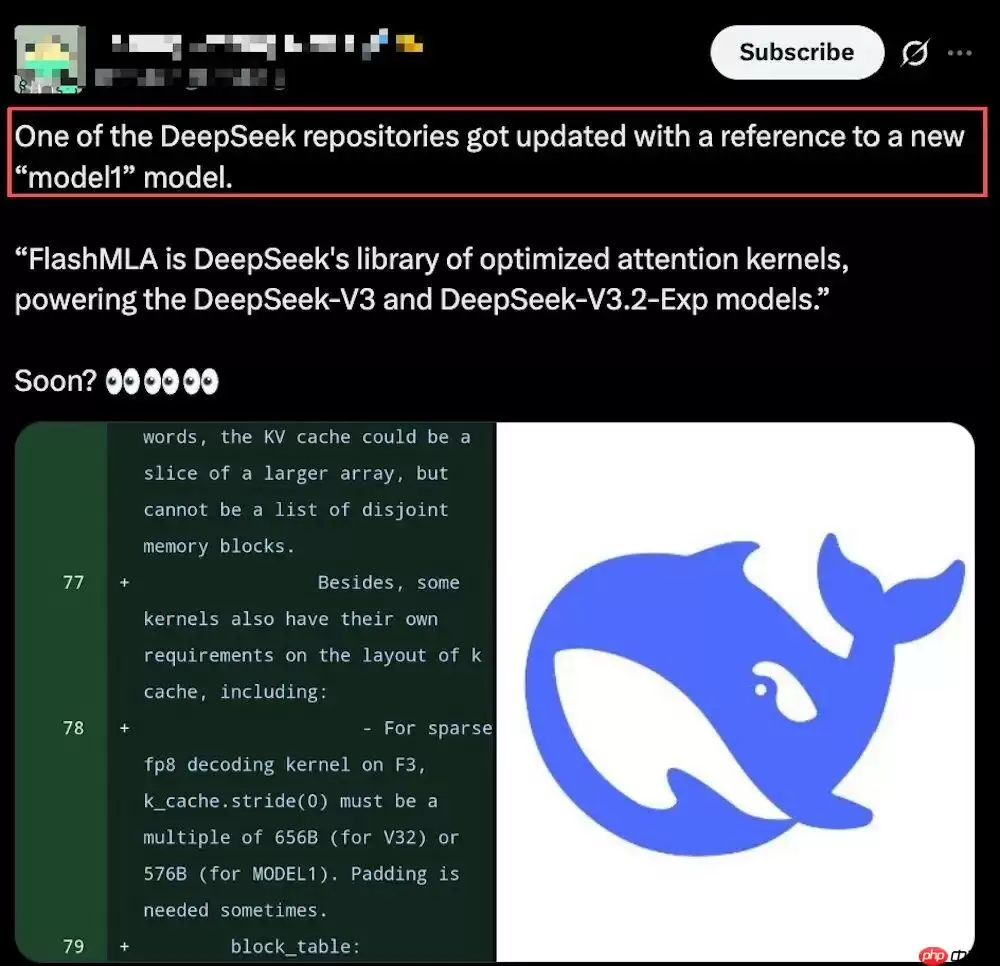
DeepSeek为FlashMLA引擎推送代码更新,出现新模型代号“MODEL1”,在114个文件中被引用28次,常与V32并列或区分。其键值缓存、稀疏注意力及FP8支持等底层技术路径与现有架构存在差异,可能代表一条独立于V系列的全新模型路线。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



