

Google Cloud可靠性Skill 1.1.0如何区分故障恢复、数据恢复与复盘?
Google Cloud可靠性Skill 1.1.0分别询问故障恢复测试、数据恢复测试和事故复盘;备份、切换能力与真实测试结果不能混为一谈。
Google Cloud可靠性Skill 1.1.0把故障恢复测试、数据丢失恢复测试和事故复盘作为不同的评估方向:前者关注系统从故障中恢复,第二项关注数据丢失后的恢复能力,复盘则关注事故之后是否形成可持续的改进。完成其中一项,不能自动证明另外两项也已经落实。
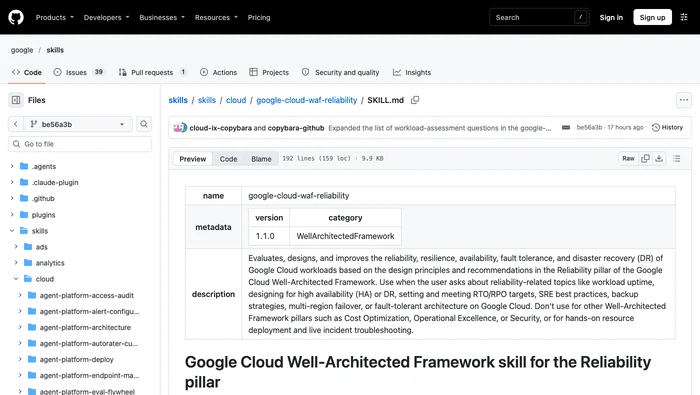
故障恢复测试关注什么?
在1.1.0的问题清单中,故障恢复测试要了解测试进行得多频繁、覆盖得多全面。地域故障转移和版本回滚被列为例子,说明评估不仅关心日常服务是否运行,也关心故障发生后,恢复机制是否真正经过验证。
这项Skill没有在问题清单里规定所有组织统一采用的演练频率。评估需要先了解业务目标、工作负载要求与组织约束,不能替用户填出一个没有依据的测试周期,也不能把“架构支持故障转移”写成已经完成一次真实切换演练。
数据恢复测试为什么不能由备份记录代替?
可靠性原则要求定期测试备份与恢复流程,以验证数据损坏或丢失后的恢复能力,并与RTO和RPO目标对应。保存了备份,并不等于恢复流程的有效性已经得到验证。
1.1.0在发现问题中单独询问组织如何测试数据丢失恢复。验证清单也把定期备份与常规恢复测试一起列出。两者的联系在于,评估既要了解有没有备份机制,也要了解恢复测试实践,而不是仅凭某个存储产品或备份计划的名称得出可靠性结论。
| 评估方向 | 需要区分的事实 |
|---|---|
| 故障恢复 | 机制可以设计,与地域切换、回滚是否经过测试不同 |
| 数据恢复 | 备份可以存在,与恢复过程是否验证过不同 |
| 事故复盘 | 会议可以召开,与经验是否落实成系统变化不同 |
复盘需要回答的不只是事故经过
Google Cloud可靠性Skill 1.1.0询问组织怎样开展并利用事故复盘,还要求了解近期复盘带来了哪些关键经验或系统变化。这把关注点从“已经写了报告”推进到“是否形成组织学习与实际改进”。
Skill强调无责文化与根因调查,并通过后续措施减少相同问题再次发生的可能。这里没有保证复盘能消除所有故障,也没有要求用户虚构某次事故案例;评估应基于真实运行记录与已经发生的变化,缺少信息的部分不能被写成已完成。
这三个方向何时足够,何时仍不够?
如果任务仅围绕灾难恢复或复盘开展专项询问,1.1.0允许从清单中选择相关问题。但对整个工作负载作全面可靠性评估时,必须覆盖全部核心原则,并纳入每个原则下的完整问题集,还包括用户体验、SLO、冗余、水平扩展、可观测性和优雅降级等方向。
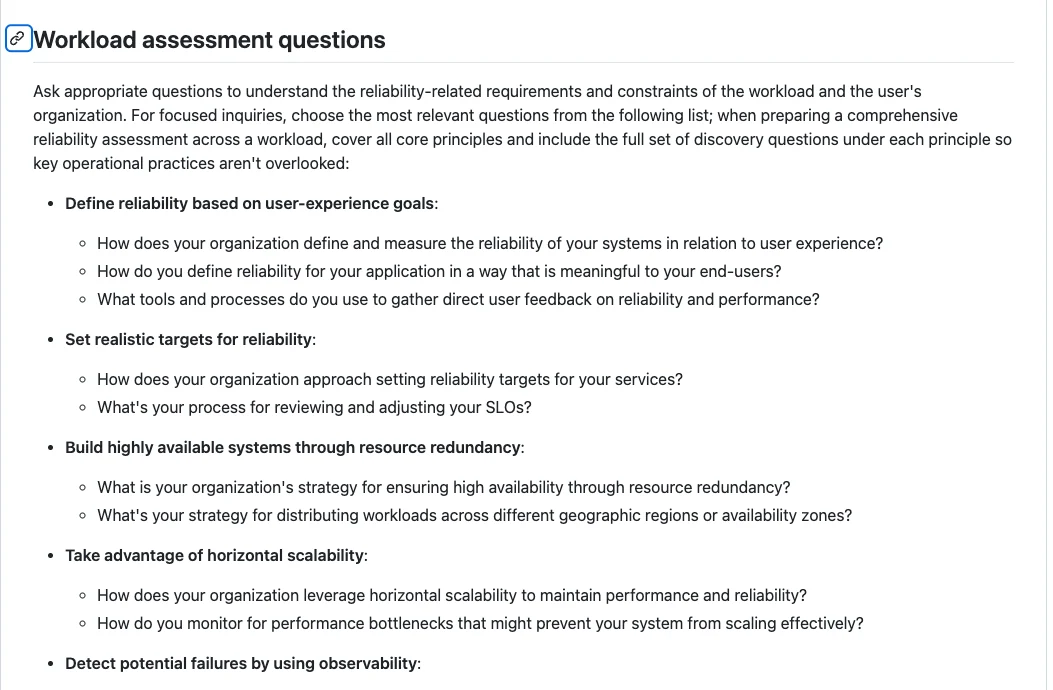
这项Skill用于Google Cloud可靠性架构的评估与设计讨论,不用于直接部署资源或实时事故排查,也不覆盖其他框架支柱。测试、恢复和复盘在文章中是需要核对的实践方向,不代表安装Skill之后会自动执行这些操作或自动获得云端权限。
面向需要在AI编程助手中使用Last30Days Skill的用户,本文详解在Claude Code及Cursor、Codex等宿主环境中的安装方法。针对Python 3.12+环境准备不足、安装路径混淆导致技能无法识别等痛点,提供官方插件命令与npx全局安装两种方案。涵盖环境检查、具体执行指令、多宿主适配参数及更新维护步骤,帮助用户快速完成技能部署并验证可用性。
面向需要配置Scientific Agent Skills的用户,解决无需启用全部177个技能的痛点。本文介绍如何先在官方目录确认技能名称及兼容性,再通过GitHub CLI或npx安装器执行单技能安装命令。以scanpy为例,说明保留完整技能目录结构、配置Python 3.12+环境及验证调用的具体路径,确保仅加载当前任务所需的脚本和依赖。
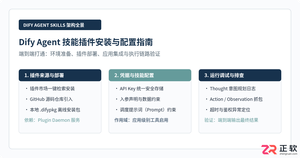
本教程针对 Dify 平台详细讲解 Agent Skills 插件的安装准备、来源安装方式、凭据配置以及在智能体应用中的调用与调试全流程。

随着人工智能和机器学习的发展,许多企业和个人希望能够利用这些技术来优化其流程和决策。然而,机器学习需要大量的数据和计算资源来运行,在过去这往往是一项昂贵的和耗时的任务。随着云计算和自动化机器学习工具的发展,现在有许多平台可以使这个过程更加容易、高效和经济实惠。在本文中,我们将介绍如何使用PHP和GoogleCloudAutoML,一个自动化机器学习平台,
随着云计算的普及,云缓存作为一种重要的技术手段,也受到了越来越多企业的青睐。在众多云缓存提供商中,GoogleCloudMemorystore作为GoogleCloudPlatform(GCP)的一部分,是一个强大而易于使用的云缓存产品。本文将为您介绍GoogleCloudMemorystore缓存技术,帮助您更好地了解云缓存的概念、
随着视频媒体的越来越流行,视频内容的分析和处理已经成为了各个领域中一个非常热门的话题。随之而来的是对视频技术的需要,现有的视频处理工具也随之变得不再关注于视频内容的简单存储和展示,而关注于如何从视频中提取更多有用的信息和数据。在这个领域,GoogleCloudVideoIntelligence是一个非常强大和独特的工具,它可以帮助用户快速分析视频内容并
随着信息爆炸的时代到来,数据的使用和处理变得越来越重要。而流数据处理成为了处理海量数据的重要方式之一。作为一名PHP开发者,想必你也有过处理实时数据的经验和需求。本文将介绍如何使用PHP和GoogleCloudDataflow进行流数据处理和管理。一、GoogleCloudDataflow简介GoogleCloudDataflow是一款管理大规
随着语音交互的普及,语音识别和转换技术的重要性日益凸显。GoogleCloudSpeechAPI是一款强大的语音识别和转换工具,能够帮助开发者更方便地实现语音功能。本文将介绍如何在PHP中使用GoogleCloudSpeechAPI进行语音识别和转换,包括环境准备、使用步骤和注意事项等方面。前置条件在使用GoogleCloudSp
在PHP开发中如何使用GoogleCloudFirestore进行文档存储和查询随着云计算技术的不断发展,云服务已经成为了现代化应用程序开发的必要环节。GoogleCloudFirestore是谷歌推出的一项基于文档的NoSQL数据库服务,提供了实时数据库、离线数据同步、强一致性、自动化扩展、全球部署等优秀特性。本篇文章将主要介绍如何在PHP项目中使
随着全球化进程深入推进,企业面对的多语言、跨国界的交流需求日益增多。在PHP开发中,如何利用GoogleCloudTranslation进行多语言处理和翻译,将成为一个重要的问题。GoogleCloudTranslation是一项由Google提供的机器翻译服务。它基于深度学习和神经网络技术,能够高质量地进行文本翻译。这项服务已经被广泛应用于全球范围





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



