

提升Redis性能:网络、内存、磁盘优化及解决阻塞问题
Redis Assistant 是一款为Redis设计的高效可视化管理与监控工具,提供多种操作模式,高效处理服务器数据。日常使用里的持续防护和信息管理会更突出,适合把安全控制放进长期使用流程中的场景。
由于Redis是基于内存的操作,因此CPU并非其性能瓶颈。相反,服务器的内存利用率、网络IO和磁盘读写对Redis的性能起着关键作用。因此,我们将着重从网络、内存、磁盘和阻塞点等方面展开优化。如有术语不清楚,建议参考前几期的redis内容或查阅相关资料。网络优化如果是客户端请求服务端,也就是“请求-响应”模式下,尽可能的使用批量处理来减少网络IO的开销。批量处理的技术:原子性m批处理指令、pipline技术、redis、事务,lua脚本。批处理减少网络IO开销原子性m批量处理指令:string类型,推荐使
由于Redis是基于内存的操作,因此CPU并非其性能瓶颈。相反,服务器的内存利用率、网络IO和磁盘读写对Redis的性能起着关键作用。
因此,我们将着重从网络、内存、磁盘和阻塞点等方面展开优化。如有术语不清楚,建议参考前几期的redis内容或查阅相关资料。
网络优化
如果是客户端请求服务端,也就是“请求-响应”模式下,尽可能的使用批量处理来减少网络IO的开销。
批量处理的技术:原子性m批处理指令、pipline技术、redis、事务,lua脚本。
批处理减少网络IO开销
原子性m批量处理指令:string类型,推荐使用mget/mset代替get/set;hash类型,推荐使用hmget/hmset代替hget/hset。
pipline技术:在使用list、set和zset时有批量操作时可以使用pipeline技术。
redis事务:在特殊业务要求保证多个指令时推荐使用。
lua脚本:在需要保证多条指令原子性时推荐使用lua脚本,具体案例有分布式的解锁、秒杀和减库存。
节点间网络优化
在同一个局域网中搭建集群;
控制切分集群的节点数,redis实例上分配的哈希槽需要在不同实例之间传递,以及负债均衡实例删除时,数据会在不同实例之间传递。但哈希槽信息不大,而数据迁移是渐进式的,但不是主要的问题;
内存优化
控制key的长度:建议开发前先定义好规范,保证key在简单、清晰的前提下,尽可能把key按业务缩写。
杜绝bigkey:string类型的建议大小在20KB以内。hash、list、set和zset建议控制好阈值,推荐控制在5000以内。
key设置过期内:充分利用内存。
选择合适的数据结构
string类型,推荐使用整数型,它底层编码会选择整数型编码,内存开销小;
hash类型,推荐控制元素阈值,元素少时底层会用压缩列表数据结构,内存开销小;list类型,推荐控制元素阈值,元素少时底层会用压缩列表数据结构,内存开销小;set类型,推荐存储整数型,它底层编码会选择整数型编码,内存开销小;
zset类型,推荐控制元素阈值,元素少时底层会用压缩列表数据结构,内存开销小;
数据压缩:客户端在写入redis前可以采用snappy、gzip等压缩算法对数据压缩,减少内存占用,但客户端在读取数据后需要对数据做解压,会消耗更多的CPU。
开启内存淘汰策略
杜绝默认内存淘汰策略,请结合实际业务选择合适的淘汰策略,提高内存的利用率。
LRU:关注于访问次数,淘汰最近最少使用的key,使用场景比较广。redis的LRU采用一种近似LRU的算法,为key增加一个额外字段长度为24bit,为最后一次访问的时间戳。采取懒惰方式处理:当执行写入操作时如果超出最大内存就执行一次LRU淘汰算法,随机采样5(数量可设置)个key,淘汰掉最旧的key,如果淘汰后依旧超出最大内存则继续淘汰。
LFU:关注访问频率,在处理缓存污染时,推荐使用。
内存碎片优化问题
原因:一个是内存分配器的分配策略造成的,内存分配器是按照固定大小分配的,而不是按照实际申请的大小分配的,如申请字节以内,实际分配32字节;另一个是redis键值对删除之后会释放部分空间带来的内存碎片。
定位:通过指令INFO memory来观察men_fragmentation_ratio的指标;指标在1-1.5之间,则属于正常;指标大于1.5,则内存碎片率已经超过了50%,需要处理内存碎片了;
方案:重启redis实例;
开启redis自动内存碎片清理功能。
磁盘优化
物理搭建redis服务:持久化时,redis采用创建子进程的方式进行(会调用操作系统的fork系统),而虚拟机环境执行fork的耗时,要比物理机慢。
持久化优化机制
不开启持久化:redis只做缓存使用,则不需要开启持久化,减少磁盘的开销;
AOF优化:后台处理AOF,配置appenfsync everyec把数据持久化的刷盘操作,放到后台线程中去执行,尽量降低redis写磁盘对性能的影响;
不建高频率的做AOF持久化,AOF持久化默认频率是每秒1次,不建议修改这个配置,它已经能保证最多丢失1s数据了;
开启混合持久化,redis4.0支持混合持久化 RDB+增量的AOF;
开启多线程配置,在redis6.0之前,持久化都是通过主线程fork子进程处理持久化,但是fork都是同步阻塞,6.0之后支持多进程来处理持久化操作;
集群优化
slave做持久优化:master不做持久化,尽可能分摊master磁盘IO的压力;主从优化:增量模式,主从同步方式指定为增量模式,不会选择全量的RDB模式,全模式是一个非常消耗性能;采用级联同步模式,一主多从时,多个salve都来master这里同步数据,会直接拖跨master性能。
对于这个问题,redis支持级联同步的方式,即master只将数据同步给一个salve,然后其他的salve的数据都从这个salve同步,来缓解master压力。
实际大小建议不超过6G。实例太大会在主从同步会有卡顿现象,严重时会拖垮master。
在异常重启时会重放AOF,如果实例过大数据恢复会异常的缓慢。
阻塞点优化
分析:由于Redis处理请求和指令时是单线程,则它的性能瓶颈点是同步阻塞问题。
bigkey问题
危害:读写bigkey可能会导致超时,而redis是单线程操作数据,严重的会导致阻塞整个redis服务。而且一个key只会被分割到一个节点,无法分摊速写压力。bigkey探测:自带命令bredis-cli-bigkeys。redis自带指令,只能找出五种数据类型里最大的key,并没有太大作用,不是很推荐。python扫描脚本。可以定位到具体key,但准确度不高,不推荐。
rdb_bigkeys工具。go写的⼀款⼯具,时间执⾏快且准确度⾼,还可以可直接导出到csv⽂件,⽅便查看,推荐。
优化:对于⾮string类型bigkey,可以对元素集合进⾏分割,拆分成多个,如将⼀个bigkey拆分成1000个key,则key的后缀使⽤hash取模1000。
使用本地缓存,如redis里存放业务id+版本号,将具体内容放在本地缓存,每次查询先查redis缓存,再同本地缓存核对版本号。
优化bigkey一般都是伤筋动谷,推荐开发时就定义好规范,避免bigkey问题。
过期策略
定时删除:每过期key都给一个定时job,到期了就直接删除,内存利用率高,cpu占用高。惰性删除:当查询到key时,才判断key是否过期,如果过期则删除,cpu占用低,内存利用率。定期删除:每隔一段时间扫描一次,过期key直接删除,cpu和我内存利用率一般。
1.贪心策略。redis会将设置为过期key,单独放到一个字典中。
2.扫描过程。从过期字典中挑选出20个key,删除20个key中已过期的key。如果删除的key占比超过了1/4则重复步骤1。
基于以上逻辑为了解决循环过度导致线程卡死的现象,在算法上加上超时时间的机制,默认时间是25ms。
3.扫描频率:redis默认是每秒10次过期扫描。
redis默认是开启惰性删除+定期删除。
优化:开启lazy-free,释放内存的耗时操作,将会放到后台线程中去执行,redis4.0+支持。
开启多线程模式,在redis6.0之前过期策略都是主线程的同步操作,6.0之后采用多线程去处理。
复杂度高指令
推荐使用scan分批次查询,不要使用keys。不适用聚合操作:redis是单线程模型处理请求,在执行复杂度过高的命令(消耗更多CPU资源)时后面的请求会排队导致延迟,如SINTER、SINTERSTORW、ZUNIONSTORE、ZINTERSTORE等。推荐使用scan分批次查出集合中元素,在客户端做聚合计算。
容器类数据操作:当容器类元素非常多时,直接查询会存在由于网络为你导致的延迟,推荐分批次查询。
当容器类元素非常多时,直接删除key时有可能导致redis卡顿,推荐分批次删除。
想知道3ds Max安装需要多大内存和硬盘空间?本文列出官方最低与推荐配置,解析不同工作流下的硬件需求,助你避开性能瓶颈。

电脑安装了16GB内存却只显示15.8GB或更少?本文详解硬件保留、核显占用及系统设置导致的内存显示差异,提供从任务管理器到BIOS的完整排查方法。
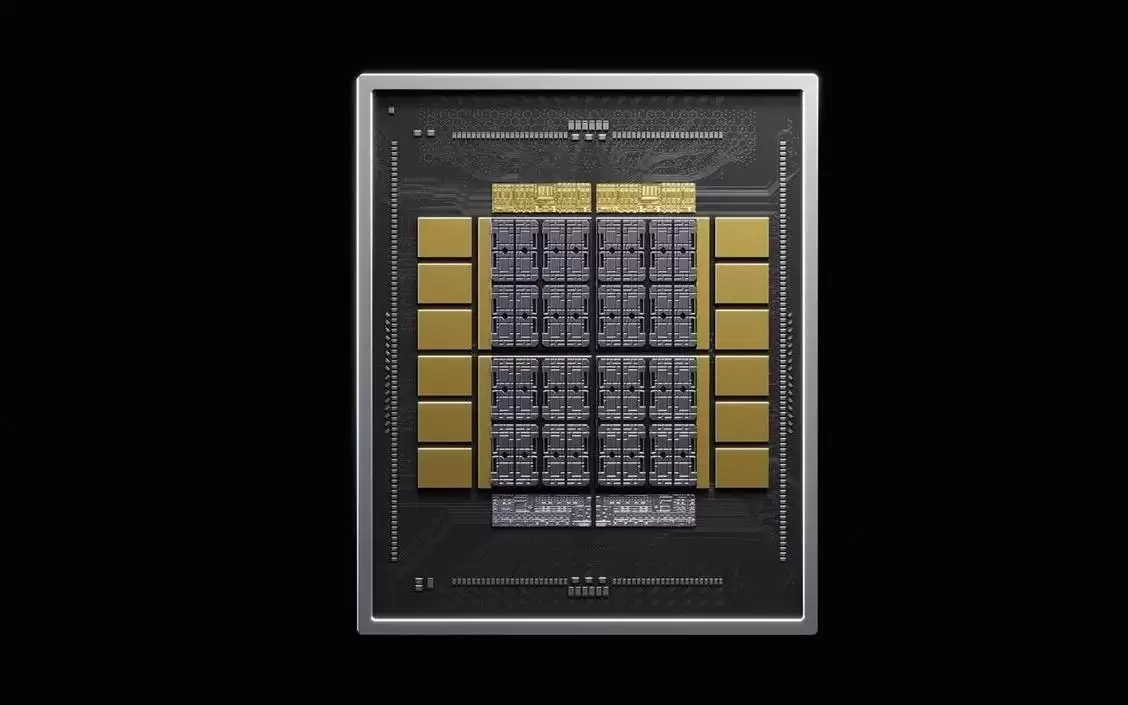
英伟达发布定制HBM技术NVHBM,通过集成内存控制器至HBM基础裸片,实现带宽较HBM4E提升30%、功耗降低15%,并释放主芯片25%空间。亚马逊Annapurna Labs为首个合作伙伴,该技术旨在通过标准化方案加速定制AI芯片开发,而非取代通用HBM。
AMD因用户强烈反弹,将为消费级Ryzen处理器恢复TSME内存加密功能。此前该功能被AGESA微码悄然关闭,仅保留在PRO等高端产品线,而英特尔竞品仍开放类似功能。AMD将通过UEFI固件更新,自2026年7月起由主板厂商发布BIOS恢复该选项。
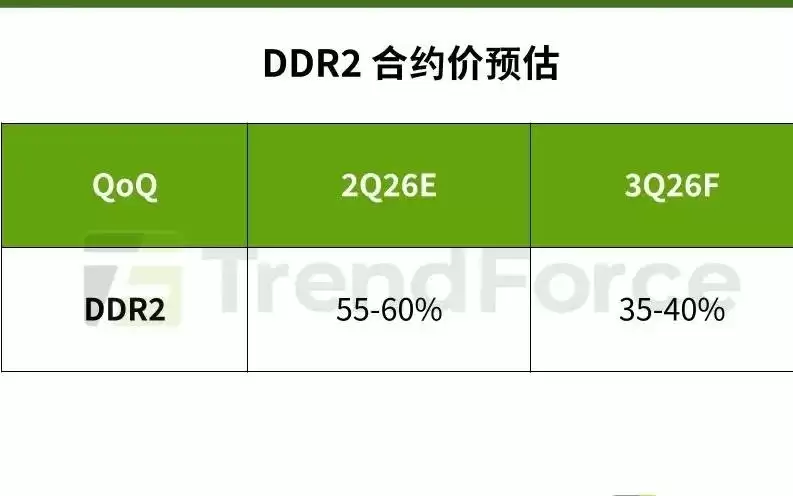
消费级DRAM供给紧缩,三大原厂优先HBM与服务器内存,DDR4投片缩减。需求转向DDR2/DDR3,DDR2合约价二季度涨55%-60%,三季度再涨35%-40%。品牌厂与ODM厂降级使用,缺货压力向下传导。
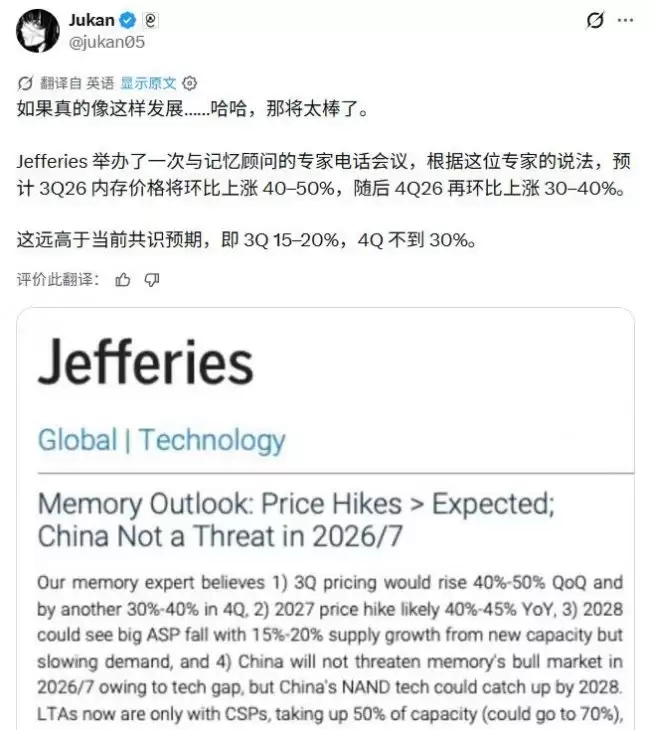
杰富瑞研报预测,2026年Q3全球存储芯片价格环比涨40%-50%,Q4涨30%-40%,2027全年均价同比涨约40%-45%,降价或始于2028年,届时跌幅15%-20%。
二手交易平台出现大量低价假DDR5内存,号称SK海力士16GB仅售179元。拆解发现颗粒内部为空壳,无硅芯片,仅靠胶水与焊锡伪装。上机无法通过自检,可能损坏其他硬件。提醒存储芯片涨价期间,切勿贪图便宜。
央视报道,深圳华强北内存条价格近期暴涨,DDR5单条两天内涨约300元,DDR4涨幅温和。存储成本占整机物料已从15%升至30%以上,高端机型超35%,行业利润逻辑面临调整。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



