

Google推出"Vlogger"模型使得一张图片能够生成10秒视频
谷歌发布了一个新的视频框架:只需要一张你的头像、一段讲话录音,就能得到一个本人栩栩如生的演讲视频。视频时长可变,目前看到的示例最高为10s。可以看到,无论是口型还是面部表情,它都非常自然。如果输入图像囊括整个上半身,它也能配合丰富的手势:网友看完就表示:有了它,以后咱开线上视频会议再也不需要整理好发型、穿好衣服再去了。嗯,拍一张肖像,录好演讲音频就可以(手动狗头)用声音控制肖像生成视频这个框架名叫VLOGGER。它主要基于扩散模型,并包含两部分:一个是随机的人体到3D运动(human-to-3d-moti
谷歌发布了一个新的视频框架:
只需要一张你的头像、一段讲话录音,就能得到一个本人栩栩如生的演讲视频。
视频时长可变,目前看到的示例最高为10s。
可以看到,无论是口型还是面部表情,它都非常自然。
如果输入图像囊括整个上半身,它也能配合丰富的手势:

网友看完就表示:
有了它,以后咱开线上视频会议再也不需要整理好发型、穿好衣服再去了。
嗯,拍一张肖像,录好演讲音频就可以(手动狗头)

用声音控制肖像生成视频
这个框架名叫VLOGGER。
它主要基于扩散模型,并包含两部分:
一个是随机的人体到3D运动(human-to-3d-motion)扩散模型。
另一个是用于增强文本到图像模型的新扩散架构。

其中,前者负责将音频波形作为输入,生成人物的身体控制动作,包括眼神、表情和手势、身体整体姿势等等。
后者则是一个时间维度的图像到图像模型,用于扩展大型图像扩散模型,使用刚刚预测的动作来生成相应的帧。
为了使结果符合特定的人物形象,VLOGGER还将参数图像的pose图作为输入。
VLOGGER的训练是在一个超大的数据集(名叫MENTOR)上完成的。
有多大?全长2200小时,共包含80万个人物视频。
其中,测试集的视频时长也有120小时长,共计4000个人物。
谷歌介绍,VLOGGER最突出的表现是具备多样性:
如下图所示,最后的像素图颜色越深(红)的部分,代表动作越丰富。

而和业内此前的同类方法相比,VLOGGER最大的优势则体现在不需要对每个人进行训练、也不依赖于面部检测和裁剪,并且生成的视频很完整(既包括面部和唇部,也包括肢体动作)等等。

具体来看,如下表所示:
Face Reenactment方法无法用音频和文本来控制此类视频生成。
Audio-to-motion倒是可以音频生成,方式也是将音频编码为3D人脸动作,不过它生成的效果不够逼真。
Lip sync可以处理不同主题的视频,但只能模拟嘴部动作。
对比起来,后面的两种方法SadTaker和Styletalk表现最接近谷歌VLOGGER,但也败在了不能进行身体控制上,并且也不能进一步编辑视频。

说到视频编辑,如下图所示,VLOGGER模型的应用之一就是这个,它可以一键让人物闭嘴、闭眼、只闭左眼或者全程睁眼:

另一个应用则是视频翻译:
例如将原视频的英语讲话改成口型一致的西班牙语。
网友吐槽
最后,“老规矩”,谷歌没有发布模型,现在能看的只有更多效果还有论文。
嗯,吐槽也是不少的:
画质模型、口型抽风对不上、看起来还是很机器人等等。
因此,有人毫不犹豫打上差评:
这就是谷歌的水准吗?

有点对不起“VLOGGER”这个名字了。

——和OpenAI的Sora对比,网友的说法确实也不是没有道理。。
大家觉得呢?
更多效果:https://enriccorona.github.io/vlogger/
完整论文:https://enriccorona.github.io/vlogger/paper.pdf

近日,有汽车领域博主爆料,特斯拉的FSD(完全自动驾驶)辅助系统将迎来一次重要升级,或将实现更真实的环境场景还原。在最新曝光的软件代码中,发现了大量新增的渲染模型,涵盖多种车辆与行人类型。这些新增模型包括救护车、消防车、垃圾清运车、校车、半挂式卡车、高尔夫球车、骑电动滑板车的行人、使用轮椅的行人、玩滑板的行人、推婴儿车的行人,以及道路清扫车、三轮车、拖车、火车和有轨电车等。这一系列高精度建模意味着FSD系统将能更准确识别并响应复杂交通参与者的行为。据CNMO掌握的消息,日本方面已为特斯拉FSD系统的落地扫
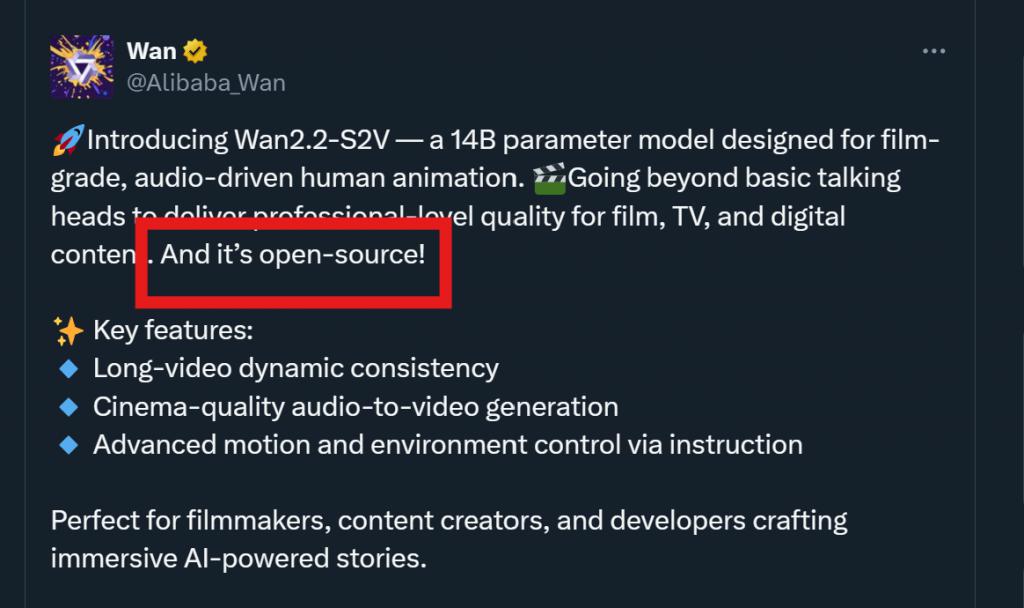
AI视频生成正迎来属于“通义”的高光时刻!就在昨晚,阿里巴巴悄然推出了一款由音频驱动的14B视频大模型——Wan2.2-S2V。只需上传一张静态图片和一段音频,就能生成出面部表情生动、口型精准匹配、肢体动作流畅自然的电影级数字人视频,效果惊艳。实际效果展示如下:△来自@AIMIRAI46487更令人振奋的是,这款新模型一经发布便全面开源,现在所有人都可以免费在通义万相官网体验使用。据官方介绍,Wan2.2-S2V的核心优势包括:支持最长分钟级的单次视频生成,画面稳定且具有一致性;具备影院级别的音

5月30日,华为推出了全新的AI模型——盘古UltraMoE,该模型的参数量达到了7180亿。作为一款接近万亿参数的MoE(MixtureofExperts)模型,它在整个训练过程中完全基于华为的昇腾AI平台完成,标志着华为在超大规模模型训练方面取得了重要进展。盘古UltraMoE的成功训练离不开盘古团队研发的一系列创新技术。例如,Depth-ScaledSandwich-Norm(DSSN)稳定架构的引入,显著改善了超大规模模型训练期间出现的梯度异常及

大语言模型面对加密数据,即便最新的Qwen3也会感到压力!尽管当下各类推理模型在多种基准测试中表现优异,但在密码学这样对逻辑严谨性和细节准确性要求极高的专业领域,模型的推理能力还有待深入挖掘。密码学不仅要求模型具备高级数学运算能力和严密的逻辑推理链,还需要其能够精准辨识复杂加密模式中的潜在规律;成功解密要求模型拥有极强的综合推理能力。上海AILab等联合推出的CipherBank测评,使用大量真实隐私场景数据和多种密码算法,严苛挑战当前最先进的大模型。CipherBank的测评结果显示,目前的大语言模型

现在,请大家一起来数一下"1"、"2"。OK,仅仅2秒的时间,一个接近万亿规模的MoE大模型就已经掌握了如何解答一道高等数学难题的方法!而且呢,这个大模型还是完全依靠国产设备进行训练的,整个流程都体现了浓浓的“国产”特色。这就是华为借助"昇腾+PanguUltraMoE"这一组合实现的成果——不仅达成了国产算力与国产模型在全流程上的自主可控训练闭环,还在集群训练系统的性能方面达到了行业顶尖水平。有多顶尖?来看一组数据:预训练阶段:昇腾Atlas800TA2万卡集群的MFU提升

只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限

强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足


编辑:桃子【新智元导读】第二代Ameca升级亮相,搭载GPT-4技术,实现实时对话。人形机器人Ameca迎来了它的第二代版本!近期,在2024年世界移动通信大会(MWC)上,全球最先进的机器人Ameca再度亮相。Ameca在会场周围吸引了大量观众。通过GPT-4的增强,Ameca能够即时回应各种问题。「展示一段舞蹈吧」。当被问及是否有情感时,Ameca通过一系列逼真的面部表情作出回应。就在几天前,开发Ameca的英国机器人公司EngineeredArts展示了他们团队的最新成果。视频中,Ameca具备了






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
