

图像处理
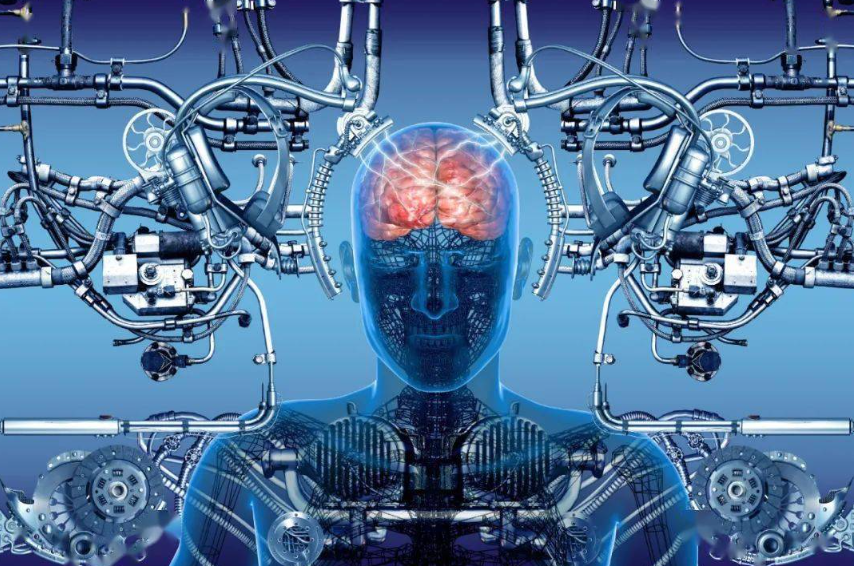
编辑|萝卜皮使用多个电极来记录神经元活动是一种常用的方法,可以帮助我们了解大脑的功能机制。通过增加电极数量,科学家能够更准确地解码不同类型的功能。然而,由于硬件资源有限和不可避免的热组织损伤,处理大量多通道电生理数据仍然是具有挑战性的任务。韩国大邱庆北科学技术院的研究团队提出了一种利用机器学习技术进行高频神经元尖峰信号重建的方法。该方法基于二次采样的低频信号,通过机器学习算法对信号进行重建。这种方法可以有效地提取高频神经元活动的信息,并且能够准确地还原原始信号。研究团队通过实验验证了该方法的有效性,证明了
在机器学习领域,扩散模型在图像处理中起到了广泛的作用。它被应用在多个图像处理任务上,包括图像去噪、图像增强以及图像分割等。扩散模型的主要优势在于它能够有效处理图像中的噪声,同时还能增强图像的细节和对比度,并且能够对图像进行准确的分割。此外,扩散模型还具有高计算效率和易于实现的特点。总之,扩散模型在图像处理中发挥着重要的作用,为我们提供了一种强大的工具来改善图像质量和提取图像特征。扩散模型在图像处理中的作用扩散模型是一种基于偏微分方程的机器学习模型,主要应用于图像处理领域。其基本原理是模拟物理扩散过程,通过
误差反向传播是常用机器学习算法,广泛应用于神经网络训练,尤其在图片识别领域。本文将介绍该算法在图片识别中的应用、原理和示例。一、误差反向传播算法的应用图片识别是一种使用计算机程序对数字或图像进行分析、处理和理解的方法,以识别出其中的信息和特征。在图片识别中,误差反向传播算法被广泛应用。该算法通过训练神经网络来实现识别任务。神经网络是一种模拟人脑神经元之间相互作用的计算模型,它能够有效地处理和分类复杂的输入数据。通过不断调整神经网络的权重和偏差,误差反向传播算法可以使神经网络逐渐学习和改进其识别能力。误差反
随着数字图像技术和计算机科学的发展,图像分类成为了机器学习中一个重要的应用领域。图像分类是指将数字图像分配给不同的类别,这些类别可能是物体、场景、动作等,从而实现自动识别和分类的目的。传统的图像分类方法需要手动提取特征,并使用分类器进行分类。然而,这些手动特征提取方法往往需要大量的人力和时间,而且对于复杂的图像分类问题,这些方法的性能也很有限。因此,近年来,越来越多的研究者开始尝试利用机器学习方法来简化图像分类。机器学习是一种基于算法训练的方法,用于识别模式、分类数据和进行预测。在图像分类领域,机器学习算
Attention机制是一种关键的序列数据处理算法,其主要目标是为序列中的每个元素分配权重,以便在计算输出时考虑它们的相对重要性。这种机制在自然语言处理、图像处理和其他领域都得到了广泛应用。接下来,我将简要介绍几种基于Attention机制的算法及其应用。1.Seq2Seq模型Seq2Seq模型是一种常用的机器翻译模型,使用encoder-decoder架构实现源语言句子到目标语言句子的转换。在该模型中,encoder将源语言句子编码为一个向量,而decoder则利用该向量生成目标语言句子。为了指导dec
Wasserstein距离,又称为EarthMover'sDistance(EMD),是一种用于度量两个概率分布之间差异的度量方法。相比于传统的KL散度或JS散度,Wasserstein距离考虑了分布之间的结构信息,因此在许多图像处理任务中展现出更好的性能。通过计算两个分布之间的最小运输成本,Wasserstein距离能够测量将一个分布转换为另一个分布所需的最小工作量。这种度量方法能够捕捉到分布之间的几何差异,从而在图像生成、风格迁移等任务中发挥重要作用。因此,Wasserstein距离成为了概率分布比较
变分自编码器(VariationalAutoencoder,VAE)是一种无监督学习的神经网络,用于图像压缩和生成。相比传统自编码器,VAE可以重建输入图像,还能生成与之类似的新图像。其核心思想是将输入图像编码为潜在变量的分布,并从中进行采样以生成新的图像。VAE的独特之处在于使用变分推断来训练模型,通过最大化观测数据与生成数据之间的下界来实现参数学习。这种方法使得VAE能够学习到数据的潜在结构和生成新样本的能力。VAE已经在许多领域取得了显著的成功,包括图像生成、属性编辑和图像重建等任务。VAE(变分自
VisionTransformer(VIT)是Google提出的一种基于Transformer的图片分类模型。不同于传统CNN模型,VIT将图像表示为序列,并通过预测图像的类标签来学习图像结构。为了实现这一点,VIT将输入图像划分为多个补丁,并将每个补丁中的像素通过通道连接,然后进行线性投影以达到所需的输入维度。最后,每个补丁被展平为单个向量,从而形成输入序列。通过Transformer的自注意力机制,VIT能够捕捉到不同补丁之间的关系,并进行有效的特征提取和分类预测。这种序列化的图像表示方法为计算机视觉
老照片修复是利用人工智能技术对老照片进行修复、增强和改善的方法。通过计算机视觉和机器学习算法,该技术能够自动识别并修复老照片中的损坏和缺陷,使其看起来更加清晰、自然和真实。老照片修复的技术原理主要包括以下几个方面:1.图像去噪和增强修复老照片时,需要先对其进行去噪和增强处理。可以使用图像处理算法和滤波器,如均值滤波、高斯滤波、双边滤波等,来解决噪点和色斑问题,从而提升照片的质量。2.图像复原和修复在老照片中,可能存在一些缺陷和损坏,例如划痕、裂缝、褪色等。这些问题可以通过图像复原和修复算法来解决。常用的算
深度学习在计算机视觉领域取得了巨大成功,其中一项重要进展是使用深度卷积神经网络(CNN)进行图像分类。然而,深度CNN通常需要大量标记数据和计算资源。为了减少计算资源和标记数据的需求,研究人员开始研究如何融合浅层特征和深层特征以提高图像分类性能。这种融合方法可以利用浅层特征的高计算效率和深层特征的强表示能力。通过将两者结合,可以在保持较高分类准确性的同时降低计算成本和数据标记的要求。这种方法对于那些数据量较小或计算资源有限的应用场景尤为重要。通过深入研究浅层特征和深层特征的融合方法,我们可以进一步提高图像
深度图像数据集是在深度学习和计算机视觉任务中非常重要的数据类型。它包含了每个像素的深度信息,可以用于多种应用,如场景重建、目标检测和姿态估计。本文将介绍几个常用的深度图像数据集,包括它们的来源、特点和应用。1.NYUDepthV2NYUDepthV2数据集包含室内场景的深度图像和RGB图像,共1449个场景样本。这些场景包括卧室、客厅、厨房等多种室内环境。每个场景都提供了相机的内参和外参信息,可用于相机姿态估计和场景重建等任务。此外,数据集还提供了场景中物体的标注信息,可用于物体检测和语义分割等任务。2.
随着计算机视觉领域的不断发展,人们对于对象识别的研究也越来越深入。其中,视觉词袋(BoW)是常用的对象识别方法。本文将介绍视觉词袋方法的原理、优缺点,并举例说明。视觉词袋方法是一种基于图像局部特征的对象识别方法。它将图像分割为多个小区域,并提取每个区域的特征描述子。然后,通过聚类算法将这些特征描述子分组成一个视觉词袋,其中每个词袋表示一种特定的局部特征。在对象识别阶段,将输入图像的特征描述子与视觉词一、原理视觉词袋是一种经典的图像分类方法。它通过提取图像中的局部特征,并使用聚类算法将这些特征聚类为一组视觉
基于卷积神经网络的图像风格迁移是一种将图像的内容与风格结合生成新图像的技术。它利用卷积神经网络(CNN)将图像转换为风格特征向量的模型。本文将从以下三个方面对此技术进行讨论:一、技术原理基于卷积神经网络的图像风格迁移的实现依赖于两个关键概念:内容表示和风格表示。内容表示指的是图像中对象和物体的抽象表达,而风格表示指的是图像中纹理和颜色的抽象表达。在卷积神经网络中,我们通过将内容表示和风格表示相结合,生成一张新的图像,以保留原始图像的内容并具备新图像的风格。为了实现这个目标,我们可以使用一种被称为“神经风格
目标检测是计算机视觉领域中一项重要任务,其目标是从图像或视频中识别出特定物体,并标注它们的位置和类别。深度学习在目标检测中取得了巨大成功,尤其是基于卷积神经网络(CNN)的方法。本文将介绍计算机视觉深度学习目标检测的概念和实现步骤。一、概念1.目标检测的定义目标检测是通过图像或视频识别特定物体,并标注位置和类别。相比于图像分类和物体检测,目标检测需要定位多个物体,因此更具挑战性。2.目标检测的应用目标检测在很多领域都有着广泛的应用,例如智能家居、智能交通、安防监控、医学影像分析等。其中,在自动驾驶领域中,

随着互联网的发展,图像处理功能变得越来越重要。通过处理图像,人们可以编辑、优化或者转换图像格式,以便将图像用于设计、网站或其他应用中。同时,随着智能手机和数码相机的普及,我们每天都会产生大量的图片,如何高效地处理这些图片也变得越来越重要。在这篇文章中,我们将探讨如何使用Go语言实现高效的图像处理功能。Go是一个高效、简单和可靠的语言,它可以用于编写各种类型的
超分辨率图像重建是利用深度学习技术,如卷积神经网络(CNN)和生成对抗网络(GAN),从低分辨率图像中生成高分辨率图像的过程。该方法的目标是通过将低分辨率图像转换为高分辨率图像,从而提高图像的质量和细节。这种技术在许多领域都有广泛的应用,如医学影像、监控摄像、卫星图像等。通过超分辨率图像重建,我们可以获得更清晰、更具细节的图像,有助于更准确地分析和识别图像中的目标和特征。重建方法超分辨率图像重建的方法通常可以分为两类:基于插值的方法和基于深度学习的方法。1)基于插值的方法基于插值的超分辨率图像重建方法是一
PEFT(ParameterEfficientFine-tuning)是一种优化深度学习模型微调过程的参数高效技术,旨在在有限的计算资源下实现高效微调。研究人员通过采用一系列策略来减少微调所需的计算资源,从而在保持模型性能的同时提高微调效率。这些策略包括减少微调训练的迭代次数、降低训练数据的采样率以及减少模型参数的更新频率等。通过这些方法,PEFT能够在资源受限的情况下,有效地进行深度学习模型的微调,为实际应用中的计算资源节约提供了一种有效的解决方案。PEFT的应用广泛,包括图像分类和自然语言处理等领域。
奇异值分解(SVD)是一种用于矩阵分解的方法。它将一个矩阵分解为三个矩阵的乘积,分别是左奇异向量矩阵、右奇异向量矩阵和奇异值矩阵。SVD在数据降维、信号处理、推荐系统等领域广泛应用。通过SVD,我们可以将高维数据降低到低维空间,从而提取出数据的主要特征。在信号处理中,SVD可以用于降噪和信号重构。在推荐系统中,SVD可以帮助我们发现用户和物品之间的隐藏关联,从而进行准确的推荐。总之,SVD是一种强大而灵活的矩阵分解方法,为我们解决许SVD是奇异值分解的缩写,它将一个矩阵分解为三个部分:U、Σ和V^T。其中
尺度不变特征变换(SIFT)算法是一种用于图像处理和计算机视觉领域的特征提取算法。该算法于1999年提出,旨在提高计算机视觉系统中的物体识别和匹配性能。SIFT算法具有鲁棒性和准确性,被广泛应用于图像识别、三维重建、目标检测、视频跟踪等领域。它通过在多个尺度空间中检测关键点,并提取关键点周围的局部特征描述符来实现尺度不变性。SIFT算法的主要步骤包括尺度空间的构建、关键点检测、关键点定位、方向分配和特征描述符生成。通过这些步骤,SIFT算法能够提取出具有鲁棒性和独特性的特征,从而实现对图像的高效识别和匹配
Java语言中的图像处理算法介绍随着数字化时代的到来,图像处理已经成为了计算机科学中的一个重要分支。在计算机中,图像是以数字形式存储的,而图像处理则是通过对这些数字进行一系列的算法运算,改变图像的质量和外观。Java语言作为一种跨平台的编程语言,其丰富的图像处理库和强大的算法支持,使得它成为了很多开发者的首选。本文将介绍Java语言中常用的图像处理算法,以及
掌握Pillow库的主要功能,提升图像处理效率引言:图像处理在计算机视觉、人工智能等领域起着重要的作用。而Pillow是一个强大的图像处理库,它为我们提供了丰富的功能和灵活的操作方式,可以大大提升图像处理的效率。本文将介绍Pillow库的主要功能,并附上具体的代码示例,帮助读者更好地理解和掌握这个库。一、安装Pillow库首先,我们需要安装Pillow库。使
掌握pillow库的安装技巧,助你快速上手图像处理引言:随着科技的发展,图像处理在我们的日常生活和工作中扮演着越来越重要的角色。而Pillow库作为Python中最受欢迎的图像处理库之一,为我们提供了丰富的图像处理功能和便捷的接口。今天,我们将介绍Pillow库的安装技巧,并提供一些具体的代码示例,帮助你快速上手图像处理。一、安装Pillow库要使用Pill
在计算机视觉和图像处理中,图像操作起着至关重要的作用。这些操作对于预处理、提升图像质量和启用高级算法等任务至关重要。在计算机视觉领域,调整大小、裁剪、调整亮度/对比度/伽玛和几何变换等操作是基础操作。它们能够进行高效计算、提取感兴趣区域、规范化图像强度和几何校准。在图像处理方面,这些操作对于降低采样率、裁剪无关区域、提升可见性和质量以及执行几何操作也至关重要调整大小在各种场景中,调整图像大小是常见的,可以实现不同的目的,例如将图像适应特定尺寸或减小文件大小。图像插值和重采样是图像处理和计算机视觉中用于调整


火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




