

业界资讯
Crisp-DM又叫做跨行业数据挖掘标准过程,本文介绍如何基于Crisp-DM方法组织机器学习项目。步骤如下:第一步:业务理解是解决问题的关键。在这个步骤中,我们需要全面了解业务问题的性质和严重程度。通过对可能的解决方案进行研究,我们可以确定是否需要利用机器学习来解决问题。同时,我们也需要考虑潜在的替代方案,并为解决问题设定一个明确的可量化目标。这一步的目的是确保我们对问题有一个清晰的认识,以便能够制定出有效的解决方案。步骤二:数据理解。理解业务问题后,下一步就是理解所提供数据的复杂性。这包括分析可用数据
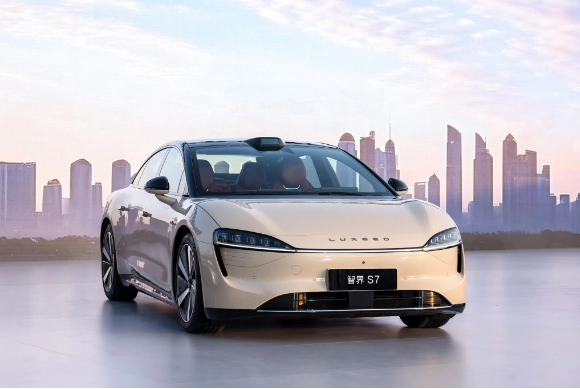
鸿蒙智行社区最近针对智界S7车型推出了一项提车关爱补贴计划,旨在回馈那些在特定时间内完成大定支付的用户。这个计划是为了表达对他们的支持和关心。根据计划详情,针对在2023年11月28日至2024年1月15日前完成大定支付的智界S7用户,鸿蒙智行将提供现金补贴。具体补贴标准根据车型和内饰颜色有所不同。对于智界S7Max和智界S7MaxRS的非白沙杏内饰用户,若订单状态在鸿蒙智行App上自“交付方案已确认”之日起到“车辆已到店”之日止超过6周,将按照超出天数给予提车关爱现金补贴。对于智界S7Max、智界S7M
卷积神经网络(CNN)是一种深度学习神经网络,被广泛应用于图像识别、自然语言处理、语音识别等领域。卷积层是CNN中最重要的一层,通过卷积操作可以有效地提取图像特征。在卷积层中,轮询和填充是常用的技术,它们能够改善卷积层的性能和稳定性。通过轮询(pooling)操作,可以减少特征图的尺寸,降低模型复杂度,同时保留重要的特征信息。而填充(padding)操作则可以在输入图像的边缘周围添加额外的像素,使得输出特征图的尺寸与输入相同,避免信息损失。这些技术的应用,进一步提一、轮询轮询是CNN中常用的操作之一,通过
Transformer在大模型领域的地位无可撼动。然而,随着模型规模的扩展和序列长度的增加,传统的Transformer架构的局限性开始凸显。幸运的是,Mamba的问世正在迅速改变这一现状。它出色的性能立即引起了AI界的轰动。Mamba的出现为大规模模型的训练和序列处理带来了巨大的突破。它的优势在AI界迅速蔓延,为未来的研究和应用带来了巨大的希望。上周四,VisionMamba(Vim)的提出已经展现了它成为视觉基础模型的下一代骨干的巨大潜力。仅隔一天,中国科学院、华为、鹏城实验室的研究人员提出了VMam
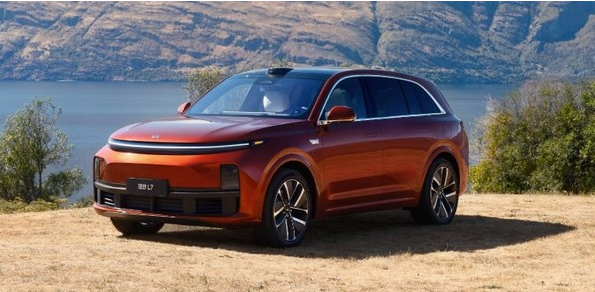
7月3日消息,根据小编从理想官方获悉,《杰兰路2023年度上半年新能源汽车品牌健康度研究》的结果正式发布。在这项评估中,理想汽车凭借出色的品牌净推荐度(NPS)表现,成功夺得第一名的位置。净推荐度是一项衡量用户整体体验满意度和品牌忠诚度的指标。据了解,这项研究还公布了前十名品牌的排名情况。蔚来位列第二,特斯拉位列第三,比亚迪位列第四,腾势位列第五,阿维塔位列第六,智己位列第七,小鹏惊人地只排在第八名,极氪和五菱分别位列第九和第十名。该研究报告还指出,今年上半年理想汽车的用户满意度和市场影响力均呈现出正向的
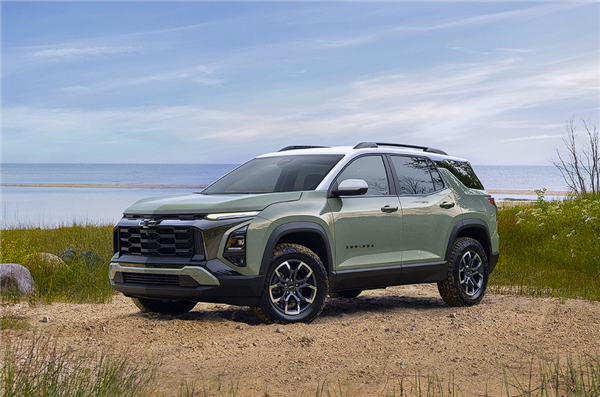
雪佛兰全新Equinox(探界者)于1月24日正式发布。最新的Equinox在动力系统方面进行了重大改进,取消了原先的2.0T版本,而采用了全新的1.5T发动机。新车预计将在墨西哥率先投产,并计划于今年年中在美国市场上市,而国内版本的上市时间预计在今年年底。这一调整为消费者提供了更多选择,并且将进一步提升Equinox在全球市场的竞争力。新款探界者在外观设计上保持了雪佛兰家族最新的设计语言,整体风格更加硬朗且富有年轻活力,与当下的审美趋势相契合。据了解,新车提供了三种不同的外观造型供消费者选择,其中包括R
低估大型数据集上的模型性能可能会导致决策错误。如果模型在实际应用中表现不佳,可能会带来资源的浪费和损失。此外,低估模型性能还可能导致对数据集的错误解读,对后续数据分析和决策产生影响。因此,准确评估模型性能对于确保正确的决策和数据分析至关重要。低估大型数据集上的模型性能是一种常见的问题,但可以通过以下方法来解决:1.交叉验证交叉验证技术是一种用于评估模型性能的方法。它将数据集分成几个部分,一部分用于训练,其余部分用于测试。通过多次训练和测试,可以得到更准确的模型性能评估。这种方法可以减少过拟合和欠拟合的风险
6月7日消息,一加(OnePlus)CEO刘作虎先生先前表示,第一款一加折叠屏智能手机将于今年第三季度发布。现有爆料显示,这款折叠屏手机的发布会计划于8月上半月在纽约举行,并随后在全球范围内推出。据小编了解,另据消息称,OPPO也计划在8月在中国市场推出其FindN3折叠屏手机,而一加Fold可能只是OPPOFindN3的国际版。据称,一加Fold预计将配备一块8英寸QHD+分辨率内部屏幕和一块6.5英寸FHD+分辨率外部屏幕,两者均支持120Hz刷新率。这款新的折叠屏手机将搭载高通骁龙8Gen2芯片,提
编辑|萝卜皮与DNA和RNA不同,蛋白质的测序方法目前仍然相对不准确且不高通量,这限制了蛋白质组学在未知序列的应用中的实用性,如变异位点的识别、新表位的鉴定和宏蛋白质组学等。因此,发展更准确和高通量的蛋白质测序技术是当前研究的重点。德国慕尼黑工业大学(TechnischeUniversitätMünchen,TUM)的研究人员推出了Spectralis,一种用于串联质谱分析的从头肽测序方法。Spectralis利用了多项创新,包括连接按氨基酸质量间隔的光谱峰的卷积神经网络层、提出碎片离子系列分类作为从头肽
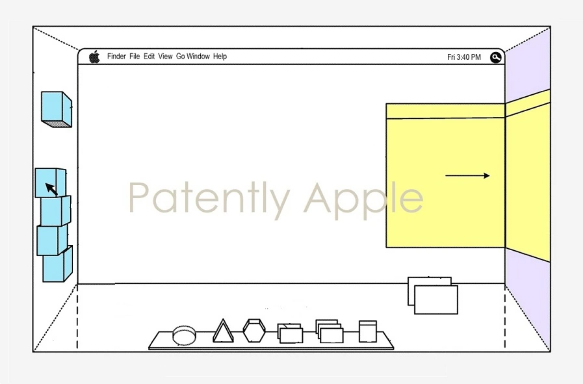
6月30日消息,近日根据美国商标和专利局(USPTO)公示的清单,苹果公司获得了一项名为《视觉对象容器》(VisualObjectContainer)的专利,编号为US20230205406A1。据该专利披露的内容显示,这一专利可能为未来的macOS操作系统带来3D版本。据苹果公司专利中提供的设计草图显示,这一3DmacOS系统将通过立体呈现文件夹、Dock和其他相关元素来提供更加沉浸的使用体验。草图中展示了桌面上的3D图像,让用户可以更直观地操作和管理文件。专利中还提供了一些实现方法和系统设计方案,其中
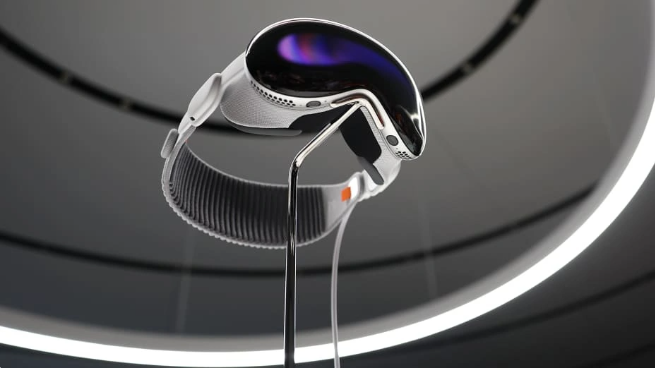
6月12日消息,苹果的最新头显产品VisionPro发布后,引发了关于供应链的诸多传闻。近日有知情人士透露,虽然索尼将为VisionPro头显提供高分辨率的MicroOLED显示面板,即OLEDoS面板,但LGDisplay有望成为下一代VisionPro头显的主要显示屏供应商。根据业内人士此前的表示,VisionPro的生产成本约为1519美元(约合人民币10830元)。索尼提供的OLEDoS面板是所有组件中价格最昂贵的,每块面板的售价约为350美元(约合人民币2496元),而每台VisionPro设备
大型语言模型和词嵌入模型是自然语言处理中两个关键概念。它们都可以应用于文本分析和生成,但原理和应用场景有所区别。大型语言模型主要基于统计和概率模型,适用于生成连续文本和语义理解。而词嵌入模型则通过将词映射到向量空间,能够捕捉词之间的语义关系,适用于词义推断和文本分类。一、词嵌入模型词嵌入模型是一种通过将单词映射到低维向量空间来处理文本信息的技术。它能够将语言中的单词转换为向量形式,以便计算机更好地理解和处理文本。常用的词嵌入模型包括Word2Vec和GloVe等。这些模型在自然语言处理任务中被广泛应用,如
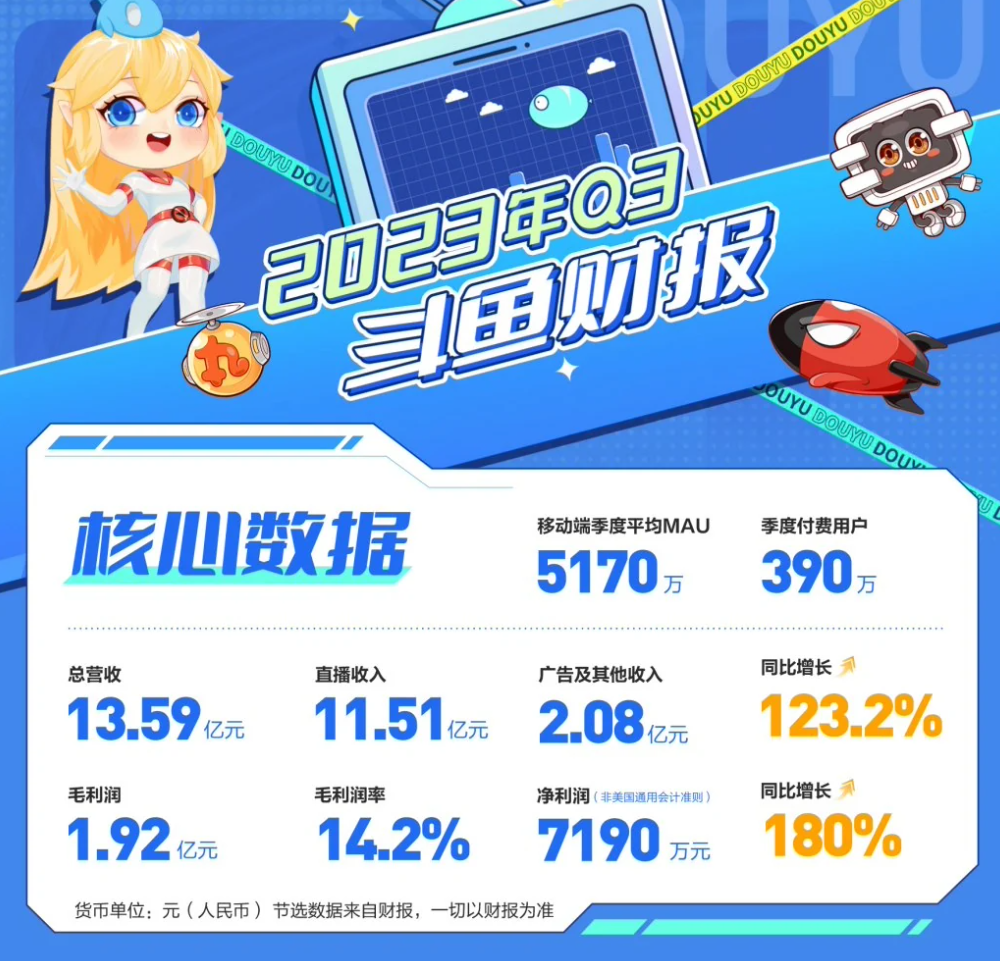
斗鱼于1月12日发布邮件,宣布进行内部组织架构和人员调整。对此,斗鱼回应称这是正常的人事调整。邮件内容显示,斗鱼内部将新成立内容生态部,负责主播内容产出、厂商合作、赛事生态体系搭建等,由临时管理委员会成员、公司副总裁任思敏负责。同时,下设三个二级部门,分别为主播运营部、厂商项目部和赛事内容部。原创作者服务部调整为内容产品部,负责内容侧赛事、厂商、主播相关需求,以及创作者运营服务、创作工具、价值评估等,由吕丽峰负责,向陈哲汇报。下设四个二级部门,分别为赛事产品部、厂商产品部、主播产品部、算法攻坚部。张超负责
语法在自然语言处理和语言模型中非常重要,它有助于模型理解语言结构和组成部分之间的关系。语法是一种规则,描述了语言中单词和短语的结构、顺序和关系。这些规则可以用形式化的语法或自然语言文本的形式来表示。然后,这些规则可以转化为计算机可理解的形式,如上下文无关文法(CFG)或依存文法(DG)。这些形式化的语法规则为计算机语言处理提供了基础,使得计算机能够理解和处理人类的语言。通过应用这些规则,我们可以进行语法分析、句法树生成和语义解析等操作,从而实现自然语言处理和机器翻译等任务。在自然语言处理中,语法规则扮演着
当代数据领域的最大力量可能在于基础模型的广泛应用。这些模型在人工智能的部署中扮演着重要角色,对外部客户交互和内部员工与数据系统的接口等各个方面产生明显影响。因此,到2024年,存储和检索数据、应用和从基础模型中产生价值的新范式将得到巩固。同时,数据驱动流程的重要性也会被强调,包括数据安全和数据隐私。随着先进的机器学习部署的不断发展,我们的生活将变得更加丰富多彩,同时也需要保护数据和确保监管合规性。这两个方面的发展将相辅相成,相互推动。智能机器人生成自然语言只是开端,为了支持这些人工智能功能并推进至2025
机器学习分类器算法是一种被广泛应用于数据挖掘、人工智能等领域的算法。它可以通过对数据进行分类和预测来帮助解决实际问题,因此在现代人工智能技术中扮演着重要角色。下面将简要介绍一些常用的机器学习分类器算法。一、决策树分类器决策树是一种基于树形结构的分类器。它通过将数据集划分为多个子集来进行分类,其中每个子集对应树的一个节点,最终形成一个完整的决策树。在分类过程中,根据特征的取值逐层向下遍历决策树,直到到达叶子节点,从而得到最终的分类结果。决策树分类器具有易于理解和解释的优点,但也容易出现过拟合问题。因此,在使
7月3日消息,微软正在计划推出一款名为Windows12的操作系统,预计在2024年秋季面市,并于2025年进行更广泛的推广。据了解,微软在内部试验了多个新的设计理念,其中包括一种带有"浮动"任务栏的全新桌面体验。微软希望通过将任务栏与桌面分离,并使其边缘变圆,为任务栏创造出一种浮动效果。这一设计升级的想法最早在微软于2023年举办的Build开发者大会上暗示出来,当时微软提到正在开发"下一代Windows",这引发了外界对于Windows12的猜测。然而,微软在2023年的Ignite会议上出人意料地透
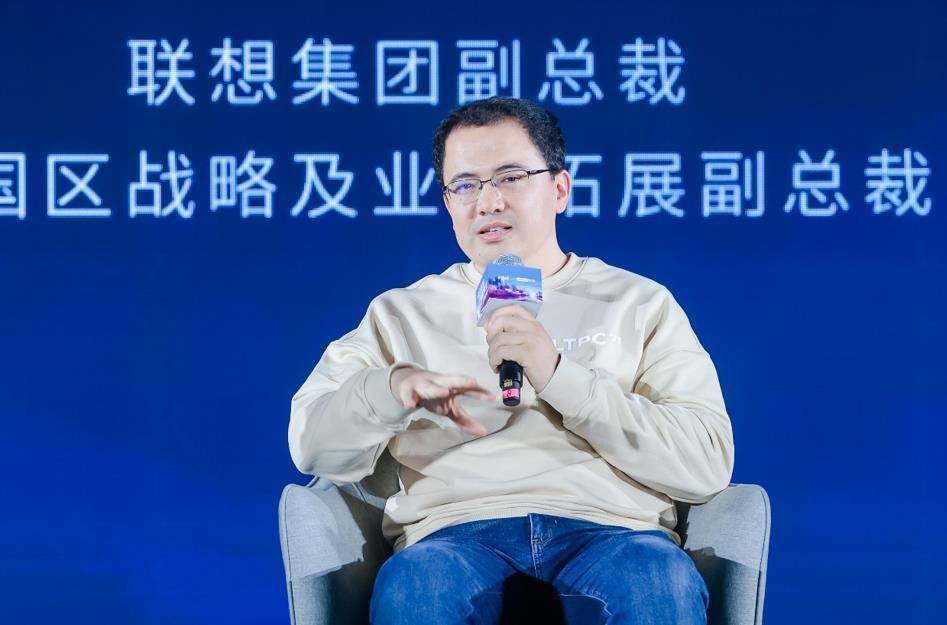
联想集团副总裁、中国首席战略官阿不力克木·阿不力米提(以下简称“阿木”)在2023联想天禧AI生态开发者大会上表示,将AI大模型与终端结合是一个必然趋势,这一浪潮始于PC。大模型的一大突破是通过通用算法实现了创作能力,而创作力一直以来是PC的专长。因此,在大模型应用于各种终端类型的过程中,我们可以明显地看到其在AIPC终端上呈现出的效果。而这是由于算力的支持。他指出,PC目前仍然是个人终端设备中最强大的算力产品,并且可以轻松扩展最新的CPU、GPU和NPU,以满足AI大模型对算力不断增长的需求,从而成为支
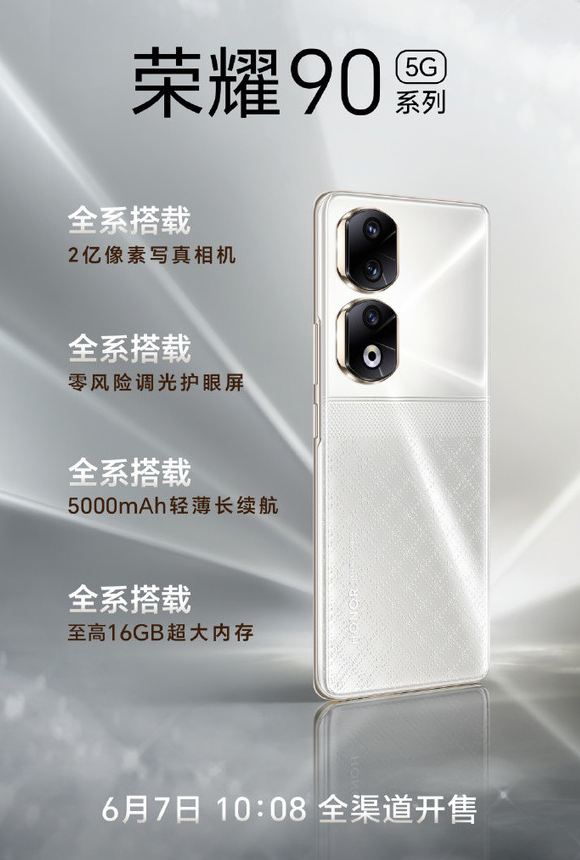
6月6日消息,荣耀今日举行新品发布会,正式发布了备受期待的荣耀90系列手机。荣耀90系列包括荣耀90和荣耀90Pro两款机型,将于6月7日10:08开始正式开售。根据小编了解,荣耀90的起售价为2499元,而荣耀90Pro的起售价为3299元。荣耀90系列手机在外观设计上延续了荣耀数字系列的美学传承,采用了创新的浮雕玻璃工艺。手机提供了星钻银、冰羽蓝、墨玉青、亮黑色四款时尚配色供消费者选择。荣耀90系列还带来了全球首发的零风险调光护眼屏,支持3840Hz超高频PWM调光技术,并获得TUV莱茵无频闪认证,为
顺序数据是一种具有时间或顺序性的数据,如时间序列数据、自然语言文本和语音。数据点的顺序对于理解底层模式或含义至关重要。为了处理和分析顺序数据,机器学习和人工智能中使用了顺序建模技术。在顺序模型中,数据按顺序通过一系列层进行传递和处理,以提取特征。这些层按特定顺序堆叠在一起,以实现数据的转换。首层为输入层,接收原始输入数据,末层为输出层,生成最终预测或输出。通常,在它们之间会有一个或多个隐藏层,用于处理数据和提取特征。这种顺序架构使得神经网络能够逐步学习和理解数据中的复杂关系,并进行准确的预测和分类。顺序数
福特汽车最近宣布,旗下的越野车型Bronco将以“福特烈马”之名进入中国市场。这个中文名称既突出了车辆强烈的越野特性和坚韧不拔的精神,又融入了深厚的文化内涵。这一命名选择体现了福特对中国市场的重视,并展示了他们对中国消费者的理解和尊重。福特烈马将为中国消费者带来卓越的越野体验,满足他们对冒险和自由的追求。福特汽车表示,此次命名的目的是为了保持福特烈马车型原有的硬核性能特点,并通过精准有力的文字表达,展示其桀骜不驯、拒绝被驯服的精神特质,以及在越野领域的极致性能。据了解,这款备受期待的越野车型将于1月29日
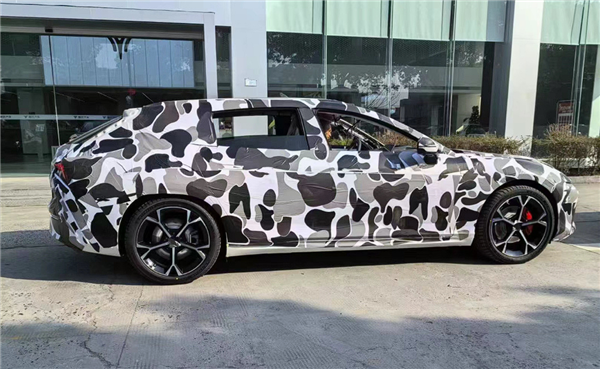
近日,哪吒汽车的全新车型——哪吒S猎装版的谍照曝光,进一步证明了国产纯电猎装轿车市场的热度。随着新能源汽车市场的不断升温,极氪001的成功引领了这一细分市场,吸引了众多车企的关注。除了腾势N7、蔚来ET5T等强劲对手,哪吒汽车也加入了这场竞争。这一消息引发了人们对哪吒S猎装版的期待。随着谍照曝光,车迷们纷纷猜测该车的性能和设计。对于新势力造车企业来说,进入纯电猎装轿车市场是一个重要的机遇和挑战,他们需要不断创新和提升产品竞争力,以在激烈的市场竞争中脱颖而出。尽管谍照中的哪吒S猎装版被严实的伪装所覆盖,但我
在自然语言处理(NLP)领域,进行文本数据分析是至关重要的任务。为了实现这一目标,研究人员和从业者可以借助两个非常有用的工具,分别是BERT词嵌入和TensorFlow框架。BERT(BidirectionalEncoderRepresentationsfromTransformers)是一种预训练的语言模型。它能够将文本数据转换为高维度的向量表示。这种向量表示可以捕捉到词语之间的语义关系,从而提供更准确和丰富的信息。BERT的引入大大改善了自然语言处理任务的效果,使得诸如文本分类、命名实体识别和问答系统

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




