

业界资讯
人脸识别技术是一种基于人工智能的高级图像处理技术,利用计算机视觉技术提取人脸图像的特征,然后通过算法分析和比对这些特征,实现对人脸的识别和认证。这一技术已经在安防、金融、社交、医疗等领域得到广泛应用,并成为现代社会中必不可少的一部分。通过人脸识别技术,可以实现高效的身份识别和认证,提高安全性和便利性。在安防领域,人脸识别技术可以用于识别陌生人、监控犯罪嫌疑人,保障公共安全。在金融领域,人脸识别技术可以用于身份验证、支付授权,防止欺诈行为。在社交领域,人脸识别技术可以用于人脸标签、表情分人脸识别技术的基本原
正则化是机器学习中常用的技术之一,用于控制模型复杂度和防止过拟合。它通过引入正则化函数来惩罚模型参数,限制模型的复杂性。正则化函数在机器学习中广泛应用。一、正则化函数的定义和作用正则化函数是一种数学函数,用于控制模型复杂度,在优化问题中的目标函数中起作用。它通过对模型参数进行惩罚,以防止过度拟合训练数据,并提高模型在新数据上的泛化能力。正则化函数通常由两部分构成:损失函数和正则化项。损失函数用于衡量模型在训练数据上的拟合程度,而正则化项用于惩罚模型的复杂度。通常有两种常见的正则化方法:L1正则化和L2正则
6月9日消息,Adobe今天发布了一则官方推文,宣布升级其免费图形设计工具AdobeExpress,并引入了全新的FireflyAI技术。据了解,这一升级最引人注目的亮点是FireflyAI技术的集成。AdobeExpress用户现在可以借助FireflyAI技术,通过输入文本提示来改进和生成图像和文本效果。这一功能使用户能够更加轻松地创建海报、传单和帖子等内容。Adobe展示了一个案例,用户输入了"轻松的海滨氛围",系统随即自动生成了以海滩为主题的文本和图像,用户可以选择将其插入到他们的设计中。Adob
线性支持向量机(LSVM)和一般支持向量机(SVM)是常用于分类和回归的机器学习模型。它们的核心思想是通过在数据空间中找到最佳超平面来分离不同的类别或解决回归问题。尽管它们都属于支持向量机的范畴,但它们之间存在一些区别。LSVM是一种基于线性核函数的支持向量机模型,它假设数据可以通过一个线性超平面进行良好的分割。它的优点是计算简单且容易解释,但它只能处理线性可分问题,对于非线性数据可能效果不佳。SVM是一种更通用的支持向量机模型,它使用核函数来将数据映射到高维特征空间,从而将非线性问题转化为线性可分问题。
感知器一种用于监督学习各种二进制排序任务的机器学习算法。感知器算法在商业智能中对某些输入数据的计算具有重要作用,它可以被看作是人工神经元或神经链接。作为一种最好和最具体的人工神经网络类型之一,感知器模型是一种二元分类器的监督学习算法。它可以被视为一个具有四个主要参数的单层神经网络,包括输入值、权重和偏差、净和和激活函数。感知器算法的类型1、单层感知器模型一种最简单的ANN(人工神经网络)类型是前馈网络,其中包含阈值传输。单层感知器模型的主要目标是分析具有二元结果的线性可分对象。然而,由于单层感知器只能学习
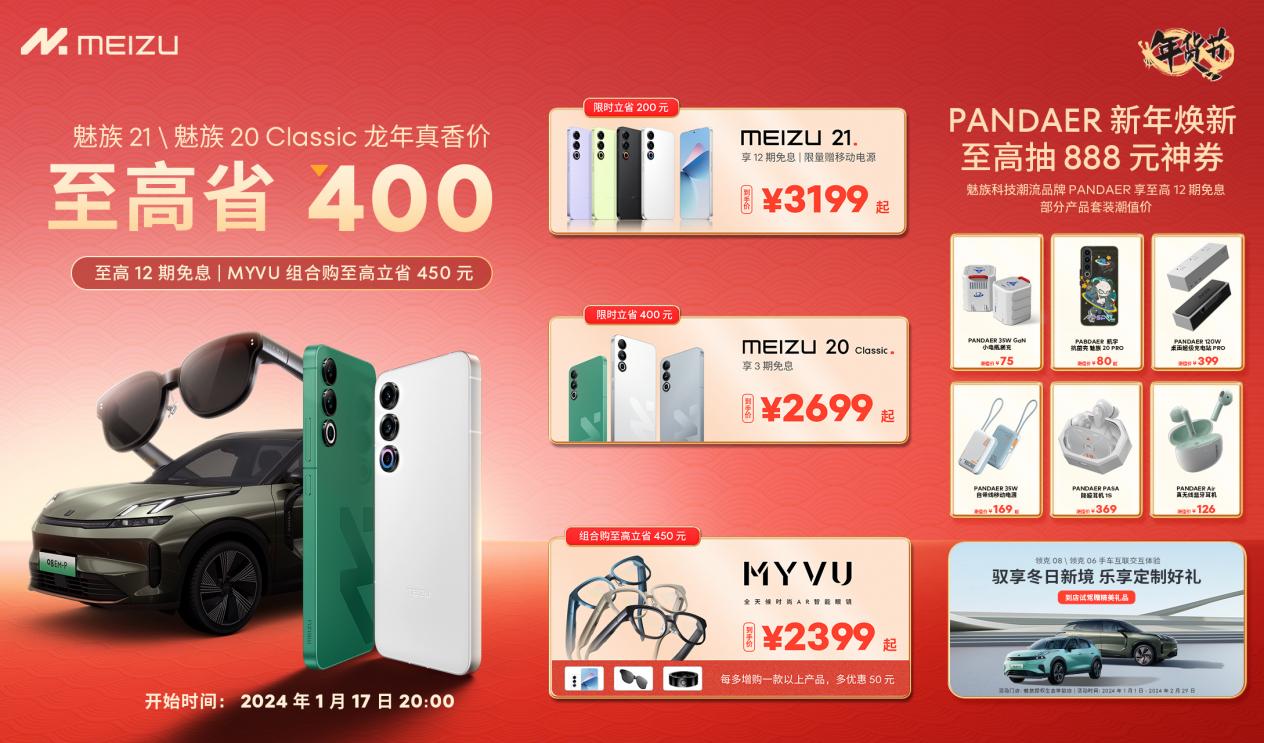
魅族年货节即将于2024年1月17日20时开启,主题为「龙年真香价」,将为消费者带来一系列超值优惠年货。其中,参与魅族年货节活动,购买魅族21立省200元,到手价3199元起,购买可享12期免息和限量赠移动电源优惠;购买魅族20Classic立省400元,到手价2699起,享3期免息。此外,魅族PANDAER年货节活动将于1月17日20时同步开始。该活动以龙年潮玩「吉」节为主题,购买参与抽奖,新年焕新最高可得888元神券。此外,部分产品还可享受下单赠好礼,跨店每满200元减30元的权益。在本次魅族年货节活
模型的最大似然是指在给定观察数据的情况下,通过调整模型参数使得观察数据出现的概率最大化。最大似然是一种统计方法,通过最大化似然函数来估计模型参数。似然函数衡量了在给定模型参数的情况下观察到数据的可能性。通过最大似然估计,我们可以找到使得观察数据出现概率最大的参数集。最大似然原理指出,通过最大化似然函数,可以得到最可能的参数值,从而解释观测数据。在实践中,模型的最大似然常被用作模型选择和估计的标准。AIC和BIC是两种常见的方法,它们使用模型的最大似然来平衡模型的拟合优度和复杂性。目标是找到具有最高最大似然
深度图像数据集是在深度学习和计算机视觉任务中非常重要的数据类型。它包含了每个像素的深度信息,可以用于多种应用,如场景重建、目标检测和姿态估计。本文将介绍几个常用的深度图像数据集,包括它们的来源、特点和应用。1.NYUDepthV2NYUDepthV2数据集包含室内场景的深度图像和RGB图像,共1449个场景样本。这些场景包括卧室、客厅、厨房等多种室内环境。每个场景都提供了相机的内参和外参信息,可用于相机姿态估计和场景重建等任务。此外,数据集还提供了场景中物体的标注信息,可用于物体检测和语义分割等任务。2.
时间序列建模是一种利用历史数据进行趋势和行为预测的方法。它适用于多个领域,包括经济学、金融学、气象学和工业生产等。通过对历史数据进行分析和建模,我们可以识别出数据中的模式和趋势,并利用这些信息来预测未来的趋势和行为。时间序列建模的过程涉及数据收集、清洗、探索性分析、模型选择和评估等步骤。例如,在金融领域,我们可以利用时间序列建模来预测股票价格的走势,帮助投资者做出更明智的决策。在本文中,我们将介绍时间序列建模的方法和过程,并提供实例来说明其应用价值。时间序列建模的常用方法包括时间序列分解、平稳性检验、自回
人工智能与机器学习的结合可以提供更深入的数据洞察力。对于企业来说,获取大量数据用于训练机器学习算法非常重要。然而,手动收集大规模训练数据集是不现实的,因为这会增加巨大的训练成本。因此,人工智能的出现解决了这个问题。通过人工智能技术,可以自动收集和整理大量数据,为机器学习提供充足的训练素材。这样,企业可以更有效地利用人工智能和机器学习的结合,从海量数据中获得更准确的洞察力。人工智能的应用将为数据工程师提供更好的数据准备和清洗工具,帮助确保数据的准确性。此外,人工智能技术还能自动化大部分数据工程师的任务,提高
填充在神经网络中是为了满足固定输入尺寸的要求而进行的一种处理。在神经网络中,输入数据的尺寸通常是固定的。如果输入数据的尺寸与网络的输入要求不一致,填充可以通过在输入数据的周围添加一些额外的虚拟数据来调整输入数据的尺寸,以便与网络的输入要求相匹配。因此,填充的主要目的是为了满足神经网络的输入要求。对于卷积神经网络(CNN)中的卷积操作来说,填充的作用是为了控制输出尺寸。卷积操作中,卷积核在输入数据上滑动,计算每个位置的卷积结果。如果输入数据和卷积核尺寸不一致,输出尺寸会变小,从而影响网络性能。因此,我们可以
KNN算法是一种简单易用的分类算法,适用于小规模数据集和低维特征空间。它在图像分类、文本分类等领域中表现出色,因其实现简单、易于理解而备受青睐。KNN算法的基本思想是通过比较待分类样本的特征与训练样本的特征,找到最接近的K个邻居,并根据这K个邻居的类别确定待分类样本的类别。KNN算法中使用已标记好类别的训练集和待分类的测试集。KNN算法的分类过程包括以下几个步骤:首先,计算待分类样本与所有训练样本之间的距离;其次,选择距离最近的K个邻居;然后,根据K个邻居的类别进行投票,得出待分类样本的类别;最后,将待分
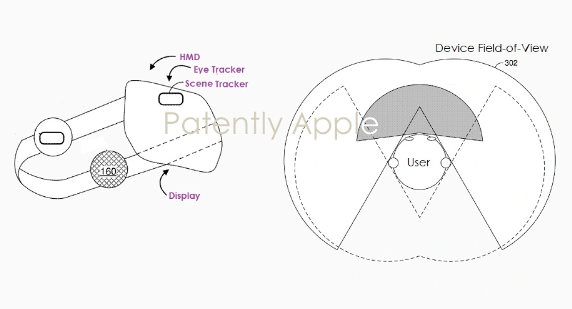
苹果公司最近获得了一项名为“手势激活的可操作项目”专利,这将进一步提升VisionPro头显以及其他设备的用户交互体验。这一专利已经由美国商标和专利局(USPTO)发布了公示清单根据所示意图,尤其是4A和4B部分,用户可以看到一个注视位置指示器,其将显示各种可用操作,而用户则可以通过手势来激活这些操作。这种创新的交互方式将为用户带来更加便利的控制体验根据小编的了解,专利中提到的一个例子是,使用VisionPro头显的用户只需要轻轻敲击自己的膝盖,就可以打开他们办公桌上的灯光。这种简单而直观的手势激活方式将
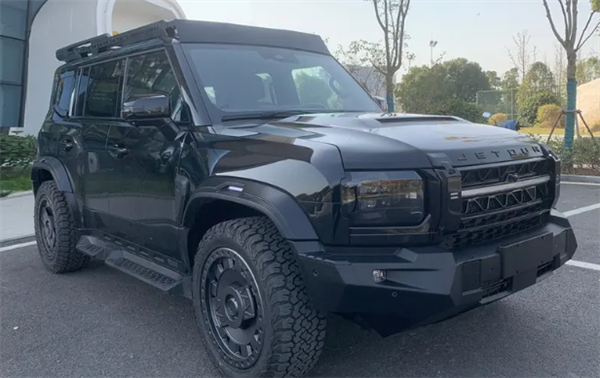
工信部公示的捷途旅行者JMK改装版申报信息已曝光,引起广泛关注。该车展示出独特的硬派风格,成为众人瞩目的焦点。捷途旅行者JMK改装版将于2024年1月28日正式上市。该车在原有基础上进行了深度改装,呈现出更加粗犷和越野的外观,采用了黑化处理和多项越野元素,如前保险杠设计、隆起的机盖和凸出的轮眉等,展现出强烈的硬派越野气息。预计4月开始交付给消费者。在外观方面,新车采用了金属质感的脚踏和车顶行李架,同时还增加了20英寸的防脱圈轮圈,使整体造型更加炫酷。车尾部分,坚固的后杠与前杠相呼应,并配备了外挂式备胎,进
AI系统使用带注释的数据进行训练,以便创建准确且针对特定目标的模型。在数据注释过程中,元数据标签用于定义数据集的特征。这些元数据包括突出显示短语、关键字或句子等属性的标签。文字标注的质量对于构建高精度模型至关重要。在本文中,我们将重点介绍文字标注的概念和不同类型。什么是文字标注AI文字标注是将标签与数字文本文件及其内容相关联的过程。它将文本注释转换为数据集,这个数据集可以用于训练各种自然语言处理算法和计算机视觉应用的模型。这种标注方法能够提供有价值的信息,帮助机器理解和处理文本数据。简单来说,文字标注是根
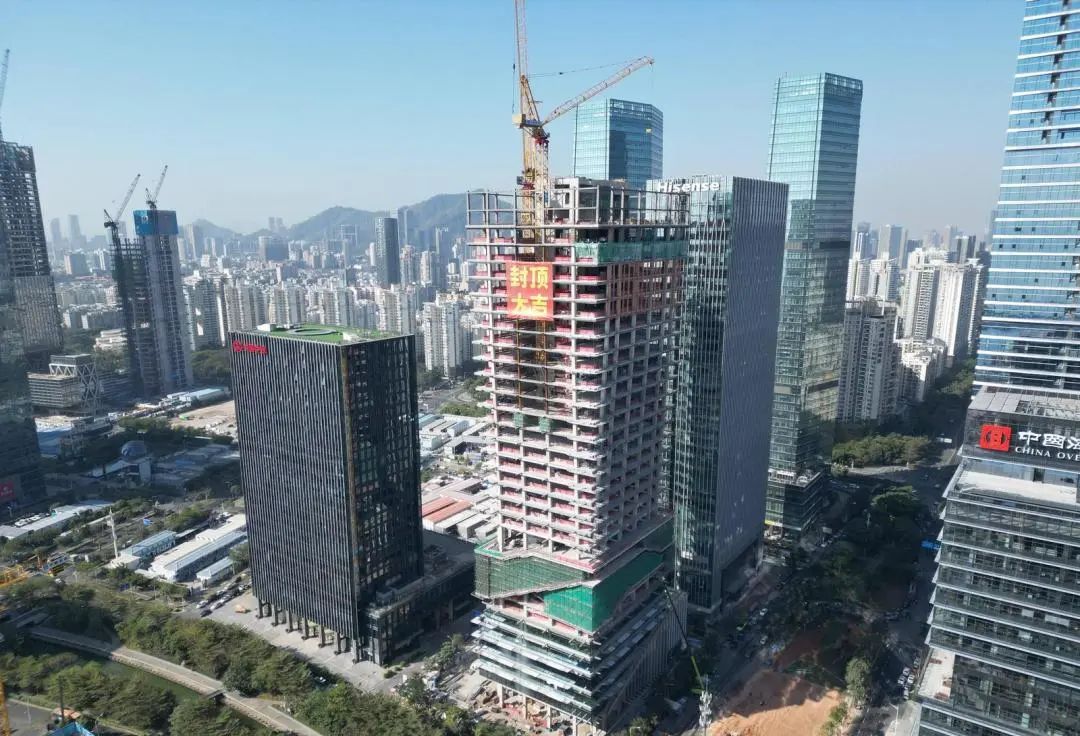
据南山区政府官方微信公众号“创新南山”透露,深圳字节跳动后海中心项目最近取得了重要进展。根据中建一局建设发展公司的消息,该项目主体结构提前3天全部完成封顶工作。这一消息意味着南山后海核心区将迎来一个新的地标建筑。深圳字节跳动后海中心项目位于南山区后海核心区,是今日头条科技有限公司在深圳市的总部办公大楼。总建筑面积为7.74万平方米,高约150米,共有地下4层和地上32层。据悉,深圳字节跳动后海中心项目将成为一座创新型超高层建筑,集办公、娱乐、餐饮等功能为一体。该项目将有助于深圳推动互联网产业的集聚和发展,
本站1月20日消息,据央视新闻,在今天举行的第七届货运物流行业年会上,中国物流与采购联合会会长何黎明介绍说,2023年我国物流市场实现恢复增长,预计2023年全年社会物流总额将达350万亿元。全年快递业务量达1320亿件,连续十年稳居世界第一。截至2023年底,我国A级物流企业,即企业经营状况较好、市场竞争力较强的物流企业超过9600家。2023年中国物流50强企业物流业务收入合计超过2.3万亿元。据第六次全国物流园区调查显示,全国规上物流园区超过2500个。重大物流基础设施布局建设加快,国家物流枢纽达到
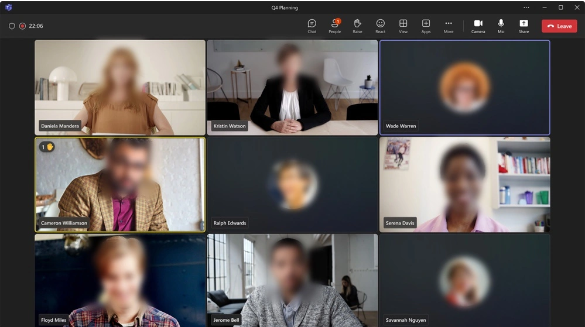
微软最近宣布,将在本月底为广受欢迎的Teams应用推出一系列界面更新。这些新功能将作为公开预览版本的一部分提供给用户。据了解,这次更新将大大改善用户的会议体验,并提供更加灵活和个性化的界面选项。用户可以期待更流畅的会议功能,以及更多定制化的界面设置。这将进一步提升Teams应用的实用性和用户体验。根据微软的详细介绍,新版本的Teams应用将采用16:9的会议视图窗口比例,提供更宽广、清晰的视觉体验。应用还默认使用4x4的网格布局,使参会者视频窗口更整齐、有序。用户可以根据需求自由调整单一窗口中显示的参会者
SVM是一种常用于分类和回归问题的经典监督学习算法。其核心思想是通过找到一个最佳的超平面,将不同类别的数据分隔开来。为了进一步优化SVM模型的性能,常常使用网格搜索来进行参数优化。网格搜索通过尝试不同的参数组合,从而寻找到最优的参数组合,以提高模型的性能。这一过程可以有效地帮助我们调整模型的超参数,以达到更好的预测结果。下面将介绍SVM网格搜索的详细过程。首先,我们先了解SVM算法中有两个关键的参数:C和gamma。1.C参数C参数是SVM的惩罚系数,其值越小,模型对误分类的容忍度越高,倾向于选择更大的间
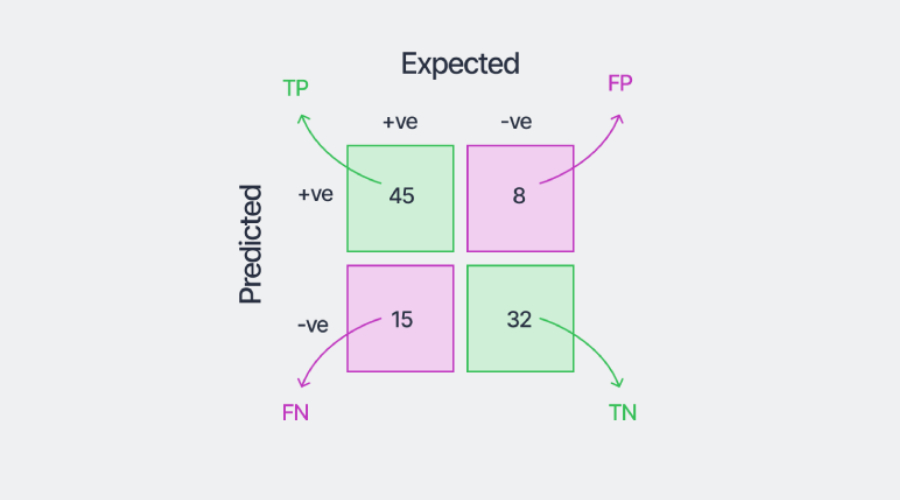
混淆矩阵是一种评估模式,帮助机器学习工程师更了解模型性能。本文以一个二元类不平衡数据集为例,测试集由60个正类样本和40个负类样本组成,用于评估机器学习模型。二元类数据集仅有两个不同类别的数据,可简单命名为“正面”和“负面”类别。现在,要完全理解这个二分类问题的混淆矩阵,我们首先需要熟悉以下术语:TruePositive(TP)是指属于正类的样本被正确分类。TrueNegative(TN)是指属于负类的样本被正确分类。FalsePositive(FP)是指属于阴性类的样本被错误地分类为属于阳性类。Fals
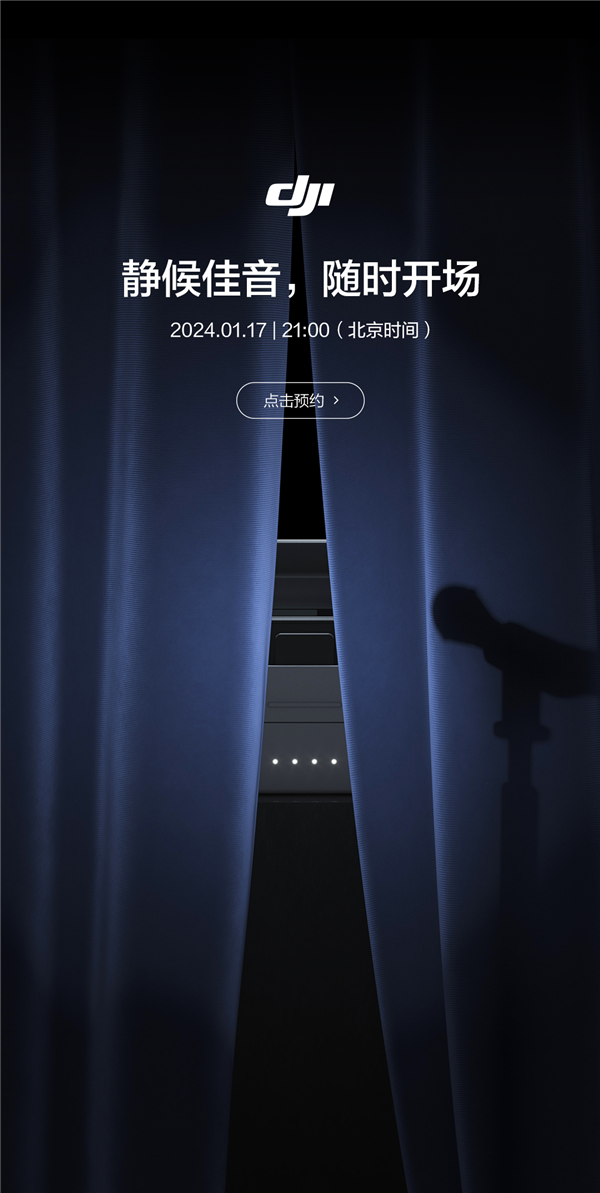
大疆科技宣布明日(1月17日)21:00分将举办新品发布会,主题为“静候佳音,随时开场”。此消息引起了广泛关注。根据发布会前夕流出的海报显示,麦克风剪影成为了视觉焦点,同时海报中帷幕后方隐约展示了新品及其收纳盒的一角,这些细节暗示着大疆可能推出一款麦克风设备。经进一步了解,从海报中还可以观察到收纳盒支持四点电量显示功能,这一设计与大疆当前热销的DJIMic无线麦克风如出一辙。市场观察人士因此推测,新品很有可能是此前已经多次曝光的DJIMIC2。根据这些观察和推测,我们可以预测新品将继承DJIMIC2的优秀
单变量单变量数据分析是简单的分析类型,适用于只有一个变化的变量。它主要关注数据的描述和模式识别,而不涉及原因和关系。因为信息处理的是单一变量,所以它是最简单的分析类型。单变量分析用于对单个变量/特征进行分析。其目标是获取数据并对其进行描述和总结,同时检查可能存在的任何模式。单变量分析分别研究数据集中的每个变量,可以使用分类变量和数值变量两种类型的变量。集中趋势度量(平均值、中位数和众数)以及数据离差或分布(范围、最小值、最大值、四分位数、方差和标准差)能够帮助我们描述此类数据中的模式。此外,频率分布表、直

火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。




