

Java怎么实现克鲁斯卡尔算法
克鲁斯卡尔算法克鲁斯卡尔算法是一种用于求解最小生成树问题的贪心算法。最小生成树是一个连通无向图中生成树中边权值和最小的生成树。克鲁斯卡尔算法按边权值从小到大的顺序依次选择边,当所选的边不会形成环时,将其加入到生成树中。具体实现过程如下:将所有边按照边权值从小到大排序。依次选择边,如果选择的边的两个端点不在同一个连通分量中,则将这条边加入到最小生成树中,并将两个端点合并为同一个连通分量。直到最小生成树中包含了图中的所有顶点为止。算法的优点在于只需要关注边的权值,而与顶点的度数无关,因此在稠密图中也能表现出较
克鲁斯卡尔算法
克鲁斯卡尔算法是一种用于求解最小生成树问题的贪心算法。最小生成树是一个连通无向图中生成树中边权值和最小的生成树。克鲁斯卡尔算法按边权值从小到大的顺序依次选择边,当所选的边不会形成环时,将其加入到生成树中。具体实现过程如下:
将所有边按照边权值从小到大排序。
依次选择边,如果选择的边的两个端点不在同一个连通分量中,则将这条边加入到最小生成树中,并将两个端点合并为同一个连通分量。
直到最小生成树中包含了图中的所有顶点为止。
算法的优点在于只需要关注边的权值,而与顶点的度数无关,因此在稠密图中也能表现出较好的性能。同时,克鲁斯卡尔算法还具有较好的可扩展性,可以很方便地处理带权图中的最小生成森林问题。
执行流程
将所有的边按照权值从小到大排序;
依次遍历每条边,如果这条边连接的两个节点不在同一个连通分量中,则将这条边加入生成树,并将这两个节点合并为一个连通分量;
重复步骤 2 直到所有的节点都在同一个连通分量中,此时生成的树即为最小生成树。
在实现过程中,通常使用并查集来维护连通性,以提高效率。
代码实现
import java.util.*;

public class KruskalAlgorithm {

    // 定义边的数据结构
    class Edge implements Comparable {
        int src, dest, weight;

        public int compareTo(Edge edge) {
            return this.weight - edge.weight;
        }
    }

    // 并查集数据结构
    class Subset {
        int parent, rank;
    }

    int V, E; // V是顶点数,E是边数
    Edge edge[]; // 存储边的数组

    // 构造函数,初始化边和顶点数
    KruskalAlgorithm(int v, int e) {
        V = v;
        E = e;
        edge = new Edge[E];
        for (int i = 0; i < e; ++i)
            edge[i] = new Edge();
    }

    // 查找父节点
    int find(Subset subsets[], int i) {
        if (subsets[i].parent != i)
            subsets[i].parent = find(subsets, subsets[i].parent);
        return subsets[i].parent;
    }

    // 合并两个子集
    void union(Subset subsets[], int x, int y) {
        int xroot = find(subsets, x);
        int yroot = find(subsets, y);

        if (subsets[xroot].rank < subsets[yroot].rank)
            subsets[xroot].parent = yroot;
        else if (subsets[xroot].rank > subsets[yroot].rank)
            subsets[yroot].parent = xroot;
        else {
            subsets[yroot].parent = xroot;
            subsets[xroot].rank++;
        }
    }

    // 执行克鲁斯卡尔算法
    void kruskal() {
        Edge result[] = new Edge[V]; // 存储结果的数组
        int e = 0; // 表示result数组中的下标

        // 将边按照权重从小到大排序
        Arrays.sort(edge);

        // 创建V个子集
        Subset subsets[] = new Subset[V];
        for (int i = 0; i < V; ++i)
            subsets[i] = new Subset();

        // 初始化每个子集的父节点和秩
        for (int v = 0; v < V; ++v) {
            subsets[v].parent = v;
            subsets[v].rank = 0;
        }

        // 取E-1条边
        int i = 0;
        while (e < V - 1) {
            Edge next_edge = new Edge();
            next_edge = edge[i++];

            int x = find(subsets, next_edge.src);
            int y = find(subsets, next_edge.dest);

            // 如果两个节点不在同一个集合中,合并它们
            if (x != y) {
                result[e++] = next_edge;
                union(subsets, x, y);
            }
        }

        // 打印结果
        System.out.println("Following are the edges in the constructed MST");
        for (i = 0; i < e; ++i){
            System.out.println(result[i].src + " - " + result[i" - " + result[i].weight);
            return;
        }

        // 定义一个辅助函数,用于查找结点所在的集合
        private int find(int parent[], int i) {
            if (parent[i] == -1)
                return i;
            return find(parent, parent[i]);
        }

        // 定义一个辅助函数,用于合并两个集合
        private void union(int parent[], int x, int y) {
            int xset = find(parent, x);
            int yset = find(parent, y);
            parent[xset] = yset;
        }
    }
}
函数使用Arrays类的sort方法,按照边的权重从小到大对边进行排序。然后,函数依次遍历排序后的边,对于每条边,使用find函数查找其src和dest所在的集合的根节点。如果根节点不同,则说明这两个集合不连通,可以合并,并将边加入最小生成树的结果数组result中。最后,函数遍历最小生成树的结果数组result,并输出每条边的起点、终点和权重。
该实现中,使用了快速查找集合的方法,即使用并查集来实现。每个结点都有一个parent数组,其中parent[i]表示结点i的父节点,如果parent[i] == -1,则说明结点i为根节点。在查找结点所在的集合时,如果当前结点的父节点为-1,则说明该结点为根节点,直接返回;否则,递归查找其父节点所在的集合。在合并两个集合时,找到要合并的两个集合的根节点,将其中一个根节点的父节点设为另一个根节点的索引,即将一个集合的根节点合并到另一个集合的根节点下。
这样实现的克鲁斯卡尔算法时间复杂度为O(ElogE),其中E表示图中的边数,主要的时间开销在于排序边的过程。空间复杂度为O(V+E),其中V表示图中的顶点数,主要的空间开销在于存储边和parent数组。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
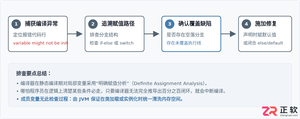
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
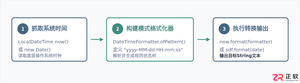
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
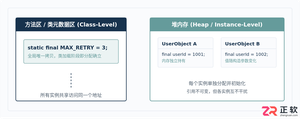
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
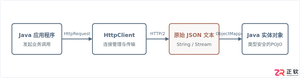
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
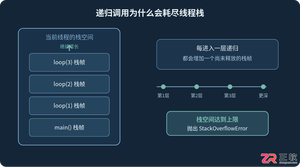
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
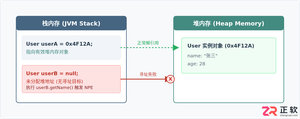
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



