

什么情况下会导致MySQL索引失效?
一、准备工作首先准备两张表用于演示:CREATETABLE`student_info`(`id`intNOTNULLAUTO_INCREMENT,`student_id`intNOTNULL,`name`varchar(20)DEFAULTNULL,`course_id`intNOTNULL,`class_id`intDEFAULTNULL,PRIMARYKEY(`id`))ENGINE=InnoDBAUTO_INCREMENT=1000001DEFAULTCHARSET=utf8;CREATETABLE
一、准备工作
首先准备两张表用于演示:
CREATE TABLE `student_info` (
  `id` int NOT NULL AUTO_INCREMENT,
  `student_id` int NOT NULL,
  `name` varchar(20) DEFAULT NULL,
  `course_id` int NOT NULL,
  `class_id` int DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=1000001 DEFAULT CHARSET=utf8;
CREATE TABLE `course` (
  `id` int NOT NULL AUTO_INCREMENT,
  `course_id` int NOT NULL,
  `course_name` varchar(40) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=101 DEFAULT CHARSET=utf8;
#准备数据
select count(*) from student_info;#1000000
select count(*) from course;      #100
二、索引失效规则
1.优先使用联合索引
如下一条sql语句是没有索引的情况:
#平均耗时291毫秒
select * from student_info where name='123' and course_id=1 and class_id=1;
我们通过建立索引来优化它的查询效率,有如下几种方案:
①建立普通索引:
#建立普通索引
create index idx_name on student_info(name);
#平均耗时25毫秒,查看explain执行计划,使用到的是idx_name索引查询
select * from student_info where name='MOKiKb' and course_id=1 and class_id=1;
②在普通索引的基础上,再增加联合索引:
#name,course_id组成的联合索引
create index idx_name_courseId on student_info(name,course_id);
#该查询语句一般使用的是联合索引,而不是普通索引,具体看优化器决策
#平均耗时20ms
select * from student_info where name='zhangsan' and course_id=1 and class_id=1;

可以看到,在多个索引都可以使用时,系统一般优先使用更长的联合索引,因为联合索引相比来说更快,这点应该也很好理解,前提是要遵守联合索引的最左匹配原则。
如果再创建一个name,course_id,class_id组成的联合索引,那么上述sql语句不出意外会使用这个key_len更长的联合索引(意外是优化器可能会选择其他更优的方案,如果它更快的话)。
联合索引速度不一定优于普通索引,比如第一个条件就过滤了所有记录,那么就没必要用后序的索引了。
2.最左匹配原则
#删除前例创建的索引,新创建三个字段的联合索引,name-course_id-cass_id
create index idx_name_cou_cls on student_info(name,course_id,class_id);
①联合索引全部匹配的情况:
#关联字段的索引比较完整
explain select * from student_info where name='11111' and course_id=10068 and class_id=10154;

该sql语句符合最左前缀原则,每个字段条件中的字段恰好和联合索引吻合。这种情况是最优的,因为依靠一个联合索引就可以快速查找,不需要额外的查询。
②联合索引最右边缺失的情况:
explain select * from student_info where name='11111' and course_id=10068;

该sql语句条件中,并不含有联合索引的全部条件,而是抹去了右半部分,该语句使用的索引依旧是该关联查询,只不过只用到了一部分,通过查看key_len可以知道少了5字节,这5字节对应的是class_id,证明class_id并未生效而已(where中没有,当然用不到啦)。
同理,抹掉where中的course_id字段,联合索引依旧会生效,只是key_len会减小。
③联合索引中间缺失的情况:
#联合索引中间的字段未使用,而左边和右边的都存在
explain select * from student_info where name='11111' and class_id=10154;;

如上sql语句依旧使用的是联合索引,但是它的key_len变小了,只有name字段使用到了索引,而class_id字段虽然在联合索引中,但是因为不符合最左匹配原则而GG了。
整个sql语句的执行流程为:先在联合索引的B树中找到所有name为11111的记录,然后全文过滤掉这些记录中class_id不是10154的记录。多了一个全文搜索的步骤,相比于①和②情况性能会更差。
④联合索引最左边缺失的情况:
explain select * from student_info where class_id=10154 and course_id=10068;

该情况是上一个情况的特例,联合索引中最左边的字段未找到,所以虽然有其他部分,但是统统都失效了,走的是全文查找。
结论:最左匹配原则指的是查询从索引的最左列开始,并且不能跳过索引中的列,如果跳过了某一列,索引将部分失效(后面的字段索引全部失效)。
注意:创建联合索引时,字段的顺序就定格了,最左匹配就是根据该顺序比较的;但是在查询语句中,where条件中字段的顺序是可变的,意味着不需要按照关联索引字段的顺序,只要where条件中有就行了。
3.范围条件右边的列索引失效
承接上面的联合索引,使用如下sql查询:
#key_len=> name:63,course_id:5,class_id:5
explain select * from student_info where name='11111' and course_id>1 and class_id=1;

key_len只有68,代表关联索引中class_id未使用到,虽然符合最左匹配原则,但因为>符号让关联索引中该条件字段右边的索引失效了。
但如果使用>=号的话:
#不是>、<,而是>=、<=
explain select * from student_info where name='11111' and course_id>=20 and course_id<=40 and class_id=1;
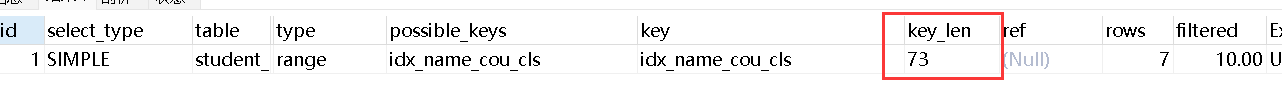
右边的索引并未失效,key_len为73,所有字段的索引都使用到了。
结论:为了充分利用索引,我们有时候可以将>、<等价转为>=、<=的形式,或者将可能会有<、>的条件的字段尽量放在关联索引靠后的位置。
4.计算、函数导致索引失效
#删除前面的索引,新创建name字段的索引,方便演示
create index idx_name on student_info(name);
现有一个需求,找出name为li开头的学生信息:
#使用到了索引
explain select * from student_info where name like 'li%';
#未使用索引,花费时间更久
explain select * from student_info where LEFT(name,2)='li';
上面的两条sql语句都可以满足需求,然而第一条语句用了索引,第二条没有,一点点的改变真是天差地别。
结论:字段使用函数会让优化器无从下手,B树中的值和函数的结果可能不搭边,所以不会使用索引,即索引失效。字段能不用就不用函数。
类似:
#也不会使用索引
explain select * from student_info where name+''='lisi';
类似的对字段的运算也会导致索引失效。
5.类型转换导致索引失效
#不会使用name的索引
explain select * from student_info where name=123;
#使用到索引
explain select * from student_info where name='123';
如上,name字段是VARCAHR类型的,但是比较的值是INT类型的,name的值会被隐式的转换为INT类型再比较,中间相当于有一个将字符串转为INT类型的函数。
6.不等于(!= 或者<>)索引失效
#创建索引
create index idx_name on student_info(name);
#索引失效
explain select * from student_info where name<>'zhangsan';
explain select * from student_info where name!='zhangsan';
不等于的情况是不会使用索引的。因为!=代表着要进行全文的查找,用不上索引。
7.is null可以使用索引,is not null无法使用索引
#可以使用索引
explain select * from student_info where name is null;
#索引失效
explain select * from student_info where name is not null;
和前一个规则类似的,!=null。同理not like也无法使用索引。
最好在设计表时设置NOT NULL约束,比如将INT类型的默认值设为0,将字符串默认值设为''。
8.like以%开头,索引失效
#使用到了索引
explain select * from student_info where name like 'li%';
#索引失效
explain select * from student_info where name like '%li';
只要以%开头就无法使用索引,因为如果以%开头,在B树排序的数据中并不好找。
9.OR前后存在非索引的列,索引失效
#创建好索引
create index idx_name on student_info(name);
create index idx_courseId on student_info(course_id);
如果or前后都是索引:
#使用索引
explain select * from student_info where name like 'li%' or course_id=200;
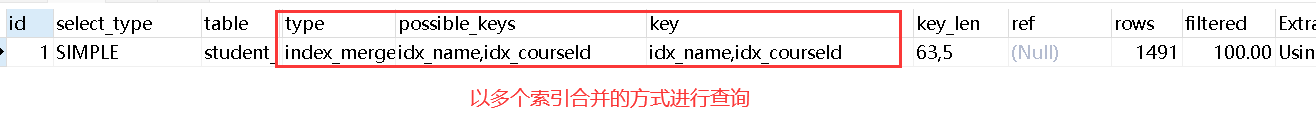
如果其中一个没有索引:
explain select * from student_info where name like 'li%' or class_id=1;
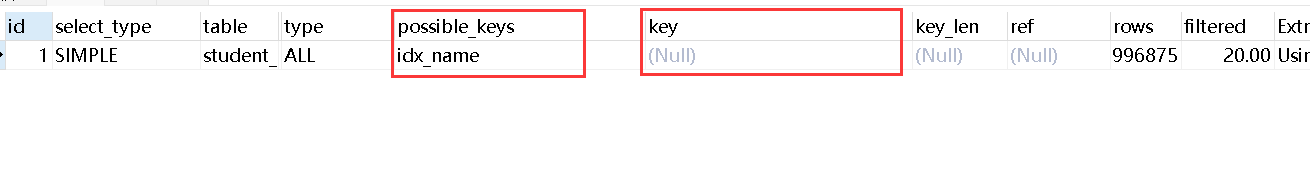
那么索引就失效了,假设还是使用索引,那就变成了先通过索引查,然后再根据没有的索引的字段进行全表查询,这种方式还不如直接全表查询来的快。
10.字符集不统一
字符集如果不同,会存在隐式的转换,索引也会失效,所有应该使用相同的字符集,防止这种情况发生。
三、建议
对于单列索引,尽量选择针对当前query过滤性更好的索引
在选择组合索引时,query过滤性最好的字段应该越靠前越好
在选择组合索引时,尽量选择能包含当前query中where子句中更多字段的索引
在选择组合索引时,如果某个字段可能出现范围查询,尽量将它往后放
详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。
深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。
刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。
深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。
后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。
针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。
本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



