

Python中的Deque: 实现高效的队列和堆栈操作
Python中的deque是一个低级别的、高度优化的双端队列,对于实现优雅、高效的Pythonic队列和堆栈很有用,它们是计算中最常见的列表式数据类型。本文中,云朵君将和大家一起学习如下:开始使用deque有效地弹出和追加元素访问deque中的任意元素用deque构建高效队列开始使用Deque向Python列表的右端追加元素和弹出元素的操作,一般非常高效。如果用大O表示时间复杂性,那么可以说它们是O(1)。而当Python需要重新分配内存来增加底层列表以接受新的元素时,这些操作就会变
Python 中的 deque 是一个低级别的、高度优化的双端队列,对于实现优雅、高效的Pythonic 队列和堆栈很有用,它们是计算中最常见的列表式数据类型。
本文中,云朵君将和大家一起学习如下:
- 开始使用deque
- 有效地弹出和追加元素
- 访问deque中的任意元素
- 用deque构建高效队列
开始使用Deque
向 Python 列表的右端追加元素和弹出元素的操作,一般非常高效。如果用大 O 表示时间复杂性,那么可以说它们是 O(1)。而当 Python 需要重新分配内存来增加底层列表以接受新的元素时,这些操作就会变慢,时间复杂度可能变成 O(n)。
此外,在 Python 列表的左端追加和弹出元素的操作,也是非常低效的,时间复杂度为O(n)。
由于列表提供了 .append() 和 .pop() 这两种操作,它们可以作为堆栈和队列使用。而列表的左右端追加和弹出操作的性能问题会大大影响应用程序的整体性能。
Python 的 deque 是早在 Python 2.4 中添加到 collections 模块的第一个数据类型。这个数据类型是专门为克服 Python list 中的 .append()和 .pop() 的效率问题而设计的。
Deques是类似于序列的数据类型,被设计为堆栈和队列的一般化,它们在数据结构的两端支持高效的内存和快速的追加和弹出操作。
在 deque 对象两端的追加和弹出操作是稳定的,而且同样有效,因为 deque 是作为双链接列表实现。此外,deque 上的追加和弹出操作也是线程安全的和内存高效的。这些特性使得 deque 在Python中创建自定义栈和队列时特别有用。
如果需要保存最后看到的元素列表,也可以使用 deque,因为可以限制 deque 的最大长度。如果我们这样做了,那么一旦 deque 满了,当我们在另一端添加新的元素时,它会自动丢弃一端的元素。
下面是 deque 的主要特点的总结:
- 存储任何数据类型的元素
- 是可变数据类型
- 支持带in操作符的成员操作
- 支持索引,比如a_deque[i]
- 不支持切片,比如a_deque[0:2]
- 支持对序列和可迭代对象进行操作的内置函数,如 len() ,sorted() ,reversed() 等
- 不支持inplace 排序
- 支持正常迭代和反向迭代
- 支持使用pickle
- 确保在两端快速、内存高效和线程安全的弹出和追加操作
创建 deque 实例比较简单。只需要从 collection 中导入 deque,然后用一个可选的迭代器作为参数来调用它。
>>> from collections import deque

>>> # 创建一个空的 deque
>>> deque()
deque([])

>>> # 使用不同的迭代器来创建 deque
>>> deque((1, 2, 3, 4))
deque([1, 2, 3, 4])

>>> deque([1, 2, 3, 4])
deque([1, 2, 3, 4])

>>> deque(range(1, 5))
deque([1, 2, 3, 4])

>>> deque("abcd")
deque(['a', 'b', 'c', 'd'])

>>> numbers = {"one": 1, "two": 2, "three": 3, "four": 4}
>>> deque(numbers.keys())
deque(['one', 'two', 'three', 'four'])

>>> deque(numbers.values())
deque([1, 2, 3, 4])

>>> deque(numbers.items())
deque([('one', 1), ('two', 2), ('three', 3), ('four', 4)])
如果实例化 deque 时没有提供 iterable 作为参数,那么会得到一个空的 deque。如果提供并输入 iterable ,那么 deque 会用它的数据初始化新实例。初始化使用 deque.append() 从左到右进行。
Deque 初始化器需要以下两个可选参数。
- iterable一个提供初始化数据的迭代器。
- maxlen一个整数,指定deque的最大长度。
如前所述,如果不提供一个 iterable ,那么你会得到一个空的 deque。如果给 maxlen 提供一个值,那么你的 deque 只会存储最多的 maxlen 项。
最后,还可以使用无序的可迭代对象,如 collections 来初始化 deque。在这些情况下,不会有最终 deque 中元素的预定义顺序。
有效地弹出和追加元素
Deque 和 List 之间最重要的区别是,前者可以在序列的两端进行有效的追加和弹出操作。Deque 类实现了专门的 .popleft() 和 .appendleft() 方法,直接对序列的左端进行操作。
>>> from collections import deque

>>> numbers = deque([1, 2, 3, 4])
>>> numbers.popleft()
1
>>> numbers.popleft()
2
>>> numbers
deque([3, 4])

>>> numbers.appendleft(2)
>>> numbers.appendleft(1)
>>> numbers
deque([1, 2, 3, 4])
在这里,使用 .popleft() 和 .appendleft() 来分别弹出和增加 numbers的左端值。这些方法是针对deque的设计的,而 list 没有这样的方法。
Deque也提供了像list一样的 .append() 和 .pop() 方法来对序列的右端进行操作。然而,.pop() 的行为是不同的。
>>> from collections import deque

>>> numbers = deque([1, 2, 3, 4])
>>> numbers.pop()
4

>>> numbers.pop(0)
Traceback (most recent call last):
File "", line 1, in
TypeError: pop() takes no arguments (1 given)
在这里,.pop() 删除并返回 deque 容器中的最后一个元素。该方法不接受索引作为参数,因此不能使用它从 deque 中删除任意项。只能使用它来删除并返回最右边的项。
我们认为 deque 是一个双链表。因此,给定 deque 容器中的每一项都保存着序列中上下一项的引用(指针)。
双链表使得从两端添加和弹出元素的操作变得简单而高效,因为只有指针需要更新,因此,这两个操作具有相似的性能,均为O(1)。它们在性能方面也是可预测的,因为不需要重新分配内存和移动现有项来接受新项。
从常规 Python 列表的左端追加和弹出元素需要移动所有元素,这最终是一个 O(n) 操作。此外,将元素添加到列表的右端通常需要Python重新分配内存,并将当前项复制到新的内存位置,之后,它可以添加新项。这个过程需要更长的时间来完成,并且追加操作从 O(1)传递到 O(n)。
考虑以下关于在序列左端添加项的性能测试,deque vs list。
# time_append.py

from collections import deque
from time import perf_counter

TIMES = 10_000
a_list = []
a_deque = deque()

def average_time(func, times):
total = 0.0
for i in range(times):
start = perf_counter()
func(i)
total += (perf_counter() - start) * 1e9
return total / times

list_time = average_time(lambda i: a_list.insert(0, i), TIMES)
deque_time = average_time(lambda i: a_deque.appendleft(i), TIMES)
gain = list_time / deque_time

print(f"list.insert(){list_time:.6} ns")
print(f"deque.appendleft() {deque_time:.6} ns({gain:.6}x faster)")
在这个脚本中,average_time() 计算了执行一个给定次数的函数(func)的平均时间。如果我们在命令行中运行该脚本,那么我们会得到以下输出。
$ python time_append.py
list.insert()3735.08 ns
deque.appendleft() 238.889 ns(15.6352x faster)
在这个例子中,deque 上的 .appendleft() 要比 list 上的 .insert() 快几倍。注意 deque.appendleft() 执行时间是常量O(1)。但列表左端的 list.insert() 执行时间取决于要处理的项的数量O(n)。
在这个例子中,如果增加 TIMES 的值,那么 list.insert() 会有更高的时间测量值,而 deque.appendleft() 会得到稳定(常数)的结果。如果对 deque 和 list 的 pop 操作进行类似的性能测试,那么可以展开下面的练习块。
Exercise:测试 deque.popleft() 与 list.pop(0) 的性能
可以将上面的脚本修改为时间deque.popleft()与list.pop(0)操作并估计它们的性能。
Solution:测试 deque.popleft() 与 list.pop(0) 的性能
# time_pop.py

from collections import deque
from time import perf_counter

TIMES = 10_000
a_list = [1] * TIMES
a_deque = deque(a_list)

def average_time(func, times):
total = 0.0
for _ in range(times):
start = perf_counter()
func()
total += (perf_counter() - start) * 1e9
return total / times

list_time = average_time(lambda: a_list.pop(0), TIMES)
deque_time = average_time(lambda: a_deque.popleft(), TIMES)
gain = list_time / deque_time

print(f"list.pop(0) {list_time:.6} ns")
print(f"deque.popleft() {deque_time:.6} ns({gain:.6}x faster)")
list.pop(0) 2002.08 ns deque.popleft() 326.454 ns(6.13282x faster) 同样,它deque比list从底层序列的左端删除元素要快。 尝试更改TIMES的值,看看会发生什么
Deque 数据类型的设计是为了保证在序列的两端进行有效的追加和弹出操作。它是处理需要在 Python 中实现队列和堆栈数据结构的问题的理想选择。
访问Deque中的任意元素
Python 的 deque 返回可变的序列,其工作方式与列表相当类似。除了可以有效地从其末端追加和弹出元素外,deque 还提供了一组类似列表的方法和其他类似序列的操作,以处理任意位置的元素。下面是其中的一些。
选项 | 描述 |
.insert(i, value) | 在索引为i的deque容器中插入一个名为value的元素。 |
.remove (value) | 删除第一个出现的 value ,如果 value 不存在则引发ValueError |
a_deque[i] | 从一个deque容器中检索索引为 i 的项。 |
del a_deque[i] | 从deque容器中移除索引为 i 的项。 |
我们可以使用这些方法和技术来处理 deque 对象内部任何位置的元素。下面是如何做到这一点的。
>>> from collections import deque
>>> letters = deque("abde")
>>> letters.insert(2, "c")
>>> letters
deque(['a', 'b', 'c', 'd', 'e'])

>>> letters.remove("d")
>>> letters
deque(['a', 'b', 'c', 'e'])

>>> letters[1]
'b'

>>> del letters[2]
>>> letters
deque(['a', 'b', 'e'])
在这里,首先将"c"插入到位置 2的letters中。然后使用 .remove() 从deque容器中移除"d"。Deque 还允许索引来访问元素,在这里使用它来访问索引1处的b。最后,你可以使用 del 关键字从 deque 中删除任何存在的项。请注意, .remove() 允许按值删除项,而del则按索引删除项。
尽管 deque 对象支持索引,但它们不支持切片,即不能像常规列表一样使用切片语法, [start:stop:step] 从现有的 deque 中提取:
>>> from collections import deque
>>> numbers = deque([1, 2, 3, 4, 5])
>>> numbers[1:3]
Traceback (most recent call last):
File "", line 1, in
TypeError: sequence index must be integer, not 'slice'
Deque支持索引,却不支持分片。通常来说在一个链表上执行切片非常低效。
虽然 deque 与 list 非常相似,但 list 是基于数组的,而 deque 是基于双链表的。
Deque 基于双链表,在访问、插入和删除任意元素都是无效操作。如果需要执行这些操作,则解释器必须在deque中进行迭代,直到找到想要的元素。因而他们的时间复杂度是O(n)而不是O(1)。
下面演示了在处理任意元素时 deques 和 list 的行为。
# time_random_access.py

from collections import deque
from time import perf_counter

TIMES = 10_000
a_list = [1] * TIMES
a_deque = deque(a_list)

def average_time(func, times):
total = 0.0
for _ in range(times):
start = perf_counter()
func()
total += (perf_counter() - start) * 1e6
return total / times

def time_it(sequence):
middle = len(sequence) // 2
sequence.insert(middle, "middle")
sequence[middle]
sequence.remove("middle")
del sequence[middle]

list_time = average_time(lambda: time_it(a_list), TIMES)
deque_time = average_time(lambda: time_it(a_deque), TIMES)
gain = deque_time / list_time

print(f"list{list_time:.6} μs ({gain:.6}x faster)")
print(f"deque {deque_time:.6} μs")
这个脚本对插入、删除和访问一个 deque 和一个 list 中间的元素进行计时。如果运行这个脚本,得到如下所示的输出:
$ python time_random_access.py
list63.8658 μs (1.44517x faster)
deque 92.2968 μs
Deque并不像列表那样是随机访问的数据结构。因此,从 deque 的中间访问元素的效率要比在列表上做同样的事情低。这说明 deque 并不总是比列表更有效率。
Python 的 deque 对序列两端的操作进行了优化,所以它们在这方面一直比 list 好。另一方面,列表更适合于随机访问和固定长度的操作。下面是 deque 和 list 在性能上的一些区别。
运作 | | |
通过索引访问任意的元素 | O(n) | O(1) |
在左端弹出和追加元素 | O(1) | O(n) |
在右端弹出和追加元素 | O(1) | O(1) + 重新分配 |
在中间插入和删除元素 | O(n) | O(n) |
对于列表,当解释器需要扩大列表以接受新项时,.append()的性能优势受到内存重新分配的影响而被降低。此操作需要将所有当前项复制到新的内存位置,这将极大地影响性能。
此总结可以帮助我们为手头的问题选择适当的数据类型。但是,在从列表切换到 deque 之前,一定要对代码进行剖析,它们都有各自的性能优势。
用Deque构建高效队列
Deque 是一个双端队列,提供了堆栈和队列的泛化。在本节中,我们将一起学习如何使用deque以优雅、高效和Pythonic的方式在底层实现我们自己的队列抽象数据类型(ADT)。
注意: 在 Python 标准库中,queue 模块实现了多生产者、多消费者的队列,可以在多个线程之间安全地交换信息。
如果你正在处理队列,那么最好使用那些高级抽象而不是 deque ,除非你正在实现自己的数据结构。
队列是元素的collections,可以通过在一端添加元素和从另一端删除元素来修改队列。
队列 以先入先出(FIFO)的方式管理元素,像一个管道一样工作,在管道的一端推入新元素,并从另一端弹出旧元素。向队列的一端添加一个元素称为 enqueue 操作;从另一端删除一个元素称为 dequeue。
为了更好地理解队列,以餐厅为例,餐馆里有很多人在排队等着点餐。通常情况下,后来的人将排在队列的末端。一旦有了空桌子,排在队伍开头的人就会离开队伍进去用餐。
下面演示了使用一个原始的deque对象来模拟这个过程。
>>> from collections import deque

>>> customers = deque()

>>> # People arriving
>>> customers.append("Jane")
>>> customers.append("John")
>>> customers.append("Linda")

>>> customers
deque(['Jane', 'John', 'Linda'])

>>> # People getting tables
>>> customers.popleft()
'Jane'
>>> customers.popleft()
'John'
>>> customers.popleft()
'Linda'

>>> # No people in the queue
>>> customers.popleft()
Traceback (most recent call last):
File "", line 1, in
IndexError: pop from an empty deque
首先创建一个空的 deque 对象来表示到达餐厅的人的队列。person排队放入队列,可以使用.append(),将单个条目添加到右端。要从队列中取出一个person,可以使用.popleft() ,删除并返回deque容器左侧的各个条目。
用队列模拟工作,然而,由于deque是一个泛化,它的API]不匹配常规的队列API。例如,不是.enqueue(),而是.append()。还有.popleft() 而不是.dequeue()。此外,deque 还提供了其他一些可能不符合特定需求的操作。
我们可以创建具有特定功能的自定义队列类。可以在内部使用 deque 来存储数据,并在自定义队列中提供所需的功能。我们可以把它看作是适配器设计模式的一个实现,在这个模式中,把 deque 的接口转换成看起来更像队列接口的东西。
例如,需要一个自定义的队列抽象数据类型,提供以下功能。
- 排列元素
- 去排队的元素
- 返回队列的长度
- 支持成员资格测试
- 支持正常和反向迭代
- 提供一个方便用户的字符串表示法
此时可以写一个Queue类。
# custom_queue.py

from collections import deque

class Queue:
def __init__(self):
self._items = deque()

def enqueue(self, item):
self._items.append(item)

def dequeue(self):
try:
return self._items.popleft()
except IndexError:
raise IndexError("dequeue from an empty queue") from None

def __len__(self):
return len(self._items)

def __contains__(self, item):
return item in self._items

def __iter__(self):
yield from self._items

def __reversed__(self):
yield from reversed(self._items)

def __repr__(self):
return f"Queue({list(self._items)})"
._items 是一个 deque 对象,可以存储和操作队列中的元素。Queue使用 deque.append() 实现了 .enqueue(),将元素添加到队列的末端。还用 deque.popleft() 实现了 .dequeue(),以有效地从队列的开头删除元素。
支持以下特殊方法
Method | Support |
| 长度的 |
| 带有 |
| 常规迭代 |
| 反向迭代 |
| 字符串表示形式 |
理想情况下,.__repr__()返回一个字符串,代表一个有效的 Python 表达式。可以用这个表达式以相同的值重新创建这个对象。
然而,在上面的例子中,目的是使用方法的返回值在 interactive shell 上优雅地显示对象。可以通过接受初始化可迭代对象作为.__init__() 的参数并从中构建实例,从而从这个特定的字符串表示形式构建 Queue 实例。
有了这些补充,Queue 类就完成了。要在我们的代码中使用这个类,我们可以做如下事情。
>>> from custom_queue import Queue
>>> numbers = Queue()
>>> numbers
Queue([])

>>> # Enqueue items
>>> for number in range(1, 5):
... numbers.enqueue(number)
...
>>> numbers
Queue([1, 2, 3, 4])

>>> # Support len()
>>> len(numbers)
4

>>> # Support membership tests
>>> 2 in numbers
True
>>> 10 in numbers
False

>>> # Normal iteration
>>> for number in numbers:
... print(f"Number: {number}")
...
1
2
3
4
总结
队列和堆栈是编程中常用的 抽象数据类型。它们通常需要在底层数据结构的两端进行有效的 pop 和 append 操作。Python 的 collections 模块提供了一种叫做 deque 的数据类型,它是专门为两端的快速和节省内存的追加和弹出操作而设计的。
有了deque,我们可以用优雅、高效和Pythonic的方式在低层次上编写我们自己的队列和堆栈。
总结下本文所学内容:
- 如何在代码中创建和使用Python的deque
- 如何有效地从deque的两端追加和弹出项目
- 如何使用deque来构建高效的队列和堆栈
- 什么时候值得使用deque而不是list
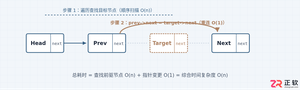
详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。