

使用Python中的复杂数据类型实现数据处理
一、序列:序列是基类类型,序列扩展类型包括:字符串、元组和列表序列都可以进行的操作包括索引,切片,加,乘,检查成员。此外,Python已经内置确定序列的长度以及确定最大和最小的元素的方法。二、列表(list):[a1,a2],可变数据类型列表:列表是序列类型的一种扩展,十分常用1、列表的创建列表是一种序列类型,创建后可以随意被修改使用方括号[]或list()创建,元素间用逗号,分隔列表中各元素类型可以不同,无长度限制hobby_list=[hobby,'run','girl'
一、序列:
序列是基类类型,序列扩展类型包括:字符串、元组和列表
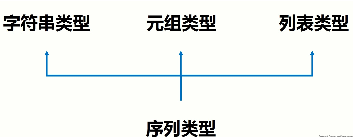
序列都可以进行的操作包括索引,切片,加,乘,检查成员。
此外,Python已经内置确定序列的长度以及确定最大和最小的元素的方法。
二、列表(list):[a1,a2],可变数据类型
列表:列表是序列类型的一种扩展,十分常用
1、列表的创建
列表是一种序列类型,创建后可以随意被修改
使用方括号 [] 或list() 创建,元素间用逗号 , 分隔
列表中各元素类型可以不同,无长度限制
hobby_list = [hobby, 'run', 'girl']

print(id(hobby_list)) # 4558605960
print(type(hobby_list)) #
print(hobby_list) # ['read', 'run', 'girl']
如果想初始化个长度为10的列表
list_empty = [None]*10
print(list_empty)
# [None, None, None, None, None, None, None, None, None, None]
使用range()函数来创建一个列表:
hobby_list = list(range(5))
# [0, 1, 2, 3, 4]
2、复合列表和多维列表
hobby_list = ['read', 'run',['girl_name', 18, 'shanghai'] ]
print(hobby_list[2][1])#  取出girl的年龄 18
python 创建二维列表,将需要的参数写入 cols 和 rows 即可
list_2d = [[0 for i in range(5)] for i in range(5)]
list_2d[0].append(3)
list_2d[0].append(5)
list_2d[2].append(7)
print(list_2d)
# [[0, 0, 0, 0, 0, 3, 5], [0, 0, 0, 0, 0], [0, 0, 0, 0, 0, 7], [0, 0, 0, 0, 0], [0, 0, 0, 0, 0]]
以下实例将3X4的矩阵列表转换为4X3列表:
# 以下实例展示了3X4的矩阵列表:
matrix = [
    [1, 2, 3, 4],
    [5, 6, 7, 8],
    [9, 10, 11, 12],
]

# 以下实例将3X4的矩阵列表转换为4X3列表:
transposed=[[row[i] for row in matrix] for i in range(4)]
print(transposed)
# [[1, 5, 9], [2, 6, 10], [3, 7, 11], [4, 8, 12]]

# 以下实例也可以使用以下方法来实现:
transposed = []
for i in range(4):
    transposed.append([row[i] for row in matrix])
print(transposed)
# [[1, 5, 9], [2, 6, 10], [3, 7, 11], [4, 8, 12]]
3、列表索引取值
索引序号从0开始。
hobby_list = ['read', 'run', 'girl']
# 索引序号      0       1      2

print(hobby_list[1])#  取出第二个爱好 run
4、列表修改
可以对列表的数据项进行修改或更新,你也可以使用append()方法来添加列表项,
hobby_list = ['read', 'run', 'girl']
hobby_list[0] = 'write'
列表方法使得列表可以很方便的作为一个堆栈来使用。堆栈作为特定的数据结构,最先进入的元素最后一个被释放(后进先出)。
用 append() 方法可以把一个元素添加到堆栈顶。用不指定索引的 pop() 方法可以把一个元素从堆栈顶释放出来。
append:在列表ls最后增加一个元素x
pop():移除列表中的一个元素(默认最后一个元素),并且返回该元素的值
例如:
stack = [3, 4, 5]
stack.append(6)
stack.append(7)
print(stack)
# [3, 4, 5, 6, 7]

print(stack.pop())
# 7
print(stack)
# [3, 4, 5, 6]
print(stack.pop())
# 6
print(stack.pop())
# 5

print(stack)
# [3, 4]
三、列表推导式
列表推导式提供了从序列创建列表的简单途径。通常应用程序将一些操作应用于某个序列的每个元素,用其获得的结果作为生成新列表的元素,或者根据确定的判定条件创建子序列。
每个列表推导式都在 for 之后跟一个表达式,然后有零到多个 for 或 if 子句。
返回结果是一个根据表达从其后的 for 和 if 上下文环境中生成出来的列表。如果希望表达式推导出一个元组,就必须使用括号。
1、列表推导式书写形式:
[表达式 for 变量 in 列表]
[表达式 for 变量 in 列表 if 条件]
举例:
print([i for i in range(10)] )  # [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
print([i ** 2 for i in range(10)])  # [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]

print([0 for i in range(5)])  #[0, 0, 0, 0, 0]

name_list = ['nick', 'sean', 'jason', 'tank']
for n in [name if name == 'nick' else name + '_a' for name in name_list] :
    print(n)  # 'nick', 'sean_a', 'jason_a', 'tank_a'

li = [1, 2, 3, 4, 5, 6, 7, 8, 9]
print( [x ** 2 for x in li]) # [1, 4, 9, 16, 25, 36, 49, 64, 81]
print( [x ** 2 for x in li if x > 5]) # [36, 49, 64, 81]
print(dict([(x, x * 10) for x in li])) # {1: 10, 2: 20, 3: 30, 4: 40, 5: 50, 6: 60, 7: 70, 8: 80, 9: 90} #生成字典

vec1 = [2, 4, 6]
vec2 = [4, 3, -9]
sq = [vec2[i] + vec2[i] for i in range(len(vec))]  # 实现列表相加
print(sq)
# [6, 7, -3]

testList = [1, 2, 3, 4]

def mul2(x):
    return x * 2


print([mul2(i) for i in testList]) #使用复杂表达式或嵌套函数:
# [2, 4, 6, 8]
2、列表推导式的嵌套
语句之间是嵌套关系。
左边第二个语句是最外层,依次往右进一层,左边第一条语句是最后一层。
[x*y for x in range(1,5) if x > 2 for y in range(1,4) if y < 3]
他的执行顺序是:
for x in range(1,5)
    if x > 2
        for y in range(1,4)
            if y < 3
                x*y
实例
print( [ (x, y) for x in range(10) if x % 2 if x > 3 for y in range(10) if y > 7 if y != 8]) #生成元组
# [(5, 9), (7, 9), (9, 9)]

print([x * y for x in [1, 2, 3] for y in [1, 2, 3]])
# [1, 2, 3, 2, 4, 6, 3, 6, 9]
四、列表的基本操作
ls1 = ['python', 123]
ls2 = ['java', 456]
print(ls1 * 2);  # ['python', 123, 'python', 123] 将列表复制n次。
print(ls1 + ls2);  # ['python', 123, 'java', 456] 连接两个列表

name_list = ['nick', 'jason', 'tank', 'sean']
del name_list[2]  # 删除索引2位置后的元素
print(name_list)  # ['nick', 'jason', 'sean']

del name_list[2:4] # 从列表中删除切片 ,删除第i-j位置的元素
print(name_list)  # ['nick', 'jason']

del name_list[:] #清空整个列表
print(name_list)  # []
del a  # 用 del 删除实体变量:


name_list = ['nick', 'jason', 'tank', 'sean']
print('tank sb' in name_list)  #  成员运算:in; False
print('nick handsome' not in name_list)  # 成员运算:in;True


name_list = ['nick', 'jason', 'tank', 'sean']
for name in name_list:  # for循环
    print(name)


a = ['Google', 'Baidu', 'Runoob', 'Taobao', 'QQ']
for i in range(len(a)): # 结合range()和len()函数以遍历一个序列的索引
    print(i, a[i])
# 0 Google 1 Baidu 2 Runoob 3 Taobao 4 QQ


name_list = ['nick', 'jason', 'tank', 'sean']
print(name_list[0:3:2] )  # 切片  ['nick', 'tank']
举例:有如下列表,列表元素为不可hash类型,去重,得到新列表,且新列表一定要保持列表原来的顺序
stu_info_list = [
    {'name': 'nick', 'age': 19, 'sex': 'male'},
    {'name': 'egon', 'age': 18, 'sex': 'male'},
    {'name': 'tank', 'age': 20, 'sex': 'female'},
    {'name': 'tank', 'age': 20, 'sex': 'female'},
    {'name': 'egon', 'age': 18, 'sex': 'male'},
]

new_stu_info_list = []
for stu_info in stu_info_list:
    if stu_info not in new_stu_info_list:
        new_stu_info_list.append(stu_info)

for new_stu_info in new_stu_info_list:
    print(new_stu_info)
五、列表相关函数
name_list = ['nick', 'jason', 'tank', 'sean']
print(len(name_list))  # 4 列表元素个数:len;
print(min(name_list))  # jason 返回序列s的最小元素;
print(max(name_list))  # tank 返回序列s的最大元素

name_list = ['nick', 'jason', 'tank', 'sean']
name_list.insert(1, 'handsome') # insert(i,x):在列表的第i位置增加元素x
print(name_list)  # ['nick', 'handsome', 'jason', 'tank', 'sean']

name_list = ['nick', 'jason', 'tank', 'sean']
print(name_list.remove('nick'))  # remove(x):将列表ls中出现的第一个元素x删除 ,None ;
print(name_list)  # ['jason', 'tank', 'sean']

name_list = ['nick', 'jason', 'tank', 'sean']
print(name_list.count('nick'))  # 1  ;统计某个元素在列表中出现的次数

name_list = ['nick', 'jason', 'tank', 'sean']
print(name_list.index('nick'))  # 0;返回元素所在列表中的索引

name_list = ['nick', 'jason', 'tank', 'sean']
name_list.clear() # 删除列表中所有元素
print(name_list)  # []

name_list = ['nick', 'jason', 'tank', 'sean']
print(name_list.copy())  # 生成一个新列表,赋值原列表中所有元素  ['nick', 'jason', 'tank', 'sean']

name_list = ['nick', 'jason', 'tank', 'sean']
name_list2 = ['nick handsome']
name_list.extend(name_list2) # 在列表末尾一次性追加另一个序列中的多个值(用新列表扩展原来的列表)
print(name_list)  # ['nick', 'jason', 'tank', 'sean', 'nick handsome']

name_list = ['nick', 'jason', 'tank', 'sean']
name_list.reverse() # 将列表ls中的元素反转
print(name_list)  # ['sean', 'tank', 'jason', 'nick']

name_list = ['nick', 'jason', 'tank', 'sean']
name_list.sort() # 排序,使用用sort列表的元素必须是同类型的

print(name_list)  # ['jason', 'nick', 'sean', 'tank']

name_list.sort(reverse=True) # 倒序
print(name_list)  # ['tank', 'sean', 'nick', 'jason']
六、元组(tuple):(a1,a2)
1、元组的创建
元组是一种列表类型,一旦创建就不能被修改。
color = (0x001100, "blue", creature) # 使用小括号 () 或 tuple() 创建,元素间用逗号分隔。
print(type(color))  #

creature = "cat", "dog", "tiger", "human" # 可以使用或不使用小括号。即元组由若干逗号分隔的值组成。
print(type(creature))  #
注意与字符串区别:
name_str = ('egon')  # ()只是普通包含的意思
name_tuple = ('egon',)  # 元组中只包含一个元素时,需要在元素后面添加逗号,否则括号会被当作字符串使用:

print(type(name_str))  #
print(type(name_tuple))  #
2、元组的操作
索引取值、切片(顾头不顾尾,步长)、长度len、成员运算in和not in、循环、count、index等均同列表,只是不更改值。
元组中的元素值是不允许修改的,但我们可以对元组进行连接组合,如下实例:
tup1 = (12, 34.56);
tup2 = ('abc', 'xyz')

# 以下修改元组元素操作是非法的。
# tup1[0] = 100

# 创建一个新的元组
tup3 = tup1 + tup2;
print(tup3)  # (12, 34.56, 'abc', 'xyz')
3、namedtuple(具名元组): Python元组的升级版本
from collections import namedtuple

User = namedtuple('User', 'name sex age') # 定义一个namedtuple类型User,并包含name,sex和age属性。
user = User(name='Runoob', sex='male', age=12) # 创建一个User对象

print(user.age) # 12 
学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



