

Python中如何实现链式调用
为什么是链式调用?链式调用,或者也可以称为方法链(MethodChaining),从字面意思上来说就是将一些列的操作或函数方法像链子一样穿起来的Code方式。我最开始感知链式调用的「美」,还要从使用R语言的管道操作符开始。library(tidyverse)mtcars%>%group_by(cyl)%>%summarise(meanmeanOfdisp=mean(disp))%>%ggplot(aes(x=as.factor(cyl),y=meanOfdisp,fill=as.factor(seq(1,
为什么是链式调用?
链式调用,或者也可以称为方法链(Method Chaining),从字面意思上来说就是将一些列的操作或函数方法像链子一样穿起来的 Code 方式。
我最开始感知链式调用的「美」,还要从使用 R 语言的管道操作符开始。
library(tidyverse) mtcars %>% group_by(cyl) %>% summarise(meanmeanOfdisp = mean(disp)) %>% ggplot(aes(x=as.factor(cyl), y=meanOfdisp, fill=as.factor(seq(1,3))))+ geom_bar(stat = 'identity') + guides(fill=F)
对于 R user 来说,对于这一段代码很快就能明白整个流程步骤是怎样的。这一切都是通过符号%>%(管道操作符)谈起。
通过管道操作符,我们可以将左边事物传递给下一个事物。这里我将mtcars数据集传递到group_by 函数中,然后将得到后的结果再传递到summarize函数,最后传递到ggplot函数中进行可视化绘制。
如果我没有学会链式调用,那么最开始学习 R 语言的我一定是这样写:
library(tidyverse) cyl4 <- mtcars[which(mtcars$cyl==4), ] cyl6 <- mtcars[which(mtcars$cyl==6), ] cyl8 <- mtcars[which(mtcars$cyl==8), ] data <- data.frame( ccyl = c(4, 6, 8), meanOfdisp = c(mean(cyl4$disp), mean(cyl6$disp), mean(cyl8$disp)) ) graph <- ggplot(datadata=data, aes(x=factor(cyl), y=meanOfdisp, fill = as.factor(seq(1,3)))) graph <- graph + geom_bar(stat = 'identity') + guides(fill=F) graph
如果不使用管道操作符,那么我将会进行不必要的赋值,并且覆盖原有的数据对象,但其实当中产生的cyl#、data 其实最后都只是为graph 这一张图片所服务的,因此导致的问题就是代码会变得冗余。
链式调用在极大程度简洁代码的同时,也提高了代码的可读性,能够很快速地了解到每一步都是在做什么。这种方式对于做数据分析或处理数据时是十分有用,减少创建不必要的变量时,能够以快速、简单的方式进行探索。
你能在很多地方见到链式调用或者管道操作的身影,这里我举除了 R 语言以外的两个典型例子。
一个是 Shell 语句:
echo "`seq 1 100`" | grep -e "^[3-4].*" | tr "3" "*"
在 shell 语句中使用「|」管道操作符能够快速地实现链式调用,这里我首先是打印1-100的所有整数,然后将其传入到grep方法中,提取由 3 或 4 开头的所有部分,再将这部分传入到tr 方法中,并对数字包含 3 的部分用星号替换。结果如下:
另外一个是 Scala 语言:
object Test { def main(args: Array[String]): Unit = { val numOfseq = (1 to 100).toList val chain = numOfseq.filter(_%2==0) .map(_*2) .take(10) } }在这段示例中,首先numOfseq 这个变量包含了从 1-100 的所有整数,然后从chain部分开始,我首先在numOfseq的基础上调用了filter 方法,用以筛选这些数字中为偶数的部分,其次在调用map 方法,将这些被筛选出来的数乘以 2,最后使用take 方法从新构成的数字中取出前 10 个数,这些数共同赋值给了chain 变量。
通过以上的叙述,相信你能对链式调用有一个初步的印象,但是一旦你掌握了链式调用,那么除了会让你的代码风格有所改变以外,你的编程思维也会有不一样的提升。
Python 中的链式调用
在 Python 中实现一个简单的链式调用就是通过构建类方法并返回对象自身或返回归属类(@classmethod)
class Chain: def __init__(self, name): self.name = name def introduce(self): print("hello, my name is %s" % self.name) return self def talk(self): print("Can we make a friend?") return self def greet(self): print("Hey! How are you?") return self if __name__ == '__main__': chain = Chain(name = "jobs") chain.introduce() print("-"*20) chain.introduce().talk() print("-"*20) chain.introduce().talk().greet()在这里我们创建一个Chain 类,需要传递一个name 字符串参数进行实例对象的创建;当中这个类里有三个方法,分别是introduce、talk以及greet。
由于每次返回的是self 自身,那么我们就可以源源不断地调用对象归属类中的方法,结果如下:
hello, my name is jobs -------------------- hello, my name is jobs Can we make a friend? -------------------- hello, my name is jobs Can we make a friend? Hey! How are you?
在 Pandas 中使用链式调用
前面铺垫了这么多终于谈到有关于 Pandas 链式调用部分
Pandas 中的大部分方法都很适合使用链式方法进行操作,因为经过 API 处理后返回的往往还是 Series 类型或 DataFrame 类型,所以我们可以直接就调用相应的方法,这里我以我在今年 2 月份左右给别人做案例演示时爬取到的华农兄弟 B 站视频数据为例。可以通过链接进行获取。
数据字段信息如下所示,里面有 300 条数据,并且 20 个字段:
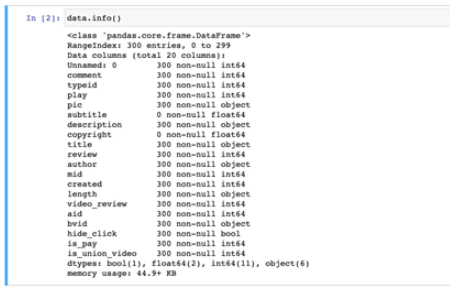
字段信息
但在使用这部分数据之前,我们还需要对这部分数据进行初步的清洗,这里我主要选取了以下字段:
aid:视频对应的 av 号
comment:评论数
play:播放量
title:标题
video_review:弹幕数
created:上传日期
length:视频时长
1、数据清洗
各字段对应的值如下所示:
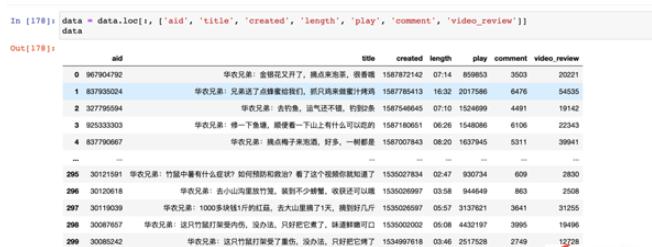
字段值
从数据中我们可以看到:
title 字段前面都会带有「华农兄弟」四个字,如果对标题字数进行统计时需要预先去除;
created 上传日期似乎显示成了一长串的数值,但其实是从 1970 至今的时间戳,我们需要处理成可读懂的年月日形式;
length 播放量长度只显示了分秒,但是小时并未用「00」来进行补全,因此这里我们一方面需要将其补全,另一方面要将其转换成对应的时间格式
链式调用操作如下:
import re import pandas as pd # 定义字数统计函数 def word_count(text): return len(re.findall(r"[\u4e00-\u9fa5]", text)) tidy_data = ( pd.read_csv('~/Desktop/huanong.csv') .loc[:, ['aid', 'title', 'created', 'length', 'play', 'comment', 'video_review']] .assign(title = lambda df: df['title'].str.replace("华农兄弟:", ""), title_count = lambda df: df['title'].apply(word_count), created = lambda df: df['created'].pipe(pd.to_datetime, unit='s'), created_date = lambda df: df['created'].dt.date, length = lambda df: "00:" + df['length'], video_length = lambda df: df['length'].pipe(pd.to_timedelta).dt.seconds ) )这里首先是通过loc方法挑出其中的列,然后调用assign方法来创建新的字段,新的字段其字段名如果和原来的字段相一致,那么就会进行覆盖,从assign中我们可以很清楚地看到当中字段的产生过程,同lambda 表达式进行交互:
1.title 和title_count:
原有的title字段因为属于字符串类型,可以直接很方便的调用str.* 方法来进行处理,这里我就直接调用当中的replace方法将「华农兄弟:」字符进行清洗
基于清洗好的title 字段,再对该字段使用apply方法,该方法传递我们前面实现定义好的字数统计的函数,对每一条记录的标题中,对属于\u4e00到\u9fa5这一区间内的所有 Unicode 中文字符进行提取,并进行长度计算
2.created和created_date:
对原有的created 字段调用一个pipe方法,该方法会将created 字段传递进pd.to_datetime 参数中,这里需要将unit时间单位设置成s秒才能显示出正确的时间,否则仍以 Unix 时间错的样式显示
基于处理好的created 字段,我们可以通过其属于datetime64 的性质来获取其对应的时间,这里 Pandas 给我们提供了一个很方便的 API 方法,通过dt.*来拿到当中的属性值
3.length 和video_length:
原有的length 字段我们直接让字符串00:和该字段进行直接拼接,用以做下一步转换
基于完整的length时间字符串,我们再次调用pipe方法将该字段作为参数隐式传递到pd.to_timedelta方法中转化,然后同理和create_date字段一样获取到相应的属性值,这里我取的是秒数。
2、播放量趋势图
基于前面稍作清洗后得到的tidy_data数据,我们可以快速地做一个播放量走势的探索。这里我们需要用到created这个属于datetime64的字段为 X 轴,播放量play 字段为 Y 轴做可视化展示。
# 播放量走势 %matplotlib inline %config InlineBackend.figure_format = 'retina' import matplotlib.pyplot as plt (tidy_data[['created', 'play']] .set_index('created') .resample('1M') .sum() .plot( kind='line', figsize=(16, 8), title='Video Play Prend(2018-2020)', grid=True, legend=False ) ) plt.xlabel("") plt.ylabel('The Number Of Playing')这里我们将上传日期和播放量两个选出来后,需要先将created设定为索引,才能接着使用resample重采样的方法进行聚合操作,这里我们以月为统计颗粒度,对每个月播放量进行加总,之后再调用plot 接口实现可视化。
链式调用的一个小技巧就是,可以利用括号作用域连续的特性使整个链式调用的操作不会报错,当然如果不喜欢这种方式也可以手动在每条操作后面追加一个\符号,所以上面的整个操作就会变成这样:
tidy_data[['created', 'play']] \ .set_index('created') \ .resample('1M') .sum() .plot( \ kind='line', \ figsize=(16, 8), \ title='Video Play Prend(2018-2020)', \ grid=True, \ legend=False \ )但是相比于追加一对括号来说,这种尾部追加\符号的方式并不推荐,也不优雅。
但是如果既没有在括号作用域或未追加\ 符号,那么在运行时 Python 解释器就会报错。
3、链式调用性能
通过前两个案例我们可以看出链式调用可以说是比较优雅且快速地能实现一套数据操作的流程,但是链式调用也会因为不同的写法而存在性能上的差异。
这里我们继续基于前面的tidy_data操作,这里我们基于created_date 来对play、comment和video_review进行求和后的数值进一步以 10 为底作对数化。最后需要得到以下结果:
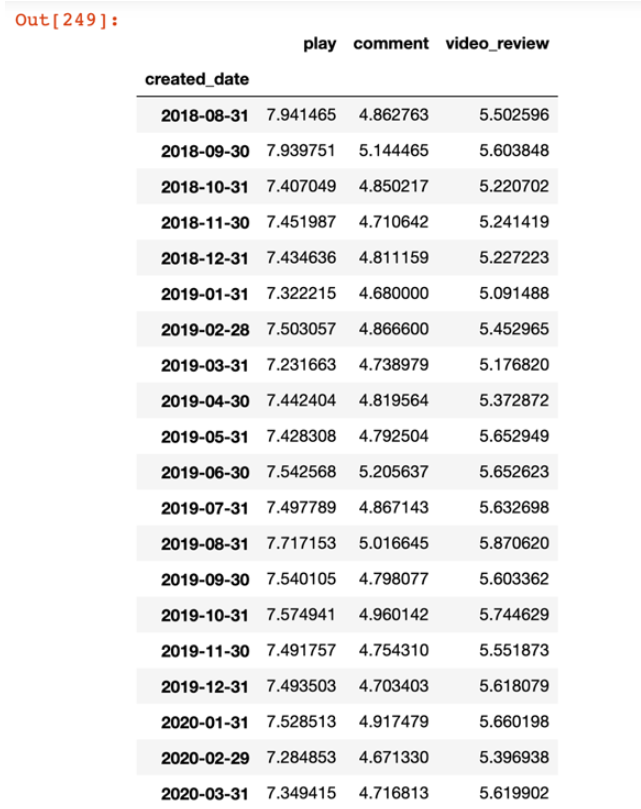
统计表格
写法一:一般写法
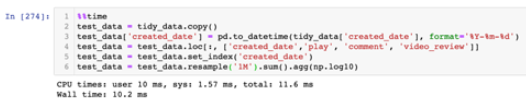
一般写法
这种写法就是基于tidy_data拷贝后进行操作,操作得到的结果会不断地覆盖原有的数据对象
写法二:链式调用写法
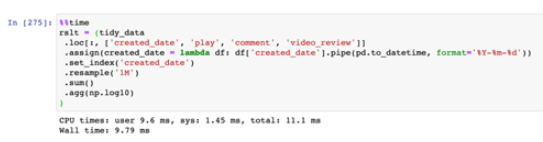
链式调用写法
可以看到,链式调用的写法相比于一般写法而言会快上一点,不过由于数据量比较小,因此二者时间的差异并不大;但链式调用由于不需要额外的中间变量已经覆盖写入步骤,在内存开销上会少一些。
结尾:链式调用的优劣
从本文的只言片语中,你能领略到链式调用使得代码在可读性上大大的增强,同时以尽肯能少的代码量去实现更多操作。
当然,链式调用并不算是完美的,它也存在着一定缺陷。比如说当链式调用的方法超过 10 步以上时,那么出错的几率就会大幅度提高,从而造成调试或 Debug 的困难。比如这样:
(data .method1(...) .method2(...) .method3(...) .method4(...) .method5(...) .method6(...) .method7(...) # Something Error .method8(...) .method9(...) .method10(...) .method11(...) )

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



