

Python Django模型的创建和操作方法是什么?
模型的建立我们要建立一个博客系统,首先先在manage.py所在目录下,用命令pythonmanage.pystartappblog新建一个blog应用,然后在./blog/models.py中写一个类,命名为BlogArticles。通过这个类我们可以创建一个专门用来保存博客文章的数据库表,代码如下:fromdjango.dbimportmodelsfromdjango.utilsimporttimezone#新增fromdjango.contrib.auth.modelsimportUser#新增#C
模型的建立
我们要建立一个博客系统,首先先在 manage.py 所在目录下,用命令 python manage.py startapp blog 新建一个 blog 应用,然后在 ./blog/models.py 中写一个类,命名为 BlogArticles。
通过这个类我们可以创建一个专门用来保存博客文章的数据库表,代码如下:
from django.db import modelsfrom django.utils import timezone   # 新增from django.contrib.auth.models import User    # 新增# Create your models here.# 编写博客的数据类型类BlogArticlesclass BlogArticles(models.Model):    # 字段title的属性为CharField()类型,并且以参数max_length=300说明字段的最大数量
    title = models.CharField(max_length=300)    # 一个用户对应多篇文章,级联删除
    author = models.ForeignKey(User, on_delete=models.CASCADE, related_name="blog_posts")
    body = models.TextField()
    publish = models.DateTimeField(default=timezone.now)    class Meta:
        ordering = ("-publish", )   # 规定了BlogArticles实例对象的显示顺序,即按照publish字段值的倒序显示

    def __str__(self):        return self.title
timezone 模块,我们未来记录文章发布时间,所以导入了这个模块。但因为 Django 默认开启时区且为 UTC,所以需要在 settings 中进行如下设置:
TIME_ZONE = 'Asia/Shanghai' # 设置东八区时间# TIME_ZONE = 'UTC'USE_TZ = False
User模型被命名为内置应用叫 auth,它以命名空间django.contrib.auth的形式出现在INSTALL_APPS配置中ForeignKey()反映出一个用户可以发表多篇文章,其中参数on_delete=models.CASCADE是数据库中的“级联删除”,如果“用户表”中的某个用户被删除,那么“文章表”中该用户对应的文章记录也将被删除。另一个参数
related_name="blog_posts"的作用是允许 User 的实例(某个用户名)以 “blog_posts” 属性反向查询到类 BlogArticles 的实例。我们还定义了 Meta 子类,使用了
ordering = ("-publish", )规定文章的显示顺序__str__方法是对象的字符串表示形式。我们可以使用版块的名称来表示它。
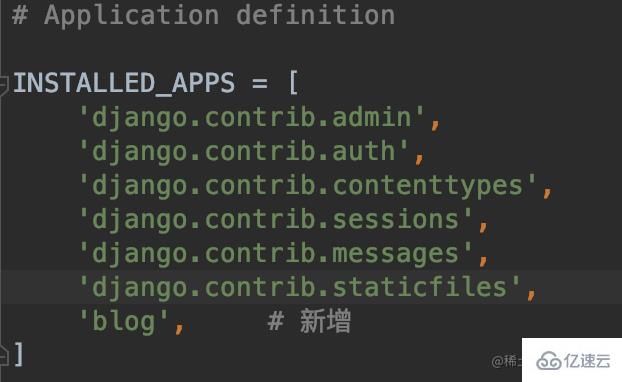
以上步骤我们还是仅仅在我们创建 blog 应用中写了一个博客文章模型,如果想要让应用生效,我们还需要将应用配置到我们的 settings 当中去,在 settings.py 文件的 INSTALLED_APPS 列表中添加 blog 应用,如下所示:
BlogArticles 类的数据模型编写完毕,我们得数据库表就是通过这个类中各字段和属性创建完成。
数据迁移
下一步就是告诉 Django,我的模型类创建好了,该到你创建数据库了,我们打开终端,转到 manage.py 文件所在的文件夹,然后运行一下命令:
python manage.py makemigrations
然后你将看到如下输出内容:
Migrations for 'blog':
  blog/migrations/0001_initial.py
    - Create model BlogArticles
此时,Django 在 /blog/migrations 目录中创建了一个名为 0001_initial.py 的文件。它代表了应用程序模型的当前状态,在下一步,将使用该文件创建表和列。
迁移文件将被翻译成 SQL 语句。执行下面命令:
python manage.py sqlmigrate blog 0001
然后可以看到如下输出内容:
BEGIN;
--
-- Create model BlogArticles
--
CREATE TABLE "blog_blogarticles" ("id" integer NOT NULL PRIMARY KEY AUTOINCREMENT, "title" varchar(300) NOT NULL, "body" text NOT NULL, "publish" datetime NOT NULL, "author_id" integer NOT NULL REFERENCES "auth_user" ("id") DEFERRABLE INITIALLY DEFERRED);
CREATE INDEX "blog_blogarticles_author_id_ed798e23" ON "blog_blogarticles" ("author_id");
COMMIT;
最后我们将生产的迁移文件应用到数据库中:
python manage.py migrate
当看到
Operations to perform:
  Apply all migrations: admin, auth, blog, contenttypes, sessions
Running migrations:
...
Applying sessions.001_initial... OK
Applying sessions.001_initial... OK,这是我们在上一步生产的迁移脚本。意味着,我们的数据库已经可以开始使用了。
Django 自带一个数据库 SQLite,需要注意的是 SQLite 是一个产品级数据库。SQLite 被许多公司用于成千上万的产品,如所有 Android 和 iOS 设备,主流的 Web 浏览器,Windows 10,MacOS 等。 但这不适合所有情况。SQLite 不能与 MySQL,PostgreSQL 或 Oracle 等数据库进行比较。大容量的网站,密集型写入的应用程序,大的数据集,高并发性的应用使用 SQLite 最终都会导致问题。
SQLite 很轻量级,但是并不影响我们用来学习,接下来我们将利用命令行工具来对模型进行操作,也就是我们学习过数据库的基本操作——增、删、改、查。
模型操作
上面的内容中建立了一个博客文章的模型,然后通过数据迁移建立我们对应中的数据库表,加下来基于上述模型进行一些增删改成的操作,这小部分内容可能需要大家对数据库操作有一点熟悉。相信大家都是抱着学习 Django 的目的来看这一套入门笔记,我就不敢再各位数据库大佬们面前班门弄斧了,直接进入本章学习了。
SQLite 的启动
对数据库的操作可以利用 GUI 工具,也可以通过命令行 sqlite3 db.sqlite3,我们在 db.sqlite3 所在的目录下使用上述命令,就可以进入到 db.sqlite3 数据库,如果本地开发中没有配置 SQLite 环境,可以自行搜索如何配置。
如果我们输入命令,看到如下信息,说明进入成功:
 ~/DjangoProject/myblog $ sqlite3 db.sqlite3
SQLite version 3.29.0 2019-07-10 17:32:03
Enter ".help" for usage hints.
sqlite>
然后我们使用 .tables 即可查看当前数据库中的数据库表的名称,除了 blog_blogarticles 是我们通过 BlogArticles 模型建立的,其余的都是项目默认创建的数据库表。
 ~/DjangoProject/myblog $ sqlite3 db.sqlite3
SQLite version 3.29.0 2019-07-10 17:32:03
Enter ".help" for usage hints.
sqlite> .tables
auth_group                  blog_blogarticles
auth_group_permissions      django_admin_log
auth_permission             django_content_type
auth_user                   django_migrations
auth_user_groups            django_session
auth_user_user_permissions
sqlite>
接下来使用 pragma table_info(blog_blogarticles); 命令来查看 blog_blogarticles 表的结构:
sqlite> .header on
sqlite> pragma table_info(blog_blogarticles);
cid|name     |type        |notnull|dflt_value|pk
  0|  id     |integer     |1      |          |1
  1|title    |varchar(300)|1      |          |0
  2|body     |text        |1      |          |0
  3|publish  |datetime    |1      |          |0
  4|author_id|integer     |1      |          |0
sqlite>
.header on 开启头部显示
SQLite 的
PRAGMA命令是一个特殊的命令,可以用在 SQLite 环境内控制各种环境变量和状态标志。一个 PRAGMA 值可以被读取,也可以根据需求进行设置。
我们可以大致查看上面的表结构,cid 是指列 id,name 是指列名,type 是指列类型,notnull 非空,值为 1 表示 True,dflt_value 是指 default 默认值(这一列没有值,说明设置设置默认值),pk 是指 primary_key 主键。
大家可以跟我们在前一章中的数据模型 BlogArticles 所规定的字段和属性进行对比,是不是刚好我们利用数据迁移成功将数据模型转化为数据库表。
创建超级管理员
我们可以在命令行中输入 python manage.py createsuperuser 创建一个 Django 超级管理员,输入用户名和密码,当提示 Superuser created successfully,创建成功。如下:
 ~/DjangoProject/myblog $ python manage.py createsuperuser
Username (leave blank to use 'yuzhou_1su'): zoeu
Email address: test@test.com
Password:
Password (again):
Superuser created successfully.
然后我在浏览器输入 http://127.0.0.1:8000/admin/ ,就可以打开如下界面:
输入刚才创建的超级管理员的用户名和密码就可以进入系统,如图:
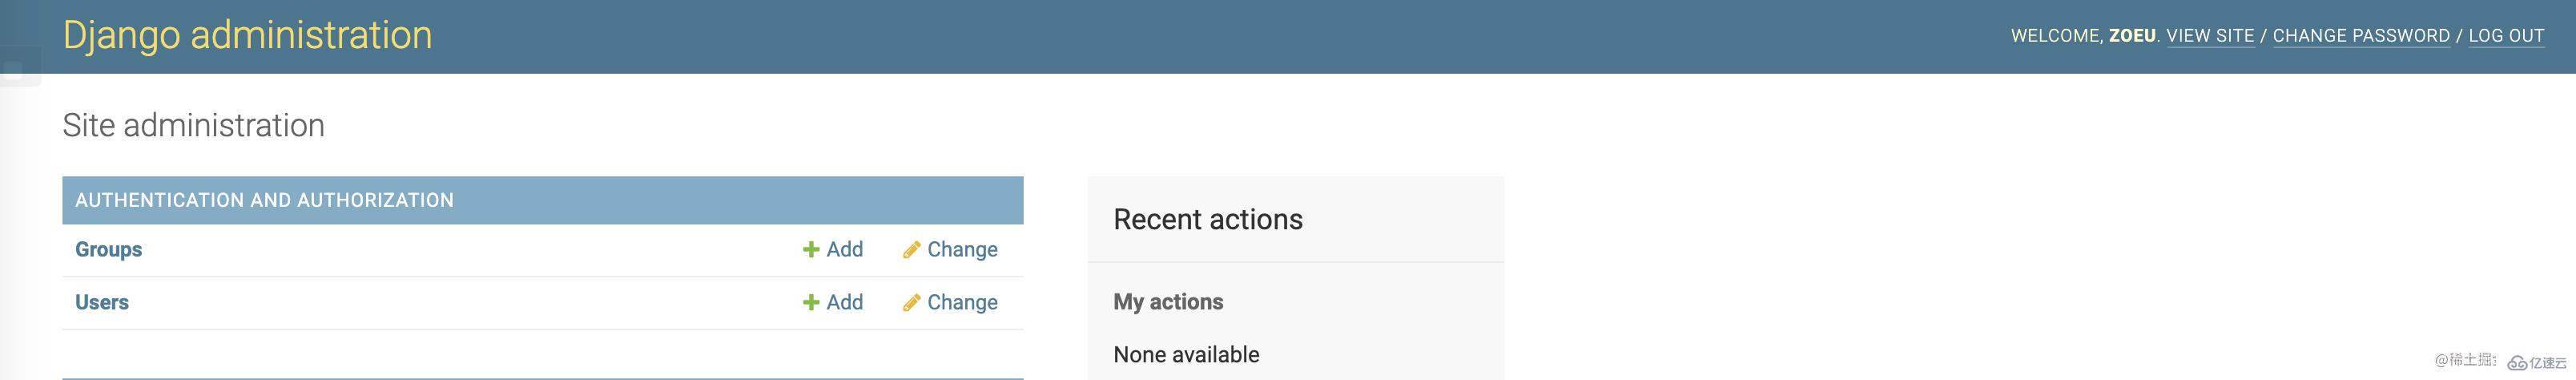
Groups 和 Users 是 Django 在用户管理应用中默认的用户分类。为了让我们得管理员用户能够发布博客,我们需要在 ./blog/admin.py 文件中,加入如下代码:
from django.contrib import admin# 新增,将BlogArticles类引入到当前环境中from .models import BlogArticles

# 将BlogArticles注册到admin中admin.site.register(BlogArticles)
刷新页面,我们可以得到如下的页面:
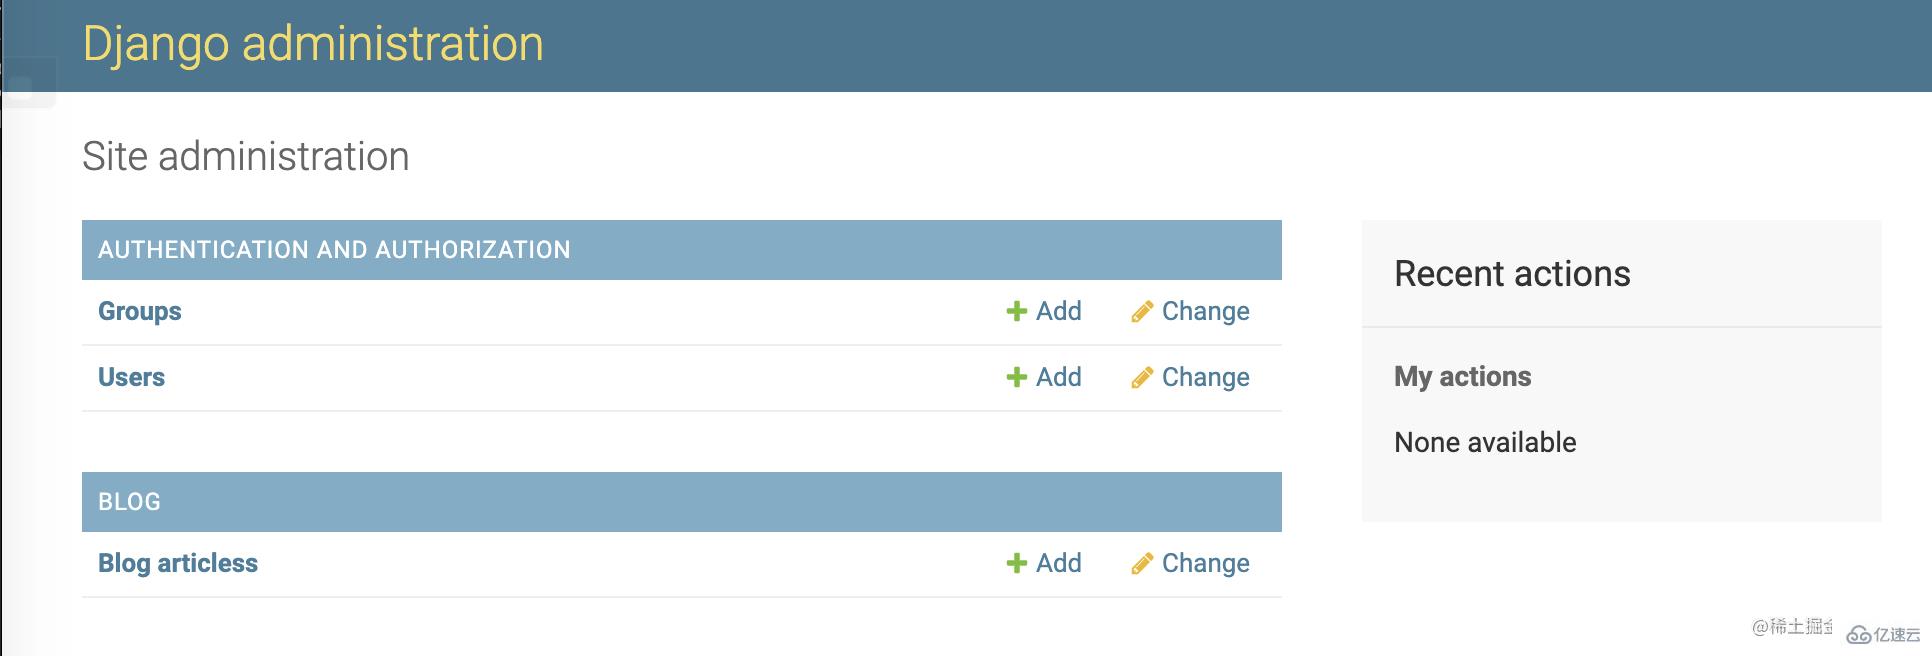
超级管理员界面先放在这,我们回到模型操作。
模型 API 测试
使用 Python 进行开发的一个重要优点是交互式 shell。我们在 ./blog/models.py 中创建了数据模型后,Django 就会自动提供数据库抽象的 API,这是一种快速尝试和试验 API 的方法。通过这个 API 我们可以快速创建、获取、修改和删除对象,对此我们称之为 ORM(Object-Relational Mapper)
我们可以使用 manage.py 工具加载我们的项目来启动 Python shell :
python3 manage.py shell
Python 3.7.3 (v3.7.3:ef4ec6ed12, Mar 25 2019, 16:52:21)
[Clang 6.0 (clang-600.0.57)] on darwin
Type "help", "copyright", "credits" or "license" for more information.
(InteractiveConsole)
>>>
请特别注意我们进入 shell 的方式,不是直接在命令行中敲 python3,虽然这与直接输入 python 指令来调用交互式控制台是非常相似。
区别是我们利用 manage.py 工具,将项目将被添加到 sys.path 并加载 Django。这意味着我们可以在项目中导入我们的模型和其他资源并使用它。
让我们从导入 BlogArticles 类开始:下面就可以开始我们对数据库的增、删、改、查等操作。
$ python3 manage.py shell
Python 3.7.3 (v3.7.3:ef4ec6ed12, Mar 25 2019, 16:52:21)
[Clang 6.0 (clang-600.0.57)] on darwinType "help", "copyright", "credits" or "license" for more information.
(InteractiveConsole)>>> from django.contrib.auth.models import User>>> from blog.models import BlogArticles>>> admin = User.objects.get(username="zoue")>>> admin.username'zoeu'>>> admin.id1>>> admin.password'pbkdf2_sha256$150000$b9j0ZKBVZSo1$l+fEIiKIaS6u1mhjMPOX1qR0xMOaemnRJIwiE2lNn60='>>> admin.email'test@test.com'>>> type(admin)
接下来,要创建新的 BlogArticle 对象,我们可以执行以下操作:
增
>>> BlogAriticle01 = BlogArticles(title ='DjangoNotes_Day01', author=zoue, body='Django是啥?');
为了将这个对象保存在数据库中,我们必须调用 save 方法:
>>> BlogAriticle01.save()
save方法用于创建和更新对象。这里Django创建了一个新对象,因为这时 BlogAriticle01 实例没有 id。第一次保存后,Django 会自动设置 ID :
>>> BlogAriticle01.id4
因为我自己在之前创建过其它文章,所以这个 id 值为 4,如果你是按照本入门笔记一步步操作过来,id 值应该为 1。
当然,还可以查看其它属性,这里统一将命令敲出来:
>>> BlogAriticle01.title'DjangoNotes_Day01'>>> BlogAriticle01.author
>>> BlogAriticle01.body'Django是啥?'>>> BlogAriticle01.publish
datetime.datetime(2019, 9, 30, 19, 56, 58, 735676)>>>
每个 Django 模型都带有一个特殊的属性; 我们称之为模型管理器(Model Manager)。你可以通过属性 objects 来访问这个管理器,它主要用于数据库操作。例如,我们可以使用它来直接创建一个新的 Board 对象:
>>> BlogArticle02 = BlogArticles.objects.create(title='Python', author=admin, body='Head First to Python.')>>> BlogArticle02.id5
改
要更新一个值,我们可以利用如下操作:
>>> BlogAriticle01.body = 'I love Django, 但是我太难了'>>> BlogAriticle01.body'I love Django, 但是我太难了'
查
>>> blogs = BlogArticles.objects.all()>>> blogs
, , , , ]>
结果是一个 QuerySet,我们可以将这个 QuerySet 看作一个列表。假设我们想遍历它并打印每个模块的标题。
>>> for blog in blogs:... print(blog.title)... Python
DjangoNotes_Day01
right here waiting
Yesterday once more
You Raise me up>>>
同样,我们可以使用模型的 管理器(Manager) 来查询数据库并返回单个对象。为此,我们要使用 get 方法:
>>> BlogArticles.objects.get(id=5)
删
>>> BlogArticles.objects.get(id=5).delete()
(1, {'blog.BlogArticles': 1})删除后再重新查看一下 QuerySet,发现没有了,说明删除成功。
>>> blogs = BlogArticles.objects.all()>>> blogs
, , , ]>
除了 get 方法,其实也可以用 filter 进行筛选查询 id=5 然后删除,BlogArticles.objects.filter(id=5).delete()。

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



