

如何使用Xtrabackup进行MySQL的增量备份。
利用Xtrabackup进行mysql增量备份现在xtrabackup版本升级到了8.0,但是只对mysql8.0才有支持,我们这还是使用2.4,但是2.4相比之前的2.1有了比较大的变化:innobackupex功能全部集成到xtrabackup里面,只有一个binary,另外为了使用上的兼容考虑,innobackupex作为xtrabackup的一个软链,即xtrabackup现在支持非Innodb表备份,并且Innobackupex在下一版本中移除(8.0已经移除了),建议通过xtrabackup替
利用Xtrabackup进行mysql增量备份
现在xtrabackup版本升级到了8.0,但是只对mysql8.0才有支持, 我们这还是使用2.4, 但是2.4相比之前的2.1有了比较大的变化:innobackupex 功能全部集成到 xtrabackup 里面,只有一个 binary,另外为了使用上的兼容考虑,innobackupex 作为 xtrabackup 的一个软链,即 xtrabackup 现在支持非Innodb表备份,并且 Innobackupex 在下一版本中移除(8.0已经移除了),建议通过xtrabackup替换innobackupex。还有其他的一些新特性,更多的说明可以看xtrabackup新版详细说明。
安装
如果安装需要依赖就把依赖安装一下
wget https://repo.percona.com/apt/percona-release_latest.$(lsb_release -sc)_all.deb
sudo dpkg -i percona-release_latest.$(lsb_release -sc)_all.deb
sudo apt-get update
sudo apt-get install percona-xtrabackup-24
设置数据库用于备份账户
mysql> CREATE USER 'bkpuser'@'localhost' IDENTIFIED BY '123456';
mysql> GRANT RELOAD, LOCK TABLES, PROCESS, REPLICATION CLIENT ON *.* TO 'bkpuser'@'localhost';
mysql> FLUSH PRIVILEGES;
全量备份
xtrabackup --user=bkpuser --password=123456 --backup --target-dir=/data/backups/mysql
# 会看到输出
200603 09:55:37 Executing UNLOCK TABLES
200603 09:55:37 All tables unlocked
200603 09:55:37 [00] Copying ib_buffer_pool to /data/backups/mysql/ib_buffer_pool
200603 09:55:37 [00]        ...done
200603 09:55:37 Backup created in directory '/data/backups/mysql/'
200603 09:55:37 [00] Writing /data/backups/mysql/backup-my.cnf
200603 09:55:37 [00]        ...done
200603 09:55:37 [00] Writing /data/backups/mysql/xtrabackup_info
200603 09:55:37 [00]        ...done
xtrabackup: Transaction log of lsn (837940114) to (837940123) was copied.
200603 09:55:37 completed OK!
准备备份
xtrabackup --prepare --target-dir=/data/backups/mysql
复制备份
我这里为了演示全量备份就直接将我博客 mysql 存储的数据目录给移动一下
mv /var/lib/mysql /var/lib/mysql_bak
mkdir /var/lib/mysql
xtrabackup --copy-back --target-dir=/data/backups/mysql  # 这样会保留原始备份 他会将当时读到my.cnf的datadir设置为恢复路径
200603 10:47:42 [01]        ...done
200603 10:47:42 [01] Copying ./performance_schema/mutex_instances.frm to /var/lib/mysql/performance_schema/mutex_instances.frm
200603 10:47:42 [01]        ...done
200603 10:47:42 [01] Copying ./performance_schema/events_transactions_history_long.frm to /var/lib/mysql/performance_schema/events_transactions_history_long.frm
200603 10:47:42 [01]        ...done
200603 10:47:42 [01] Copying ./xtrabackup_info to /var/lib/mysql/xtrabackup_info
200603 10:47:42 [01]        ...done
200603 10:47:42 [01] Copying ./ibtmp1 to /var/lib/mysql/ibtmp1
200603 10:47:42 [01]        ...done
200603 10:47:42 completed OK!
备份成功 重新启动 博客还能正常访问 哈哈哈哈
# 将恢复目录的属主更改一下
chown -R mysql:mysql mysql
/etc/init.d/mysql start
如果恢复玩不想要备份数据可以使用 xtrabackup --move-back 命令
增量备份
增量是基于已有数据进行备份的,也就行需要先创建一次全量备份,然后记录当时的记录点
创建备份
xtrabackup --user=bkpuser --password=123456 --backup --target-dir=/data/backups/base
# 基于全量备份进行增量
xtrabackup --user=bkpuser --password=123456 --backup --target-dir=/data/backups/inc1 --incremental-basedir=/data/backups/base
查看备份类型 确认是增量备份了
root@longing:/data/backups/inc1# cat xtrabackup_checkpoints
backup_type = incremental
from_lsn = 837943393
to_lsn = 837943393
last_lsn = 837943402
compact = 0
recover_binlog_info = 0
flushed_lsn = 837943402
from_lsn 是备份的起始 LSN,对于增量备份,它必须to_lsn与先前 base 备份的相同。
在这种情况下,您可以看到to_lsn (最后一个检查点LSN)和last_lsn(最后一个复制的LSN)之间存在差异,这意味着在备份过程中服务器上有一些流量。
我们可以测试一下 对第一个增加继续创建增量 创建增量之前先创建几条数据
xtrabackup --user=bkpuser --password=123456 --backup --target-dir=/data/backups/inc2 --incremental-basedir=/data/backups/inc1
准备恢复
已经有3个备份了,我们要先对基础数据进行准备,然后对两个增量进行准备
xtrabackup --user=bkpuser --password=123456 --prepare --apply-log-only --target-dir=/data/backups/base
xtrabackup --user=bkpuser --password=123456 --prepare --apply-log-only --target-dir=/data/backups/base --incremental-dir=/data/backups/inc1
xtrabackup --user=bkpuser --password=123456 --prepare --target-dir=/data/backups/base --incremental-dir=/data/backups/inc2
xtrabackup --apply-log-only 合并除最后一个以外的所有增量时应使用, 一旦准备好,增量备份就与完整备份相同,可以用相同的方式还原它们。
恢复
xtrabackup --copy-back --target-dir=/data/backups/base
中间插入的数据就能看见了,真棒!
提问总结
增量备份步骤
创建基础备份
一定条件进行增量备份创建
对所有备份进行准备 所有增量基于基础备份 相当于合并操作
最后和全量备份一样 直接恢复即可
原理
在InnoDB内部会维护一个redo日志文件,我们也可以叫做事务日志文件.事务日志会存储每一个InnoDB表数据的记录修改。当InnoDB启动时,InnoDB会检查数据文件和事务日志,并执行两个步骤:它应用(前滚)已经提交的 事务日志到数据文件,并将修改过但没有提交的数据进行回滚操作。
Xtrabackup 在启动时会记住log sequence number(LSN), 并且复制所有的数据文件。复制过程需要一些时间,所以这期间如果数据文件有改动,那么将会使数据库处于一个不同的时间点。这时,xtrabackup 会运行一个后台进程,用于监视事务日志,并从事务日志复制最新的修改。Xtrabackup 必须持续的做这个操作,是因为事务日志是会轮转重复的写入,并且事务日志可以被重用。所以 xtrabackup 自启动开始,就不停的将事务日志中每个数据文件的修改都记录下来。上面就是 xtrabackup 的备份过程。
为什么最后一次增量备份不用 "--apply-log-only"
最后一次"准备"操作可以不用跳过回滚操作,这样用来恢复的数据文件本地就处理好了,当服务启动后就不会再进入到回滚阶段,如果最后一次使用了这个参数,服务器启动后将进入回滚阶段。所以这个--apply-log-only 只是用来合并增量用的避免下一个增量不可用。 可以参见 参见 man xtrabackup
为什么备份完后要准备备份 "prepare"
一般情况下,在备份完成后,数据尚且不能用于恢复操作,因为备份的数据中可能会包含尚未提交的事务或已经提交但尚未同步至数据文件中的事务。因此,此时数据文件仍处理不一致状态。他作用是通过回滚未提交的事务及同步已经提交的事务至数据文件使数据文件处于一致性状态。
为什么选择这个做备份?
mysqldump备份缺点
效率较低,备份和还原速度慢,份过程中,数据插入和更新操作会被挂起
MySQL备份工具
跨平台性差,备份时间长,冗余备份,浪费存储空间
XtraBackup
备份过程中不锁库表,适合生产环境,由专业组织Percona提供( 改进MySQL分支 )
XtraBackup能对表 库进行备份吗?
当然了,只不过博主太懒了,写起来太麻烦了,不过原理都是差不多,操作也差不多,大家自己搞搞!
xtrabackup --user=bkpuser --password=123456 --backup --databases="u_test" --no-timestamp --target-dir=/data/backups/u
xtrabackup --prepare --target-dir=/data/backups/u
还原
先
prepare,利用--apply-log的作用是通过回滚未提交的事务及同步已经提交的事务至数据文件使数据文件处于一致性状态copy,因为是部分备份,不能直接用--copy-back,只能手动来复制需要的库,也要复制ibdata(数据字典)cp /data/backups/u/ibdata1 /var/lib/mysql/cp -r u/u_test /var/lib/mysql/

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

深入理解SQL PRIMARY KEY与UNIQUE约束的区别。文章从行标识与重复限制的目标出发,详解主键的非空特性、外键引用角色以及多数据库对NULL值的处理差异。结合users表实战示例,指导开发者如何根据字段稳定性与业务语义合理选择约束类型,避免设计误区。

刚开始设计关系型数据库?了解PRIMARY KEY、FOREIGN KEY、UNIQUE、NOT NULL、CHECK、DEFAULT等约束的作用、语法和排错方法。本文以PostgreSQL语法为主,结合用户订单场景,清晰展示如何防止脏数据并处理常见约束冲突。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。

后端开发者在维护数据库时,常需对现有表添加主键、唯一或外键约束。若直接执行ADD CONSTRAINT,往往因存量数据不合规导致报错。本文详解操作前的数据清洗步骤、标准SQL语法及MySQL等特殊写法,帮助你在生产环境安全完成结构变更。

针对 SQL 初学者的分组统计实战指南。深入解析 GROUP BY 分组机制、WHERE 与 HAVING 的执行时机差异,以及 COUNT 函数对 NULL 值的处理逻辑。通过具体代码示例演示如何正确筛选聚合结果,并排查因 JOIN 连接导致的统计数据异常,提升报表准确性。

本文详细对比SQL Server和MySQL中游标的基本用法。从DECLARE声明到FETCH遍历,再到CLOSE关闭与DEALLOCATE/Handler清理,解析两者在语法结构、变量接收及异常处理上的核心差异。通过标准代码示例展示如何安全使用游标,避免资源泄漏,适用于需要进行数据库存储过程开发或跨平台迁移的开发者。
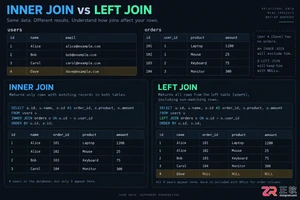
深入解析SQL中INNER JOIN与LEFT JOIN的核心区别。通过users和orders表实例,展示匹配行保留与NULL补位机制,重点讲解ON与WHERE子句中放置右表过滤条件的不同后果,提供防止LEFT JOIN退化的实战技巧及行数异常排查步骤。
深入理解 SQL CHECK 约束在 PostgreSQL、MySQL 等数据库中的实现差异。文章通过订单业务场景,讲解如何定义单列范围与多列逻辑约束,分析 NULL 值对布尔条件的影响,并提供修改已有表结构时的安全操作建议,帮助开发者构建更健壮的数据完整性防线。
后端开发中,如何正确使用 SQL 外键约束来维护订单与明细表的关系?本文通过 PostgreSQL 示例,深入讲解外键的创建语法、插入顺序要求,以及 ON DELETE CASCADE、RESTRICT、SET NULL 等策略的实际影响与风险控制,助你构建健壮的数据库结构。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



