

怎么使用Python写一个简单的JSONParser
JSONTokenizerJSON的词法分析,我主要是参考上面这个截图里面的方式,自己写了一个简单的示例。写得比较简单,应该说它只能支持JSON的一个简单子集。这里TOKEN的种类,参考了https://json.org,不过它的JSON的语法格式是带whitespace的,我不习惯处理这个,所以没有参考它的语法。经过词法分析之后,过滤掉了空格、换行、制表符,我这里就是简单的丢弃不处理。json_tokenizer.py使用正则表达式来进行JSON的词法分析。importjsonimportrefromt
JSON Tokenizer
JSON 的词法分析,我主要是参考上面这个截图里面的方式,自己写了一个简单的示例。写得比较简单,应该说它只能支持 JSON 的一个简单子集。
这里 TOKEN 的种类,参考了 https://json.org,不过它的 JSON 的语法格式是带 whitespace 的,我不习惯处理这个,所以没有参考它的语法。经过词法分析之后,过滤掉了 空格、换行、制表符,我这里就是简单的丢弃不处理。
json_tokenizer.py
使用正则表达式来进行 JSON 的词法分析。
import json
import re

from typing import Dict, List, Union


# TOKEN 的种类
LEFT_BRACE = "LEFT_BRACE"        # {
RIGHT_BRACE = "RIGHT_BRACE"      # }
LEFT_BRACKET = "LEFT_BRACKET"    # ]
RIGHT_BRACKET = "RIGHT_BRACKET"  # [
COLON = "COLON"                  # :
COMMA = "COMMA"                  # ,
NUMBER = "NUMBER"                # ".*?"
STRING = "STRING"                # [1-9]\d*
BOOL = "BOOL"                    # true/false
NULL = "NULL"                    # null
NEWLINE = "NEWLINE"            # \n
SKIP = "SKIP"                    # ' ', '\t'
MISMATCH = "MISMATCH"            # mismatch

# 处理 token 的正则
token_specification = [
    ('LEFT_BRACE', r'[{]'),
    ('RIGHT_BRACE', r'[}]'),
    ('LEFT_BRACKET', r'[\[]'),
    ('RIGHT_BRACKET', r'[\]]'),
    ('COLON', r'[:]'),
    ('COMMA', r'[,]'),
    ('NUMBER', r'-?[1-9]+[0-9]*'),
    ('STRING', r'".*?"'),
    ('BOOL', r'(true)|(false)'),
    ('NULL', r'null'),
    ('NEWLINE', r'\n'),
    ('SKIP', r'[ \t]'),
    ('MISMATCH', r'.')
]

tok_regex = '|'.join('(?P<%s>%s)' % pair for pair in token_specification)
print("Debug: ", tok_regex)


def process(kind: str, value: str) -> Dict[str, Union[str, bool, int, None]]:
    """
    处理输入的 kind 和 value,并生成 Dict 对象,简单表示 token 对象
    """
    if kind == STRING:
        # 去掉外层的双引号,暂时没有比较好的方式
        return {"kind": kind, "value": value[1:-1]}
    if kind == NUMBER:
        return {"kind": kind, "value": int(value)}
    if kind == BOOL:
        if value == "true":
            return {"kind": kind, "value": True}
        else:
            return {"kind": kind, "value": False}
    if kind == NULL:
        return {"kind": kind, "value": None}
    return {"kind": kind, "value": value}


def tokenizer(json_str: str) -> List[Dict[str, Union[str, bool, int, None]]]:
    """
    tokenizer
    """
    tokens = []
    for m in re.finditer(tok_regex, json_str):
        # 获取 token 的类型
        kind = m.lastgroup
        # 获取 token 的值
        value = m.group()
        if kind == MISMATCH:
            raise Exception("json format is error")
        if kind == NEWLINE:
            continue
        if kind == SKIP:
            continue
        token = process(kind=kind, value=value)
        tokens.append(token)

    return tokens


if __name__ == "__main__":
    json_doc = open("./demo.json", "r", encoding="utf-8").read()
    tokens = tokenizer(json_doc)
    if tokens:
        json.dump(tokens, open("./json_tokens.json", "w",
                               encoding="utf-8"), ensure_ascii=False)
我这里把输入、输出数据全部放在文档里面了,下面我贴一下我输入数据和部分输出数据。
demo.json
{
    "name": "小黑子",
    "age": 3,
    "gender": false,
    "other_info": {
        "friends": [
            "嘎子",
            "潘叔",
            "狗"
        ],
        "declaration": "练习时长两年半",
        "hobbies": [
            "唱",
            "跳",
            "rap",
            "篮球????"
        ]
    }
}
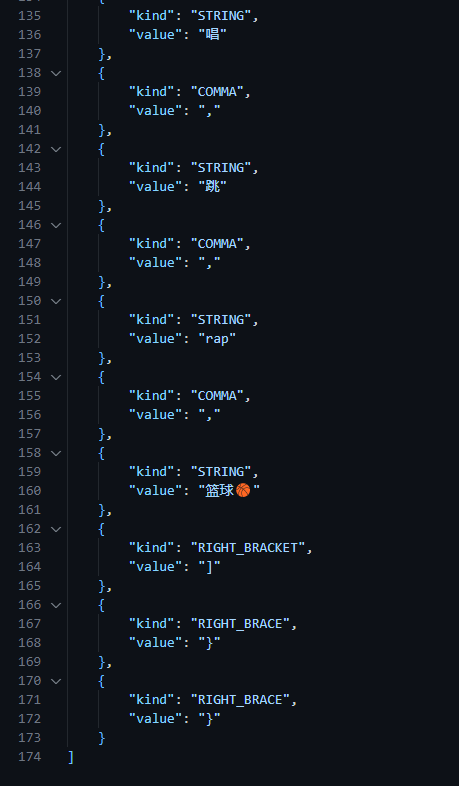
json_token.json 部分数据,数据我格式化了,所以比较长,这里只截取一部分。
JSON Parser
json_parser.py
对上一步生成的 token 序列,进行 parser,生成 JSON 对应的 Dict 对象。parser 的实现参考了 antlr4 的 json 语法文件,它去掉了 whitespace,处理起来更简单一点。
import json
from typing import Dict, Union

# TOKEN 的种类
LEFT_BRACE = "LEFT_BRACE"        # {
RIGHT_BRACE = "RIGHT_BRACE"      # }
LEFT_BRACKET = "LEFT_BRACKET"    # ]
RIGHT_BRACKET = "RIGHT_BRACKET"  # [
COLON = "COLON"                  # :
COMMA = "COMMA"                  # ,
NUMBER = "NUMBER"                # ".*?"
STRING = "STRING"                # [1-9]\d*
BOOL = "BOOL"                    # true/false
NULL = "NULL"                    # null


class Token(object):
    """为了简单,就不创建这个了"""


class JSON_Parser(object):
    """
    JSON_Parser the class aims parse input token sequence into a python object or array.
    """

    def __init__(self, tokens) -> None:
        self.index = 0
        self.tokens = tokens

    def get_token(self) -> Dict[str, Union[str, int, bool, None]]:
        """
        get current's token
        """
        if self.index < len(self.tokens):
            return self.tokens[self.index]
        else:
            raise Exception("index out of range.")

    def move_token(self) -> Dict[str, Union[str, int, bool, None]]:
        """
        move to next token and return it
        """
        if self.index + 1 < len(self.tokens):
            self.index = self.index + 1
            return self.tokens[self.index]
        else:
            raise Exception("index out of range.")

    def parse(self):
        """
        parse whole json
        """
        token = self.get_token()
        if token.get("kind") == LEFT_BRACE:
            return self.parse_obj()
        elif token.get("kind") == LEFT_BRACKET:
            return self.parse_arr()
        else:
            raise Exception("error json, neither object or array.")

    def parse_obj(self):
        """
        parse object
        """
        obj = {}
        token = self.move_token()
        kind = token.get("kind")
        # '{' '}'
        if kind == RIGHT_BRACE:
            return obj
        # '{' pair (',' pair)* '}'
        name, val = self.parse_pair()
        obj[name] = val

        while self.index < len(self.tokens):
            token = self.move_token()
            kind = token.get("kind")
            if kind == COMMA:
                self.move_token()
                name, val = self.parse_pair()
                obj[name] = val
            elif kind == RIGHT_BRACE:
                return obj
            else:
                raise Exception("parse object encounter error")

    def parse_arr(self):
        """
        parse array
        """
        arr = []
        token = self.move_token()
        kind = token.get("kind")
        # '[' ']'
        if kind == RIGHT_BRACE:
            return arr
        # '[' value (',' value)* ']'
        val = self.parse_value()
        arr.append(val)

        while self.index < len(self.tokens):
            token = self.move_token()
            kind = token.get("kind")
            if kind == COMMA:
                self.move_token()
                val = self.parse_value()
                arr.append(val)
            elif kind == RIGHT_BRACKET:
                return arr
            else:
                raise Exception("parse array encounter error")

    def parse_value(self):
        """
        parse value
        """
        token = self.get_token()
        kind = token.get("kind")
        if kind == LEFT_BRACE:
            return self.parse_obj()
        elif kind == LEFT_BRACKET:
            return self.parse_arr()
        elif kind == STRING or kind == NUMBER or kind == BOOL:
            return token.get("value")
        elif kind == NULL:
            return
        else:
            raise Exception("encounter unexcepted token")

    def parse_pair(self):
        """
        parse pair
        """
        token = self.get_token()
        kind = token.get("kind")
        name = token.get("value")
        # STRING ':' value
        if kind == STRING:
            token = self.move_token()
            kind = token.get("kind")
            if kind == COLON:
                token = self.move_token()
                return name, self.parse_value()

        raise Exception("parse pair encounter error")


if __name__ == "__main__":
    # json token 文件路径
    TOKEN_PATH = "./json_tokens.json"
    # 读取 token 序列
    input_tokens = [token for token in json.load(
        open(TOKEN_PATH, "r", encoding="utf-8"))]
    if not input_tokens:
        raise Exception("input token sequence is empty")

    # 调试的时候,用来查表的,很方便定位到 index 走到哪一个 token 了

    for i, tok in enumerate(input_tokens):
        print(f"debug {i:2d} --> {tok}")
    print("\n===========================================\n")
    parser = JSON_Parser(tokens=input_tokens)
    json_obj = parser.parse()
    # 再将 object 转成 json 并格式化后输出
    print(json.dumps(json_obj, ensure_ascii=False, indent=4))
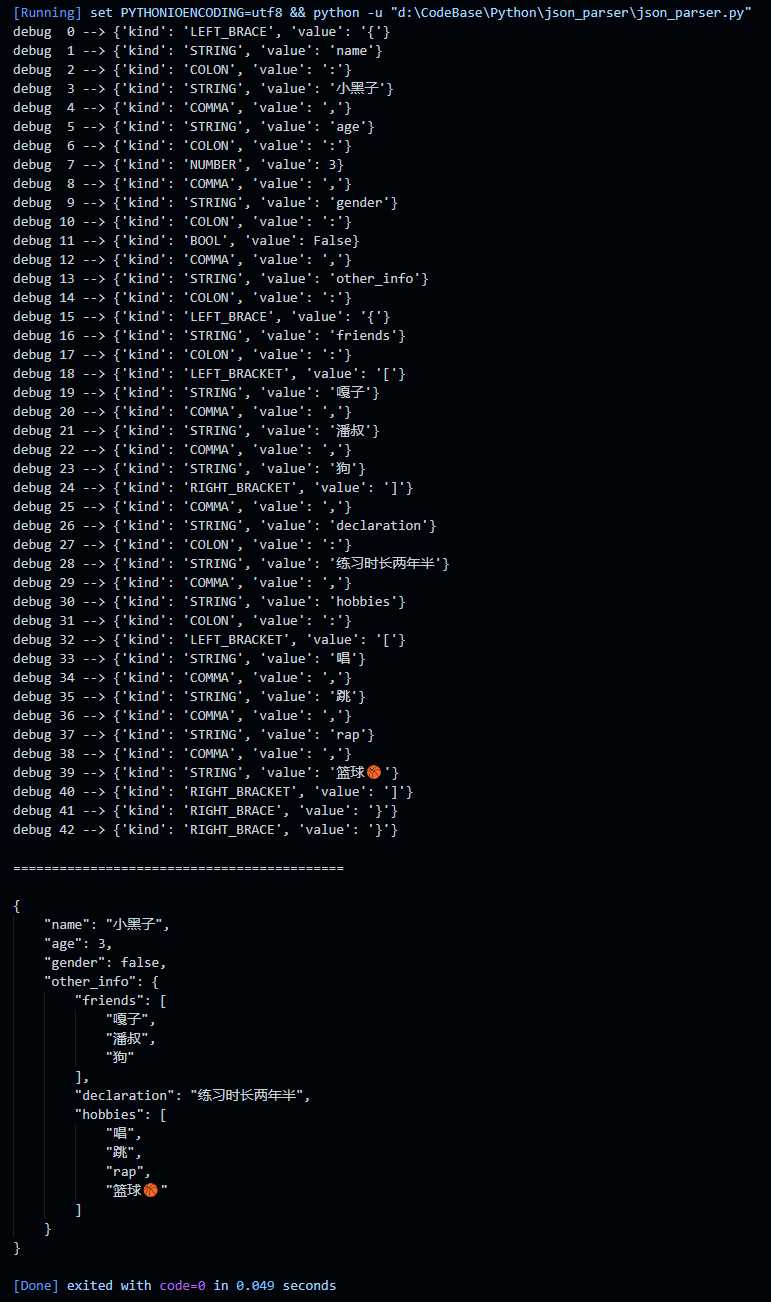
输出结果:

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。

面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



