

用一行代码大幅提升零样本学习方法效果,南京理工&牛津提出即插即用分类器模块
零样本学习(Zero-ShotLearning)聚焦于对训练过程中没有出现过的类别进行分类,基于语义描述的零样本学习通过预先定义的每个类别的高阶语义信息来实现从可见类(seenclass)到未见类(unseenclass)的知识迁移。传统零样本学习在测试阶段仅需要对未见类进行识别,而广义零样本学习(GZSL)需要同时识别可见类和未见类,其评测指标是可见类类平均准确率与未见类类平均准确率的调和平均。一种通用的零样本学习策略是使用可见类样本和语义训练从语义空间到视觉样本空间的条件生成模型,再借助未见类语
零样本学习(Zero-Shot Learning)聚焦于对训练过程中没有出现过的类别进行分类,基于语义描述的零样本学习通过预先定义的每个类别的高阶语义信息来实现从可见类(seen class)到未见类(unseen class)的知识迁移。传统零样本学习在测试阶段仅需要对未见类进行识别,而广义零样本学习(GZSL)需要同时识别可见类和未见类,其评测指标是可见类类平均准确率与未见类类平均准确率的调和平均。
一种通用的零样本学习策略是使用可见类样本和语义训练从语义空间到视觉样本空间的条件生成模型,再借助未见类语义生成未见类的伪样本,最后使用可见类样本和未见类伪样本训练分类网络。然而,要学习两个模态(语义模态与视觉模态)间的良好映射关系通常需要大量样本(参照 CLIP),这在传统零样本学习环境下无法实现。因此,使用未见类语义生成的视觉样本分布通常和真实样本分布存在偏差(bias),这意味着以下两点:1. 这种方法获得的未见类准确率有限。2. 在未见类平均每类生成伪样本数量与可见类平均每类样本数量相当的情况下,未见类准确率与可见类准确率存在较大差值,如下表 1 所示。
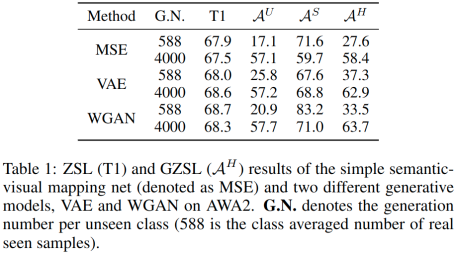
我们发现就算只学习语义到类别中心点的映射,并将未见类语义映射为的单一样本点复制多次再参加分类器训练也能得到接近使用生成模型的效果。这意味着生成模型生成的未见类伪样本特征对分类器来说是较为同质(homogeneity)的。
先前的方法通常通过生成大量未见类伪样本来迎合 GZSL 评测指标(尽管大的采样数量对未见类类间判别没有帮助)。然而这种重采样(re-sampling)的策略在长尾学习(Long-tail Learning)领域被证明会导致分类器在部分特征上过拟合,在这里即是与真实样本偏移的伪未见类特征。这种情况不利于可见类和未见类真实样本的识别。那么,能否舍弃这种重采样策略,转而将生成未见类伪样本的偏移性和同质性(或者可见类与未见类的类别不平衡)作为归纳偏置(inductive bias)植入分类器学习呢?
基于此,我们提出了一个即插即用的分类器模块,只需修改一行代码就能提升生成型零样本学习方法的效果。每个不可见类只需生成 10 个伪样本,就能达到 SOTA 水平。与其他生成型零样本方法相比,新方法在计算复杂度上具有巨大优势。研究成员来自南京理工大学和牛津大学。
- 论文: https://arxiv.org/abs/2204.11822
- 代码: https://github.com/cdb342/IJCAI-2022-ZLA
本文以一致化训练与测试目标为指引,推导出广义零样本学习评测指标的变分下界。以此建模的分类器能够避免使用重采用策略,防止分类器在生成的伪样本上过拟合对真实样本的识别造成不利影响。所提方法能够使基于嵌入的分类器在生成型方法框架上有效,减少了分类器对于生成伪样本质量的依赖。
方法
1. 引入参数化先验
我们决定从分类器的损失函数上着手。假设类别空间已经被生成的未见类伪样本所完善,先前的分类器以最大化全局准确率为优化目标:
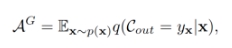

其中 为全局准确率,
 表示分类器输出,
 表示样本分布,
 为样本 X 对应标签。而 GZSL 的评测指标为:
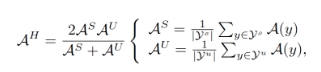

其中 和
 分别代表可见类和未见类集合。训练目标和测试目标的不一致意味着先前的分类器训练策略没有考虑可见类和未见类的差异。自然而然地,我们试图通过对
 进行推导来实现训练与测试目标一致的结果。经过推导,我们得到了其下界:
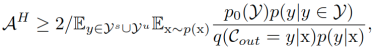
其中 代表可见类 - 未见类先验,其与数据无关,在实验中作为超参数进行调整,
 代表可见类或未见类内部先验,在实现过程中用可见类样本频率或均匀分布代替。通过最大化
 的下界,我们得到了最终的优化目标:
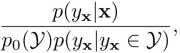
由此,我们的分类建模目标相较先前发生了以下改变:
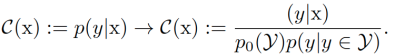
通过使用交叉熵(cross-entropy)拟合后验概率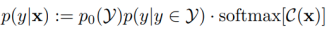 ,我们得到分类器损失为:
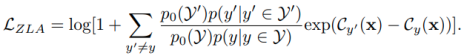
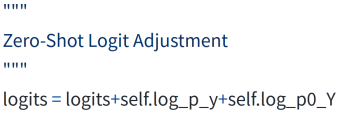
这与长尾学习中的逻辑调整(Logit Adjustment)类似,因此我们称之为零样本逻辑调整(ZLA)。至此,我们实现了通过引入参数化先验将可见类与未见类的类别不平衡作为归纳偏置植入到分类器训练中,并且在代码实现中只需对原始 logits 加上额外偏置项就能达到以上效果。
2. 引入语义先验
到目前为止,零样本迁移的核心,即语义先验(semantic prior)仅在训练生成器与生成伪样本阶段发挥作用,对未见类的识别完全取决于生成的未见类伪样本的质量。显然,如果能够在分类器训练阶段引入语义先验,将会有助于未见类的识别。在零样本学习领域有一类基于嵌入(embedding-based)的方法能够实现这一功能。然而,这一类方法与生成模型学习到的知识是相似的,即语义与视觉间的联系(semantic-visual link),这导致在先前的生成型框架中(参照论文 f-CLSWGAN)直接引入基于嵌入的分类器无法取得比原先更好的效果(除非这种分类器本身就有更好的零样本性能)。通过本文提出的 ZLA 策略,我们能够改变生成的未见类伪样本在分类器训练中扮演的角色。从原先的提供不可见类信息到现在的调整不可见类与可见类间的决策界限(decision boundary),我们得以在分类器训练阶段引入语义先验。具体地,我们采用了原型学习的方法将每个类别的语义映射为视觉原型(即分类器权值),再将调整的后验概率(adjusted posterior)建模为样本与视觉原型间的余弦相似度(cosine similarity),即
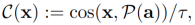
其中 为温度系数。在测试阶段,样本被预测为与其余弦相似度最大的视觉原型对应类别。
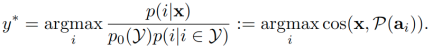
实验
我们将所提出的分类器与基础 WGAN 结合,在每个未见类生成 10 个样本的情况下达到了媲美 SoTAs 的效果。另外我们将其插入到更加先进的 CE-GZSL 方法中,在不改变其他参数(包括生成样本数量)的情况下提升了初始效果。
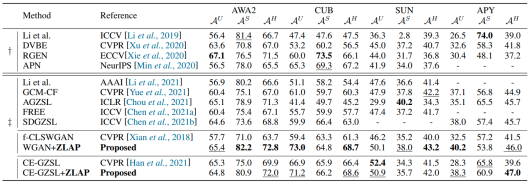
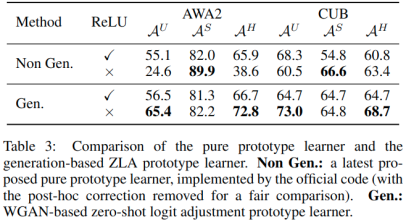
在消融实验中,我们将基于生成的原型学习器(prototype learner)与纯原型学习器进行了比较。我们发现,最后一个 ReLU 层对于纯原型学习器的成功至关重要,因为将负数置零可以增大类别原型与未见类特征的相似度(未见类特征同样经过 ReLU 激活)。然而将部分数值置零也限制了原型的表达,不利于更进一步的识别性能。借助伪未见类样本来弥补未见类信息不仅能在使用 RuLU 时达到更高性能,更能在没有 ReLU 层的情况下实现进一步的性能超越。
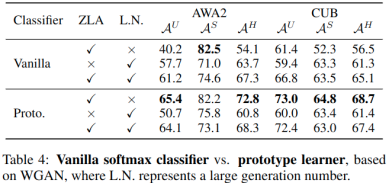
在另一项消融研究中,我们将原型学习器与初始分类器进行比较。结果显示当生成大量未见类样本时,原型学习器与初始分类器相比没有优势。而在使用本文提出的 ZLA 技术时,原型学习器显示出其优越性。正如前文所说,这是因为原型学习器和生成模型都在学习语义 - 视觉联系,所以语义信息很难被充分利用。ZLA 使生成的未见类样本能够调整决策边界,而不是仅仅提供未见类信息,从而对原型学习器起到激活作用。
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能

刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变

机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
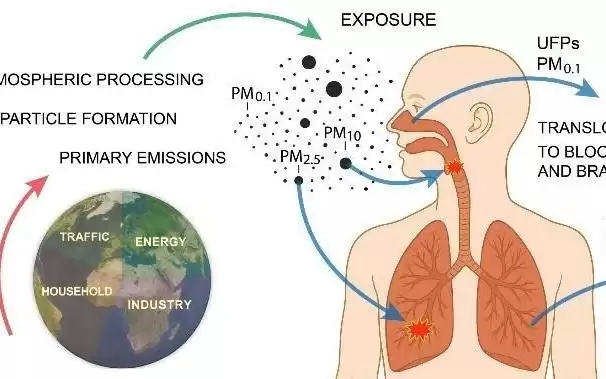
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
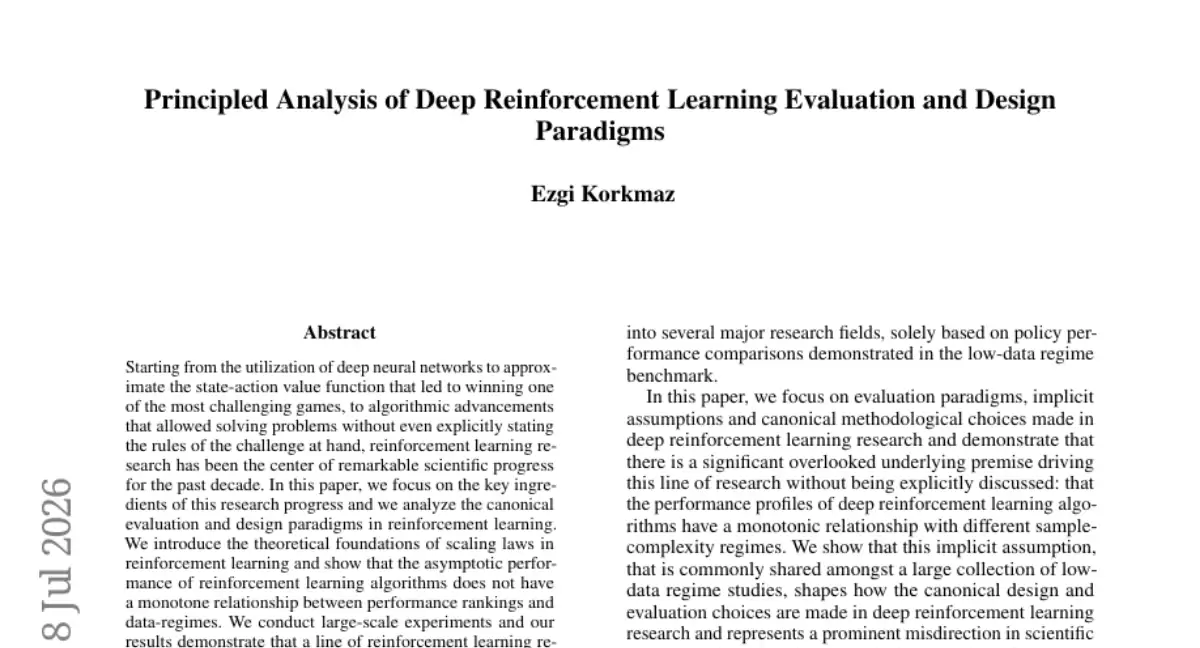
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化

文本 Unicode 码加密与解密:一个简单实用的工具 今天我们来聊聊一种有趣的文本加密方式——Unicode码加密与解密。这个工具利用Unescape脚本的转换机制,能够将普通文本转换成看似乱码的Unicode编码,实现信息的隐藏与保护。 主要用途 这个工具的应用场景其实相当广泛: 加密中文信函,

JScript.Encode脚本在线解密工具,提供完整HTML页面代码,可对编码脚本进行快速解密。页面直接运行,无需额外配置,支持一键解密,操作简便,适用于前端开发者调试与还原加密脚本。

机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
