

用相关性分析消除“冗余特征”
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。 所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。 一个原本 20 列的数据集,经常被我搞到七八十列。 然后我就发现事情不太对劲了: 训练时间明显变
刚开始学机器学习时,我也像大部分人 一样,有个很朴素的想法:特征越多,模型能学到的信息就越多,效果自然越好。
所以每次拿到数据,我就拼命往模型里塞特征——能算出来的统计量全加上,能衍生出来的比率全拼上。
一个原本 20 列的数据集,经常被我搞到七八十列。
然后我就发现事情不太对劲了:
- 训练时间明显变长了,这我能忍
- 但模型在测试集上的表现并没有变好,有时候反而变差了
- 更离谱的是,有些模型输出的特征重要度排名,排在前面的几个特征我一看——它们之间好像说的根本就是同一件事
后来我才知道,这就是所谓的特征冗余问题。
而解决它的一个简单有效的方法,就是相关性分析。
什么是"冗余特征"?
我用一个特别直观的场景来解释。
假设你要判断一个人胖不胖,你收集了这些指标:
| 特征 | 说明 |
|---|---|
| 体重(kg) | 直接称重 |
| 体重(斤) | 就是上面那个乘以 2 |
| BMI | 由体重和身高算出来的 |
| 腰围 | 用尺子量的 |
| 鞋码 | 脚的大小 |
其实一眼就能判断出来,"体重(kg)"和"体重(斤)"说到底只是同一项信息的两种单位表达。要是把这两个字段同时交给模型,它并不会因此获得额外信息,反而更容易被这种重复内容带偏。
真实场景里当然不会这么夸张,但本质是一样的。比如:
- 电商数据里"累计消费金额"和"历史订单总额",往往是高度重合的
- 房产数据里"建筑面积"和"使用面积",趋势几乎一致
- 用户画像里"登录次数"和"活跃天数",很多时候强相关
这些特征单独看都有意义,但放在一起就冗余了。
如何发现"冗余特征"?
答案就是相关性。这也是我们在机器学习训练之前消除**"冗余特征"**的实现原理。
实现的核心思想就是,如果两个特征之间高度相关,它们携带的信息大量重叠,只需保留其中一个。
而保留哪个?取决于是否提供了目标变量 y :
- 有
y:比较两个特征各自与y的相关性,保留与目标更相关的那个 - 无
y:默认保留遍历顺序靠前的特征
根据这个原理,实现的思路也特别直接,就三步:
第一步:构建相关系数矩阵
相关系数大家应该都见过,最常用的是 Pearson 相关系数,取值 -1 到 1:
- 接近 1 → 强正相关,你增我也增
- 接近 -1 → 强负相关,你增我减
- 接近 0 → 没啥线性关系
我们用 pandas 一行就能算出来:
复制代码corr_matrix = df.corr().abs() # 取绝对值,因为我们只关心"强度"
假设我们有 5 个特征,算出来大概是这么一张表:
 复制代码              体重kg   体重斤   BMI    腰围    鞋码
体重kg        1.00    1.00   0.85   0.78   0.30
体重斤        1.00    1.00   0.85   0.78   0.30
BMI           0.85    0.85   1.00   0.72   0.25
腰围          0.78    0.78   0.72   1.00   0.35
鞋码          0.30    0.30   0.25   0.35   1.00
"体重kg"和"体重斤"的相关系数是 1.0——完全冗余,一眼就能看出来。
第二步:设定阈值,筛出冗余对
接下来就是设一个阈值。根据经验:
- 0.95 以上 → 几乎可以肯定是冗余,放心删
- 0.85 ~ 0.95 → 大概率冗余,需要结合业务判断
- 0.85 以下 → 一般可以保留
上面那张表里,如果阈值设 0.95,那"体重kg"和"体重斤"这一对就被揪出来了。
第三步:删谁留谁?这才是关键
找出冗余对之后,问题来了——删哪个?
这里有个很实用的策略:看谁跟目标变量(也就是你要预测的那个东西)更相关,留那个更有用的。
还是上面的例子。假设我们的目标是预测"健康状况评分":
 复制代码与健康评分的相关性:
    体重kg  → 0.45
    体重斤  → 0.45(一样的,因为它就是体重kg × 2)
    BMI     → 0.62
    腰围    → 0.58
如果"体重kg"和"体重斤"必须删一个,删哪个其实无所谓(反正信息完全一样)。
但如果两个特征的相关系数是 0.96 而不是 1.0,它们就不完全相同了,这时候保留与目标变量更相关的那个,就更有意义。
代码实现
理解了原理和思路之后,封装了一个工具类。核心逻辑是这样的:
 复制代码class CorrelationSelector:
    """
    基于相关系数的特征冗余过滤器。
    """    def __init__(self, corr_threshold: float = 0.95, corr_method: str = 'pearson'):
        self.corr_threshold = corr_threshold
        self.corr_method = corr_method
        self.kept_features_ = None
        self.dropped_features_ = None
        self.redundant_pairs_ = None
        self._fitted_flag = False    def fit(self, X, y=None):
        # 构建绝对值相关系数矩阵
        abs_corr = X.corr(method=self.corr_method).abs()        col_names = list(abs_corr.columns)
        num_features = len(col_names)
        pair_records = []
        drop_set = set()        # 只遍历上三角,避免重复比较
        for i in range(num_features):
            for j in range(i + 1, num_features):
                pair_corr = abs_corr.iloc[i, j]                if pair_corr <= self.corr_threshold:
                    continue  # 没超过阈值,跳过                feat_a = col_names[i]
                feat_b = col_names[j]                # 决定保留谁:看谁跟目标变量更相关
                if y is not None:
                    corr_a = abs(X[feat_a].corr(y))
                    corr_b = abs(X[feat_b].corr(y))
                    if corr_a >= corr_b:
                        keep, drop = feat_a, feat_b
                    else:
                        keep, drop = feat_b, feat_a
                else:
                    keep, drop = feat_a, feat_b                pair_records.append({
                    'feature_x': feat_a,
                    'feature_y': feat_b,
                    'corr_value': pair_corr,
                    'kept': keep,
                    'dropped': drop,
                })
                drop_set.add(drop)        self.redundant_pairs_ = pd.DataFrame(pair_records)
        self.dropped_features_ = list(drop_set)
        self.kept_features_ = [f for f in col_names if f not in drop_set]
        self._fitted_flag = True
        return self    def transform(self, X):
        if not self._fitted_flag:
            raise ValueError("请先调用 fit()")
        return X[self.kept_features_]    def fit_transform(self, X, y=None):
        self.fit(X, y)
        return self.transform(X)
用法非常简单,三行搞定:
 复制代码selector = CorrelationSelector(corr_threshold=0.95)
X_clean = selector.fit_transform(X_train, y_train)# 看看哪些特征被干掉了
print(selector.dropped_features_)
完整的代码和使用方式见文末的分享链接。
注意事项
只看了 Pearson,忽略了非线性关系
Pearson 相关系数只能捕捉线性关系。如果两个特征之间是某种曲线关系(比如二次函数),Pearson 可能算出来接近 0,但它们其实是强相关的。
我的做法: 如果对数据分布不太确定,我会换成 spearman 方法,它基于排序,能捕捉单调关系:
复制代码selector = CorrelationSelector(corr_threshold=0.95, corr_method='spearman')
阈值设太低,把有用的特征也删了
比如把阈值设成 0.7,心想"相关性超过 0.7 就算冗余了吧"。
结果一跑,将近一半的特征被删掉了,模型效果直接崩了。
我们需要注意:相关性高不等于冗余,只有"高度到几乎可替代"的程度才算冗余。
0.8 的两个特征,各自还是有独立信息量的。
我现在一般默认用 0.95,最少也不低于 0.85。
贪心删除的"连锁反应"
这个坑比较隐蔽。假设有三个特征 A、B、C:
 复制代码corr(A, B) = 0.97  → 删 B
corr(B, C) = 0.96  → 删 C
corr(A, C) = 0.98  → 应该删 C,但 C 已经被删了
最后只剩下 A。但如果你仔细看,A 和 C 的相关性最高(0.98),也许应该删的是 A 而保留 C。
当特征维度飙升时,这种“贪心策略”引发的连锁反应往往会被放大。但回归到大多数实际业务场景,你大可不必为此过度焦虑,因为这个问题影响不大。毕竟,我们的核心诉求并非穷尽所有可能去锁定那个不存在的“最优子集”,而是果断剔除那些一眼就能看穿的冗余特征,从而让模型结构更加清爽高效。
如果真的很在意,可以用迭代式的方式:每次只删一个特征,然后重新计算相关矩阵,再来一轮。
但这样计算量会大不少,一般没必要。
一张热力图,胜过千言万语
在跑选择器之前,可以先画一张相关系数热力图,对数据有个直观感受:
 复制代码import seaborn as sns
import matplotlib.pyplot as pltcorr = X_train.corr().abs()plt.figure(figsize=(12, 10))
sns.heatmap(corr, annot=True, fmt='.2f', cmap='Reds',
            square=True, linewidths=0.5)
plt.title('特征间相关性热力图')
plt.tight_layout()
plt.show()
颜色越深的格子,就越是"危险区域"——大概率存在冗余。看一眼热力图,你对哪些特征需要处理就心里有数了。
总结
回过头来看,相关性特征选择这个技术真的很朴素,但越朴素的东西越容易被人忽略。
总结起来大概有这几点:
- 特征不在于多,在于精。 10 个精心挑选的特征,往往比 100 个堆砌出来的特征效果更好。
- 冗余特征不是一眼就能看出来的。 数据量一大,人脑根本处理不过来,必须靠工具。
- 阈值别太激进。 0.95 是一个比较稳妥的起点。
- 先看热力图,再跑选择器。 有个全局视角很重要。
- 这个方法不是银弹。 它只是特征选择工具箱里的一个工具,配合其他方法一起用效果最好。
文中封装的 class CorrelationSelector 和测试其使用方式的完整代码分享在网盘中:
url11.ctfile.com/d/45455611-… (访问密码: 6872)
相关文件是:correlation_selector.py 和 test_correlation_selector.py。
我的测试结果如下:
 复制代码样本数: 50, 特征数: 45 (5 真实 + 50 冗余)【全特征】   特征数  45 | RMSE: 7.76 | 耗时: 0.031s
【筛选后】   特征数   5 | RMSE: 3.12 | 耗时: 0.026s
  保留的特征: ['体重_副本4', '身高_副本2', '腰围_副本4', '年龄_副本0', '鞋码_副本0']
  移除的特征数: 40冗余报告(前5条):
  feature_x feature_y  corr_value    kept dropped
0    体重(kg)    体重_副本1    0.988230  体重(kg)  体重_副本1
1        年龄    年龄_副本4    0.986350      年龄  年龄_副本4
2        年龄    年龄_副本5    0.985934  年龄_副本5      年龄
3    腰围(cm)    腰围_副本5    0.984395  腰围(cm)  腰围_副本5
4        鞋码    鞋码_副本4    0.984352      鞋码  鞋码_副本4
消除"冗余特征"之后,RMSE 显著降低。
机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
机器学习实战中,大家往往把精力花在调参和选模型上,却忽略了一个更基础的问题:喂给模型的数据里,有多少特征是真正有用的? 刚开始学机器学习那会儿,很多人特别喜欢堆特征——不管有用没用先一股脑全塞进去,总觉得特征越多模型越聪明。直到有一次跑练习数据集,X_train.shape 直接干到了 (50000
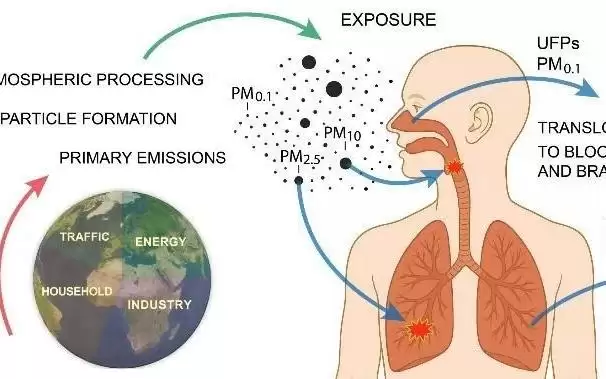
空气中直径小于100纳米的超细颗粒物每年导致约199万人早逝,其中近半因心血管疾病。该颗粒物主要来自化石燃料,可通过呼吸进入血液,引发氧化应激和内皮功能紊乱,是未被充分认识的心血管危险因素。若年均浓度控制在每立方厘米5000个以下,全球超额死亡率可降低约45%。
这项研究来自Ezgi Korkmaz,论文以预印本形式发布于2026年7月8日,编号为arXiv:2607.07769,发表于cs.LG(机器学习)领域,并将出版于2026年人工智能促进协会(AAAI)会议论文集。有兴趣深入了解的读者可以通过arXiv编号2607.07769查询完整论文。 深度强化
机器人编程侧重硬件组装与程序驱动,编程受限于特定机器人;少儿编程系统化教授编程知识,从Scratch启蒙延伸至Python、C++等高级语言。两者各有侧重,选择取决于希望孩子提升的能力方向。
少儿编程分为软件与硬件两大方向。软件编程侧重逻辑与代码能力,含图形化、Python、C++,适配学业竞赛;硬件编程侧重动手与工程实践,含乐高搭建与机器人。选择应基于孩子兴趣与年龄。
PHP-ML是纯PHP编写的机器学习库,需通过Composer安装,依赖PHP7.4以上及ext-gmp等扩展。phpEnv仅提供PHP环境,不直接支持安装。失败原因包括ext-gmp未启用、PATH未关联正确PHP版本、未初始化composer.json。启用gmp扩展、使用phpEnv的PHP执行composerinit和require即可解决。注意CL





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



