

微信基于 PyTorch 的大规模推荐系统训练实践
本文将介绍微信基于PyTorch进行的大规模推荐系统训练。推荐系统和其它一些深度学习领域不同,仍在使用Tensorflow作为训练框架,被广大开发者诟病。虽然也有使用PyTorch进行推荐训练的一些实践,但规模较小,也没有实际的业务验证,很难推动业务尝鲜。2022年2月,PyTorch团队推出了官方推荐库TorchRec。我们团队在5月开始在内部业务上尝试TorchRec,并且与TorchRec团队展开了一系列的合作。在几个月的试用过程中,我们体会到TorchRec非常
本文将介绍微信基于 PyTorch 进行的大规模推荐系统训练。推荐系统和其它一些深度学习领域不同,仍在使用 Tensorflow 作为训练框架,被广大开发者诟病。虽然也有使用 PyTorch 进行推荐训练的一些实践,但规模较小,也没有实际的业务验证,很难推动业务尝鲜。
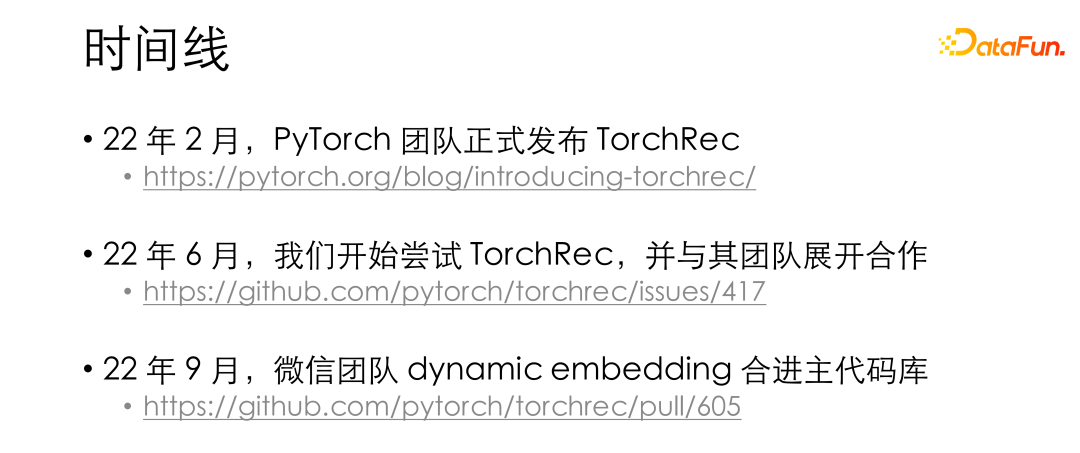
2022 年 2 月,PyTorch 团队推出了官方推荐库 TorchRec。我们团队在 5 月开始在内部业务上尝试 TorchRec,并且与 TorchRec 团队展开了一系列的合作。在几个月的试用过程中,我们体会到 TorchRec 非常多的优点,也感受到 TorchRec 在超大规模模型上仍存在一些不足。针对这些不足,我们设计了扩展功能来填补它的问题。在 2022 年 9 月,我们设计的扩展功能 dynamic embedding 已经正式合进了 TorchRec 的主分支,目前仍在与官方团队持续优化。
一、TorchRec 可以为我们带来什么
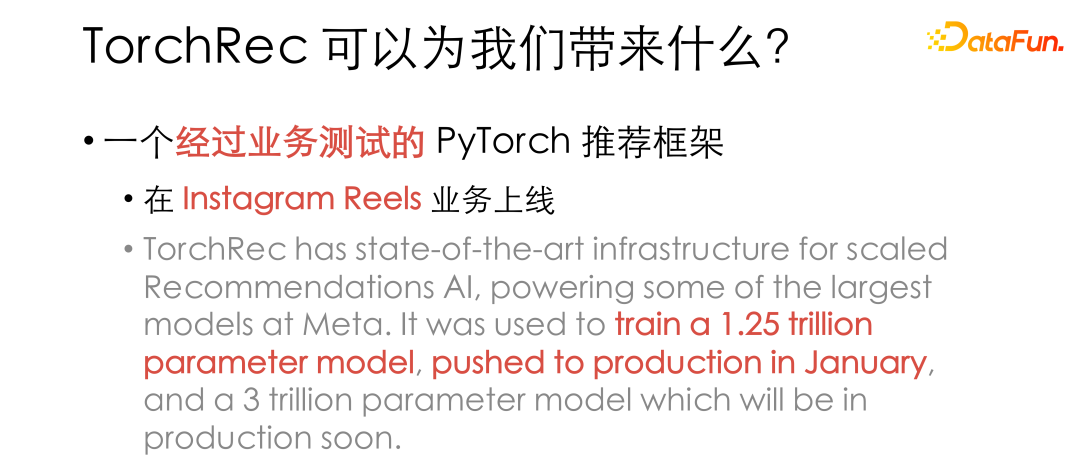
我们先来聊聊 TorchRec 可以给我们带来什么?我们都知道推荐系统往往和公司的现金流直接挂钩,试错成本非常高,所以大家需要的是一个经过了业务测试的框架。这也是为什么之前的一些基于 PyTorch 的推荐框架都未曾被广泛应用过。而 TorchRec 作为一个官方的推荐框架,在 2022 年 1 月份推出之时,Meta就已经利用它在 Instagram Reels 业务上顺利训练并上线了一个 1250 亿参数的模型,成为了一个经过业务测试的 PyTorch 框架。有了 Instagram 这样一个大业务的支撑,让我们有了更多信心,终于可以去理性地考量一个基于 PyTorch 的推荐框架有什么样的优势了。
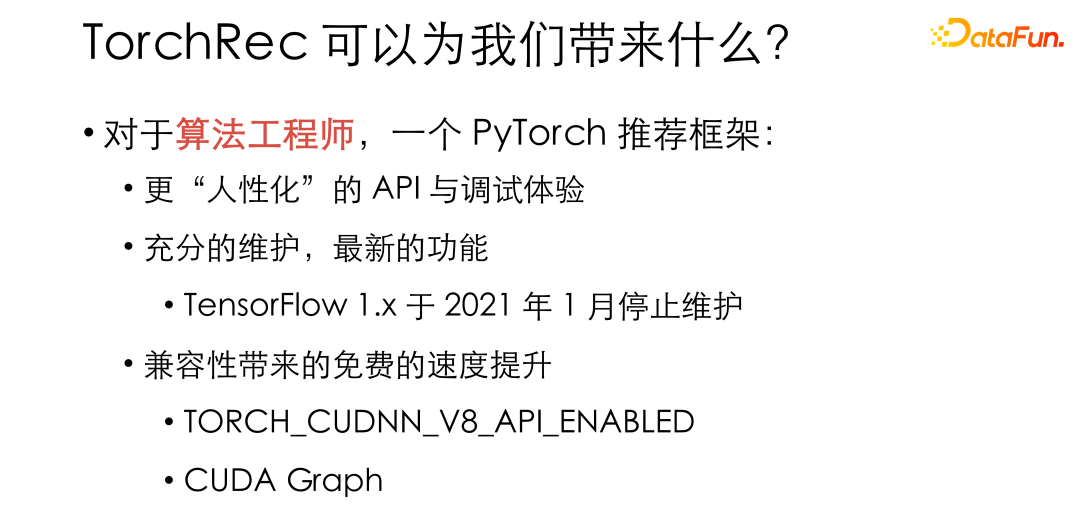
对于团队中的不同成员,TorchRec 有不同的好处。首先,对于团队中占绝大多数的算法工程师而言,PyTorch 推荐框架让大家终于可以享受到像 CV、NLP 工程师体会到的那种更人性化的动态图和调试的体验。
另外,PyTorch 极好的兼容性——一个基于 PyTorch1.8 做的模型,不需要改一行代码就可以在最新版本 1.13 上运行——让算法工程师终于可以放心地升级框架,从而享受到最新的框架功能和更优秀的性能。而反观一些基于 TensorFlow 的推荐框架,往往被卡在 TensorFlow 的某一个版本上,例如很多团队可能还在使用基于 TensorFlow 1.x 的内部框架。TensorFlow 1.x 在 2021 年 1 月份就已经停止维护了,这就意味着在近两年的时间内,所有新出的 bug、新出的特性都无法得到很好的支持。使用过程中遇到的问题,也只能靠内部维护团队去修复,增加了额外的成本。及时的框架升级还可以带来免费的速度提升,高版本的 PyTorch 往往匹配更高版本的 CUDA,以及像 CUDA graph 等的一些新特性,可以进一步提升训练速度,提升训练效率。
除了算法工程师,框架团队也是推荐团队的重要组成部分。公司中的框架团队会在选取开源框架之后基于内部需求进行二次开发。对于他们来说,一个 PyTorch 的推荐框架会带来更简化的开发体验。很多传统的 TensorFlow 推荐框架会模仿 TF serving 来做一个基于 C++ session 的扩展——这样的设计方案在当时算是非常先进的方案——但这使得只改一行代码也需要完整地编译整个 TensorFlow,耗时很长,甚至还要在解决在内网下载外部的依赖之类的琐碎问题,开发体验不太好。
使用 PyTorch 不会遇到这样的问题,因为 PyTorch 以 Python 哲学为核心,它希望大家能够自如地进行扩展。我们在进行二次开发的时候,只需要用 pybind11 这样比较成熟的 Python 库封装一下,把我们的库打包成一个动态链接库,就可以加载了。这样自然整体编译速度会快很多,同时学习成本也会低不少。
前面提到 PyTorch 是一个向后兼容性非常好的框架,这让维护团队不需要去维护多个版本,很多共性的问题都可以得到官方的解决,大家就可以专注于特化需求,团队人员效率就会有明显提升。
上面介绍的都是 TorchRec 作为一个 PyTorch 推荐框架的优势,让我们感到非常开心的是,TorchRec 团队没有止步于做一个 PyTorch 推荐框架。他们观察了现有推荐模型以及硬件的特点,在框架中加入了许多的新特性,使得 TorchRec 相比于传统的推荐框架有明显的性能优势。接下来我会选择其中的几个来进行介绍,分别是 GPU embedding,TorchRec 里面优秀的 GPU kernel,还有 TorchRec 能够根据网络通信进行的 embedding 划分。
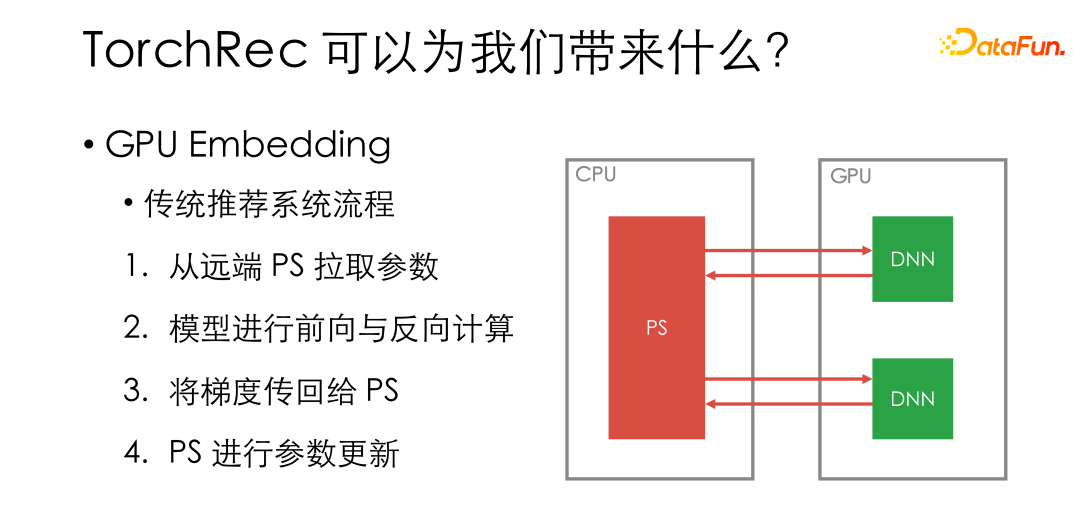
首先是 GPU embedding。我们先来回顾一下传统的推荐系统 GPU 训练流程,我们会把具体的模型放在 GPU worker 上,embedding 存在远端 PS 上。每个迭代步会先从远端 PS 拉取参数,之后在 GPU 上进行模型的前向和反向计算,把梯度传回给 PS,在 PS 上进行参数更新。
图中绿色的部分是在 GPU 上进行的操作,红色的部分是网络或者 CPU 上进行的。可以看到虽然 GPU 是系统中最昂贵的部分,很多操作却都没有放在 GPU 上。
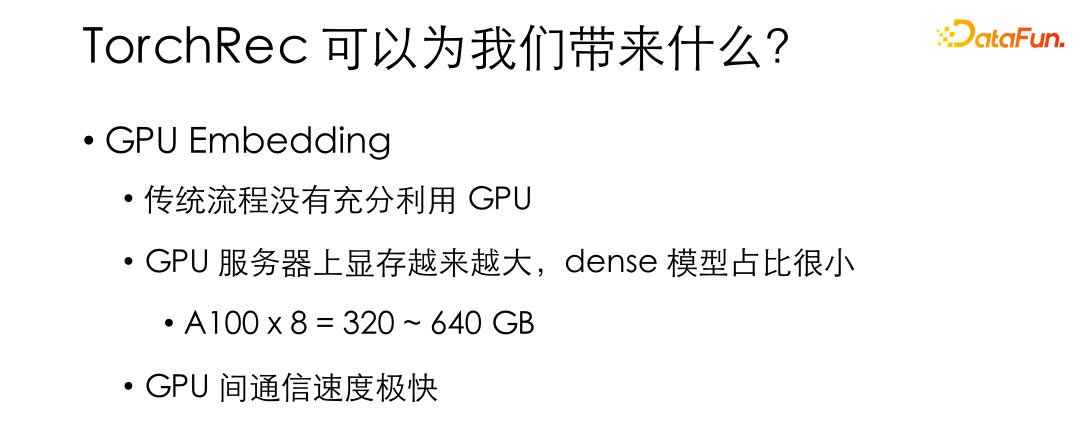
传统流程并没有充分利用好 GPU。同时,从硬件层面来说,GPU 单卡显存越来越大,dense 部分模型远远没有充分利用 GPU;在英伟达的不断优化下,NV link 以及 GPU direct RDMA 还让卡间通信速度越来越快。
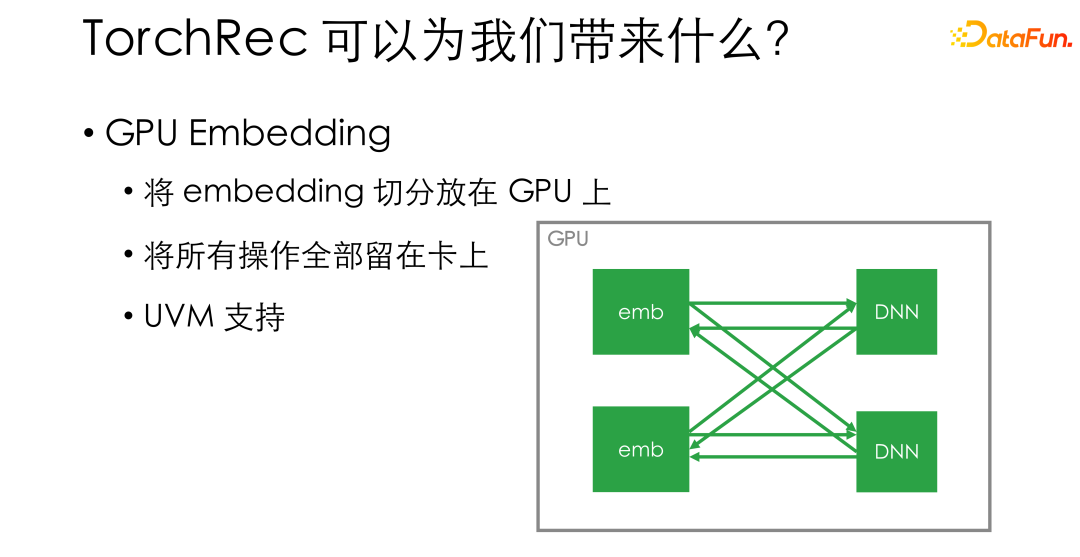
GPU embedding 是一个非常简单的方案。他直接把 embedding 切分放在 GPU 上——比如单机上有 8 张卡,我们把 embedding 直接切分为 8 份,每份放在一张卡上——从而保证所有的操作全都留在卡上。GPU 的利用效率就会有明显提升,训练速度也会有质的飞跃。如果担心 GPU 上面的显存空间不足,TorchRec 还做了 UVM 的支持,可以提前划分一部分主机上的内存作为显存的补充,从而提升单机内部能放下的 embedding 大小。
除去 GPU embedding 以外,TorchRec 还实现了非常优秀的 GPU kernel。这些 kernel 充分利用了最新的硬件特性和 CUDA feature。
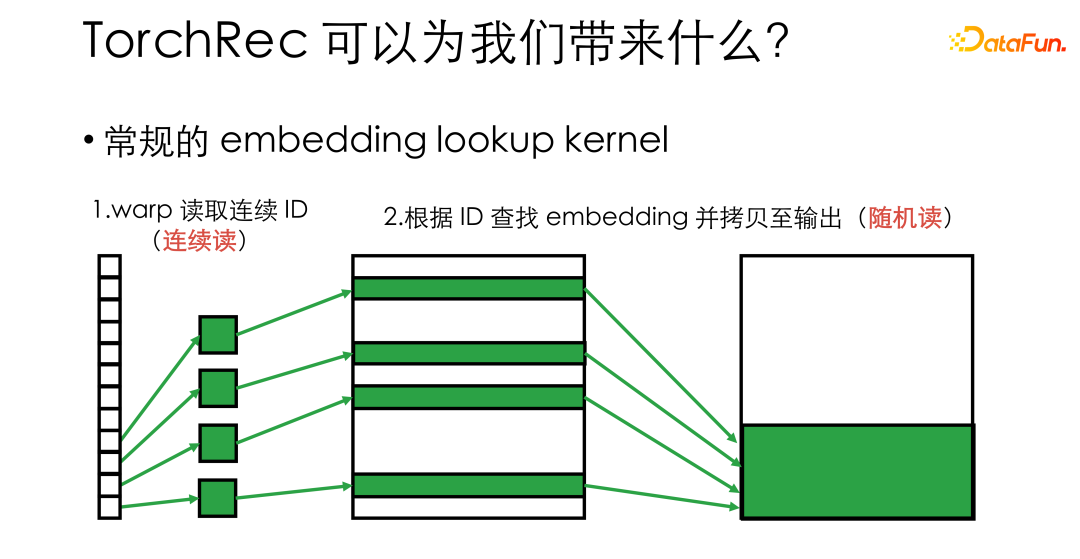
举例来说,假如果要实现一个 embedding lookup kernel,也就是要从一个大的 embedding 里面找到一堆 ID 对应的 embedding vector,那么普通的实现里,会给每个 GPU thread 分配一个 ID,让他们分别去找对应的 embedding。这个时候我们要考虑到,GPU 底层是按 warp 进行调度的,一个 warp 里的 32 个 thread 会一起进行显存读写。这意味着,在上述样流程里,虽然在读取 ID 时连续地访问了显存,但后续的拷贝变成了一个随机读写的状态。对于硬件来说,随机读写无法充分利用显存带宽,运行效率也就不够高。
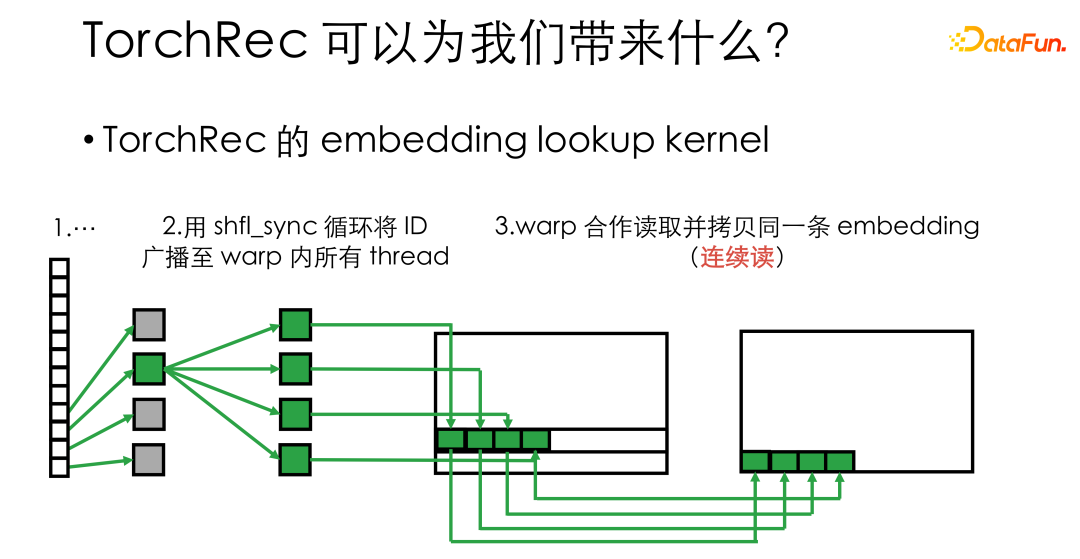
TorchRec 则是在每个 thread 读到 ID 后,利用 shuffle_sync 这样的 warp primitive,将 ID 广播至 warp 内的所有thread 上,从而让一个 wrap 里 32 个 thread 去同时处理同一个 embedding,从而可以进行连续的内存读写,使得显存的带宽利用效率有明显的提升,让 kernel 的速度得到数倍提升。
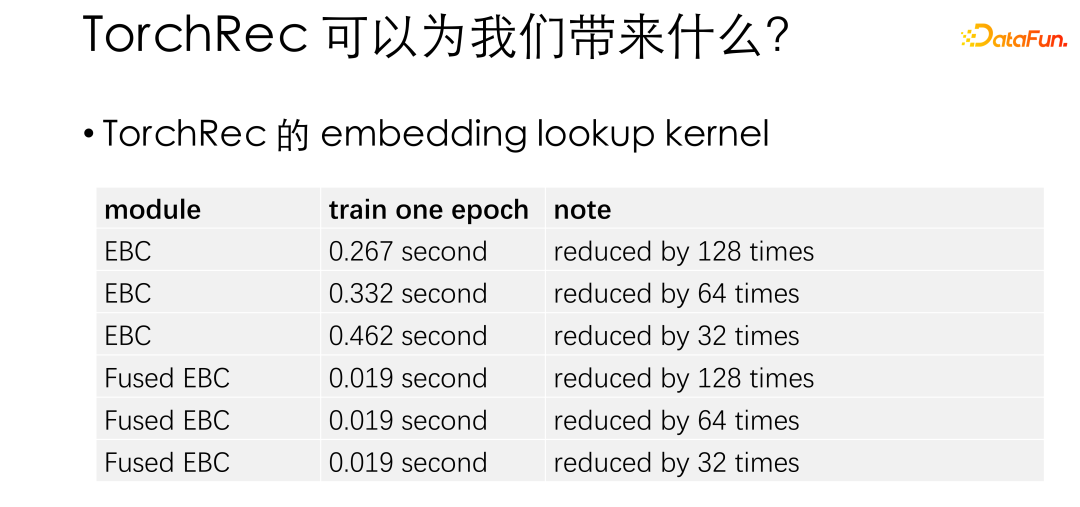
这个表是官方测试的 embedding lookup 性能提升。这里 Fused EBC 是优化后的kernel,可以看到,不同的设置情况下 TorchRec 相较于原生的 PyTorch 有数十倍的性能提升。在 TorchRec 的基础之上,我们发现对于 embedding 比较小的情况(小于128),可能有半数甚至更多的 thread 空闲,所以进一步把 warp 内的 thread 分组,让他们同时去处理多条 embedding。
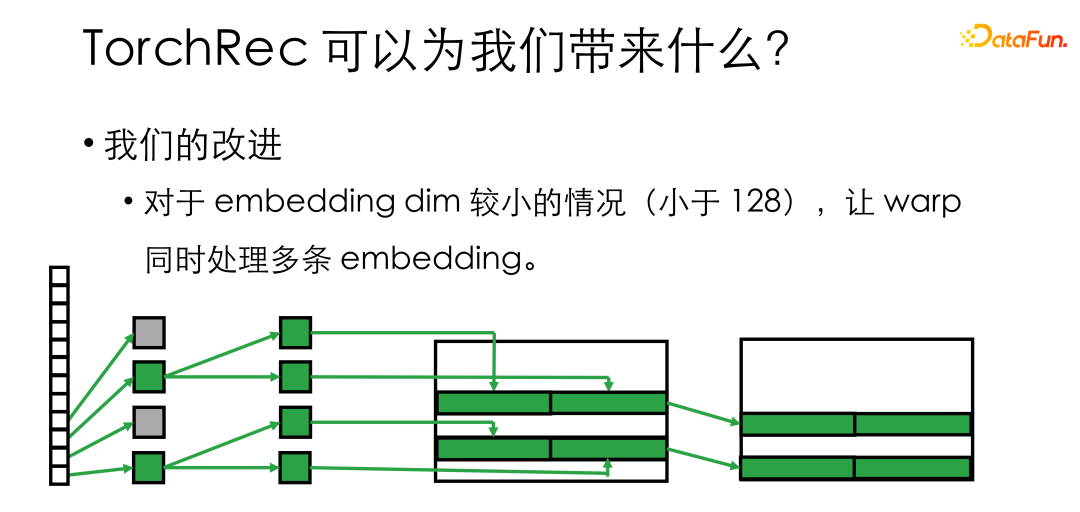
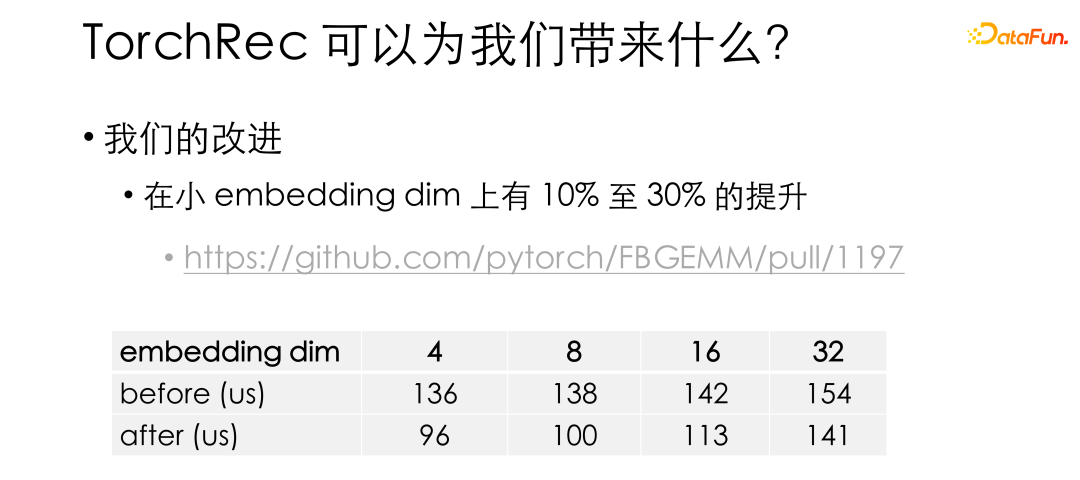
在我们的改进下,小 embedding dim 上 kernel 又有了 10% 到 30% 的提升。这一优化也已经合入官方 repo。要特别指出的是,TorchRec 的 kernel 放在了 FBGEMM 库里,有兴趣朋友可以去看一看。
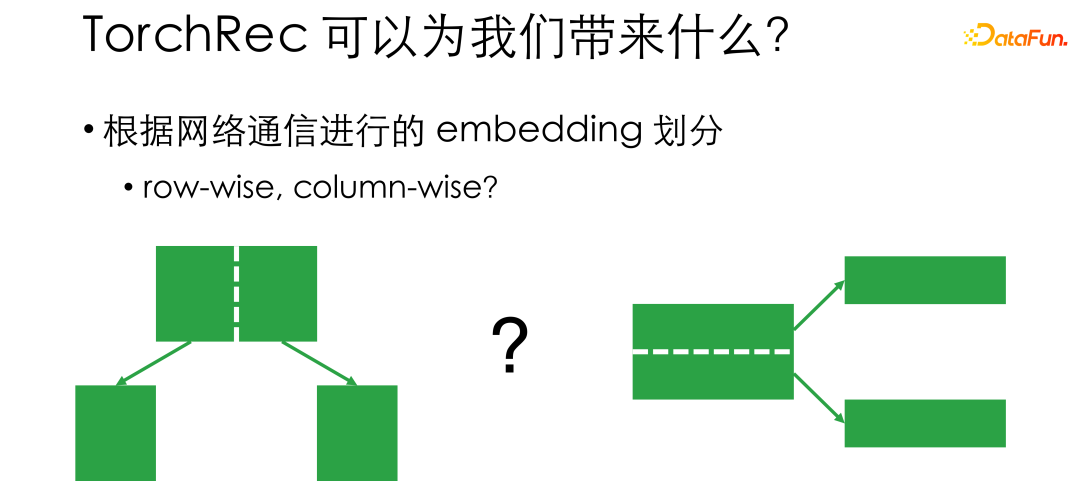
最后想介绍一下 TorchRec 的 embedding 划分机制。前面提到,GPU embedding 就是把 embedding 切分一下放在卡上,那么怎么分就成了一个需要考虑的问题。传统来说有两种划分思路,Row wise 和 Column wise。Row wise 是指假如有 2 万个 feature, 0 号到第 10000 号放在卡 1 上,10000 号到 20000 号放在卡 2 上,这样我们在训练的时候,如果 ID 对应卡 1,我们就从卡 1 上拿,对应卡 2,就从卡 2 上拿。Row wise 的问题在于,因为我们不清楚前 10000 号的通信量和后 10000 号的是不是差距很大,通信都是不均衡的,无法充分利用网络硬件。
Column wise 则是从 embedding 长度角度去划分。例如 embedding 总长是128,可以前 64 维和后 64 维放在不同的位置,这样通信会比较均衡,但是在读取的时候,需要和所有的卡或者 PS 通信。
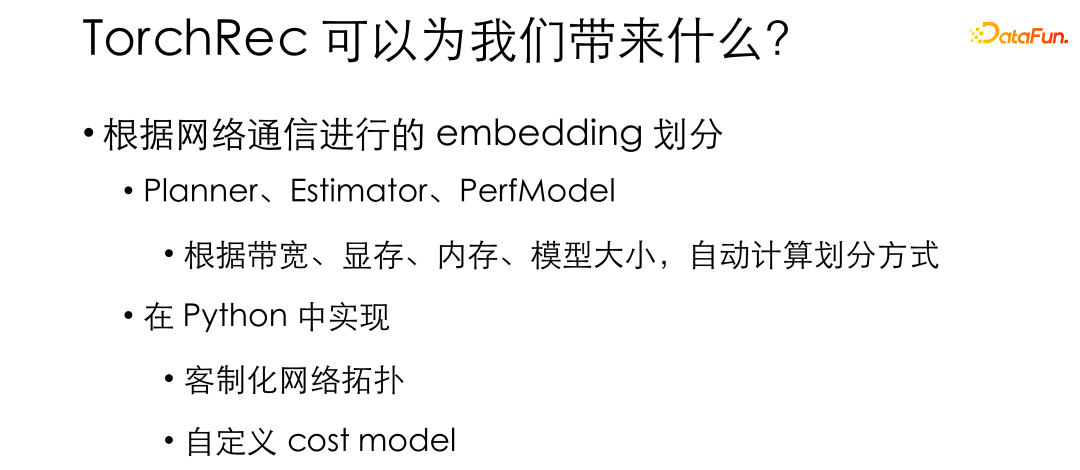
划分模式上的差别带来了选型中的 trade-off。传统的推荐框架会在设计中固定 embedding 的划分方式,而 TorchRec 则在支持了多种划分方式——比如 row wise、column wise,甚至 table wise,data parallel——的基础上,在内部提供了如 Planner、Estimator、PerfModel 等可以根据使用场景的带宽、显存、内存、模型大小等等参数自动地去计算划分的方式的模块。这样就可以根据我们实际硬件情况去最高效地划分 embedding,最高效地利用硬件。这些功能大都是在 Python 里面实现的。方便我们针对内部环境进行客制化,从而不费力地构建出一套最适合于我们内部环境的推荐系统。
二、在百亿模型上的实验效果
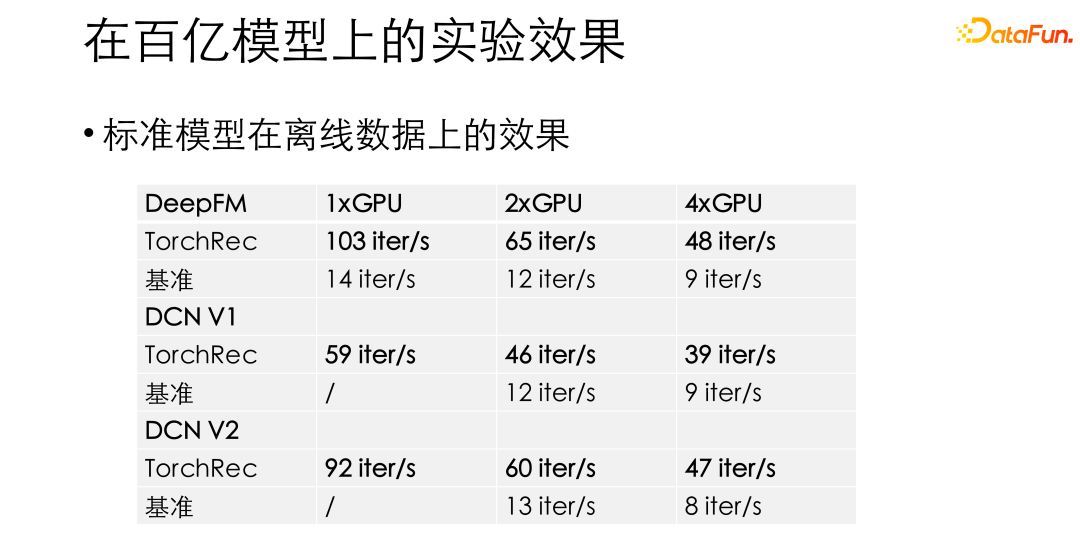
在我们的实验中,对于 DeepFM、DCN 这样的在标准模,TorchRec 相对于之前的基准的推荐框架会有惊人的 10 至 15 倍的性能提升。拿到了这样的性能收益,让我们有信心把 TorchRec 推到了业务上。
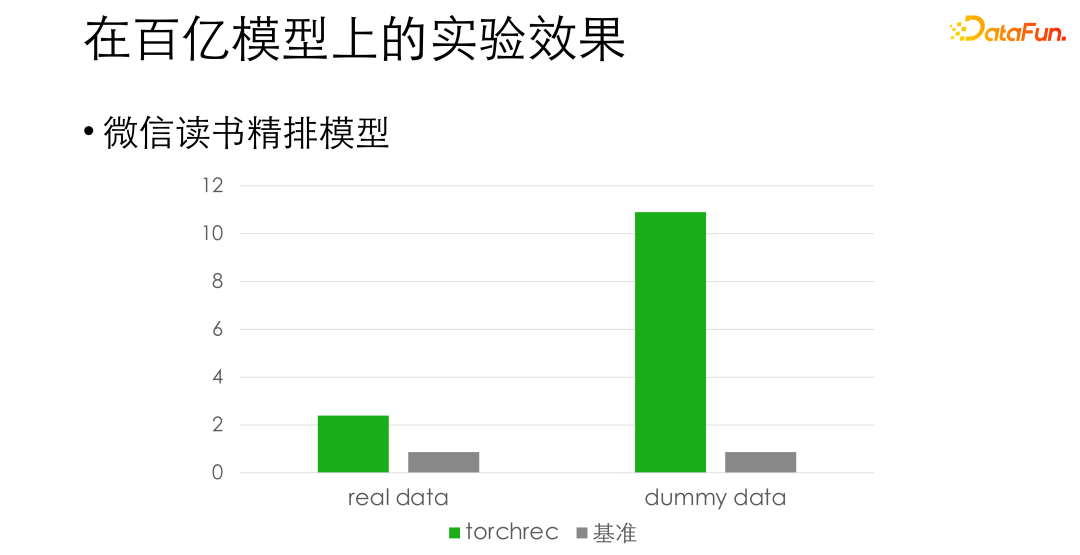
对于微信读书精排模型,在对齐精度的基础上,我们发现在真实数据上有 3 倍左右的性能提升,在假数据上甚至有 10 倍左右提升。这里的差别是因为训练读取数据变成瓶颈了,这方面我们还在做进一步的优化。
03
原始方案在千亿及更大模型上的不足
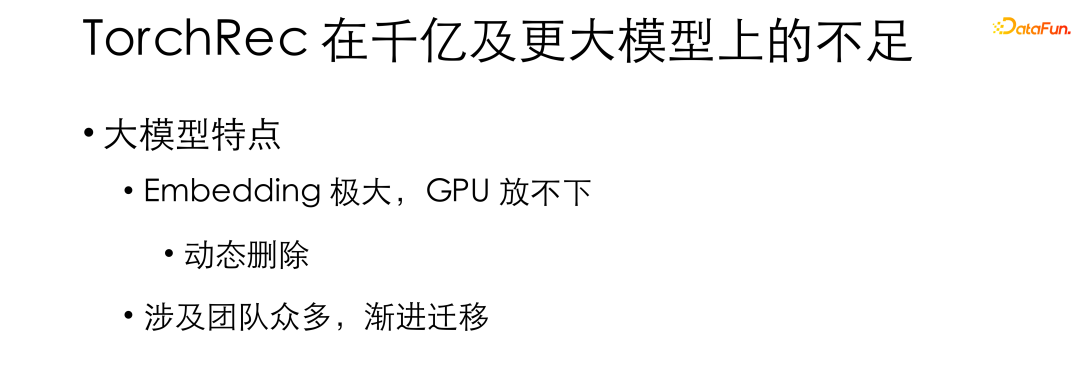
前面介绍的基本是百亿级别或者以下的模型,也就是单机就可以放得下的模型。在把 TorchRec 推到更大的模型的时候,我们观察到 TorchRec 的原生设计的一些问题。对于大模型来说,TorchRec 的纯 GPU embedding 方案需要更多的卡——可能原本 8 张卡的训练速度就可以吃进全部数据,但是我们要用 16 张卡放下 embedding,这使得好不容易提升上去的 GPU 硬件利用效率又被拖了下来。
而且对于大模型的场景,算法团队往往会提出 embedding 的动态增删需求,例如删除一周没有访问过的 ID。TorchRec 的方案是不支持这样特性的。还有,超大模型的业务一般都会涉及诸多团队,迁移基层框架会遇到很大的阻力。我们需要的支持逐步地渐进迁移,而不能让大家一起放下手头的工作,那样的成本过高,风险太大。
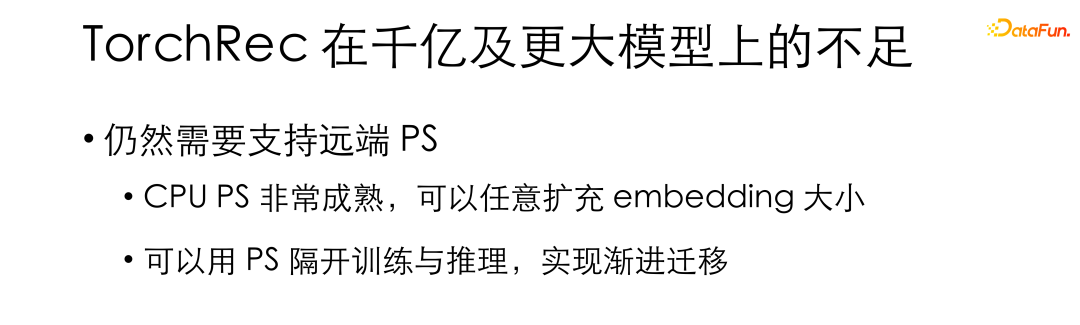
根据上述的需求,我们考虑如何去修改 TorchRec,使得它能够适应超大规模模型的场景。我们认为在超大规模训练中,仍然需要支持连接远程的 PS,因为远端 CPU PS 已经非常成熟了,非常容易支持 embedding 的动态增添。同时,对于跨团队的合作,可以用 PS 来隔离开训练和推理,实现渐进的迁移。
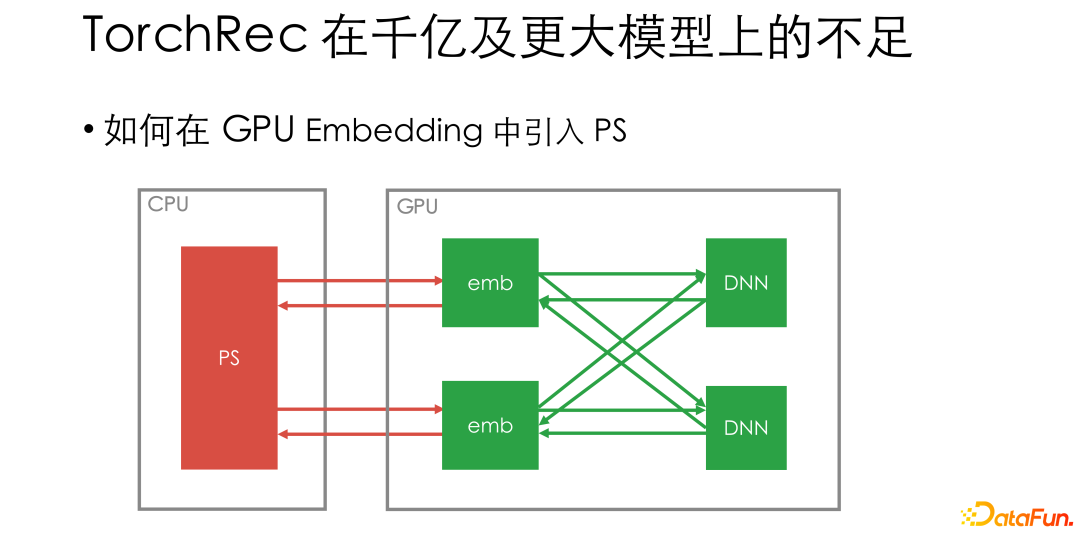
那么接下来一个问题就是该如何引入 PS。如果把 PS 直接连到 GPU embedding 上,每个迭代步还是要去访问远端的 PS,会重新使网络和 CPU 整体操作的占比提升,GPU 利用率又被拉下来了。
04
微信团队的 dynamic embedding 如何解决问题
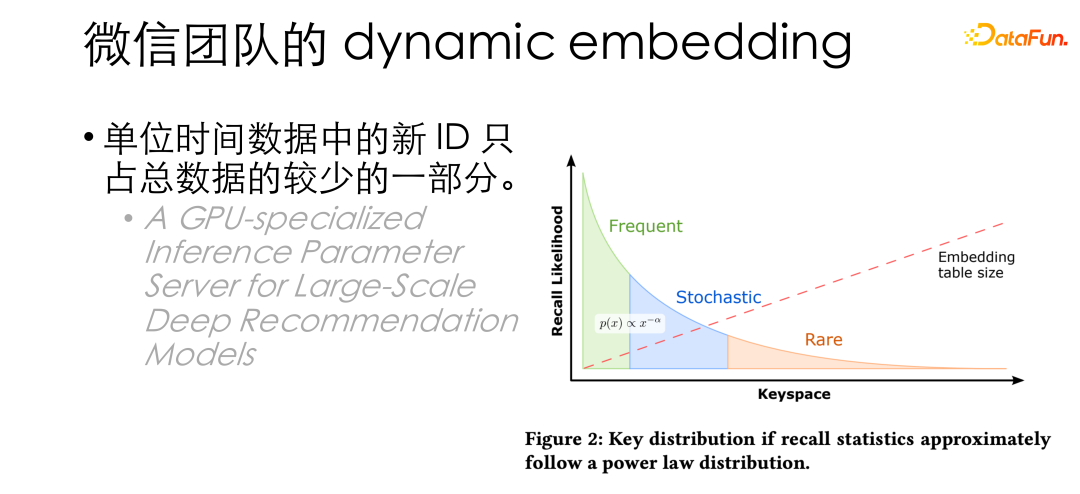
这个时候我们发现单位时间内数据中的新 ID 实际上只占总数据中很少的一部分, HugeCTR 发表论文中也提到相似的结论:只有一小部分的 ID 会被频繁访问。由此,我们想到先正常使用 GPU embedding 进行训练,在显存放满时再将 ID 批量驱逐至 PS。
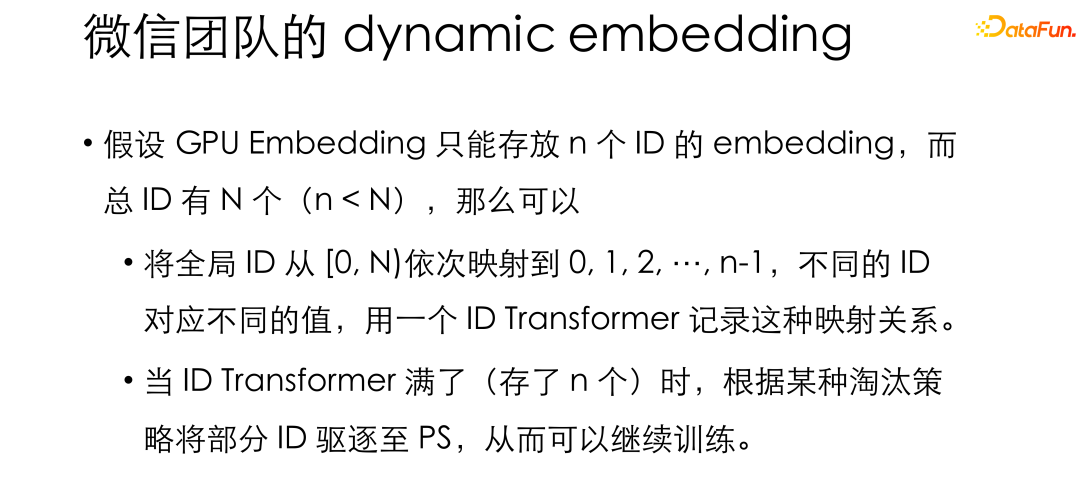
根据这样的一个思路,假如 GPU embedding 里面只能存下 n 个 ID,而总 ID 有 N 个,甚至无穷多个。可以将全局的 ID 按顺序映射到 0、1、2、3…,并把把映射关系存在一个叫 ID transform 的结构中,让 GPU embedding 利用映射的结果进行正常的训练。当 GPU embedding 放满了,也就是 ID transformer 中 n 对映射的时候,再批量驱逐 ID 至 PS。
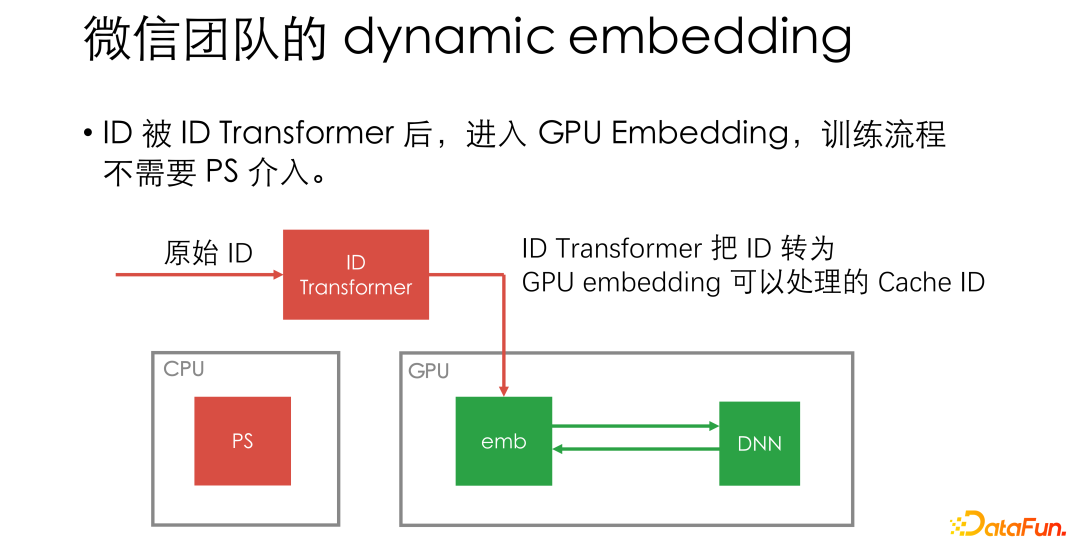
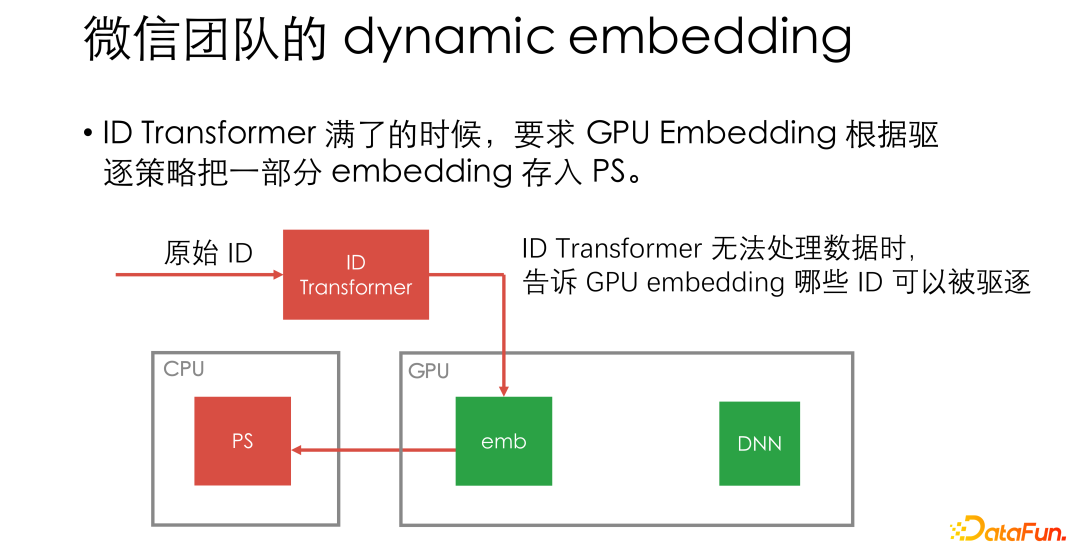
在这种设计下,可以使得 PS 很少介入,只有在驱逐时才需要 GPU worker 和 PS 通信。
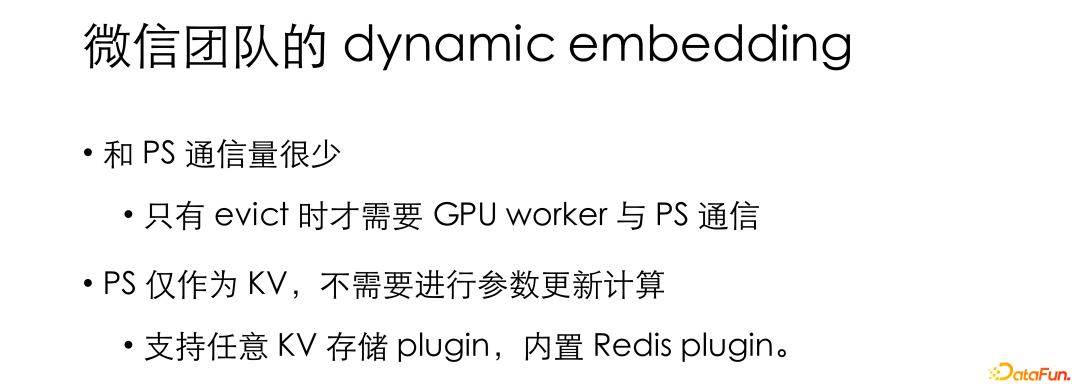
除此之外,这样的设计中 PS 只需要作为 KV,不需要支持参数更新,也就不需要实现优化器相关的操作,从而让 PS 团队专注于存储相关的工作。我们也支持实现了任意 KV 存储的插件,在开源版本中更是内置了 Redis 插件,让 Redis 也可以作为一个 PS 来使用。
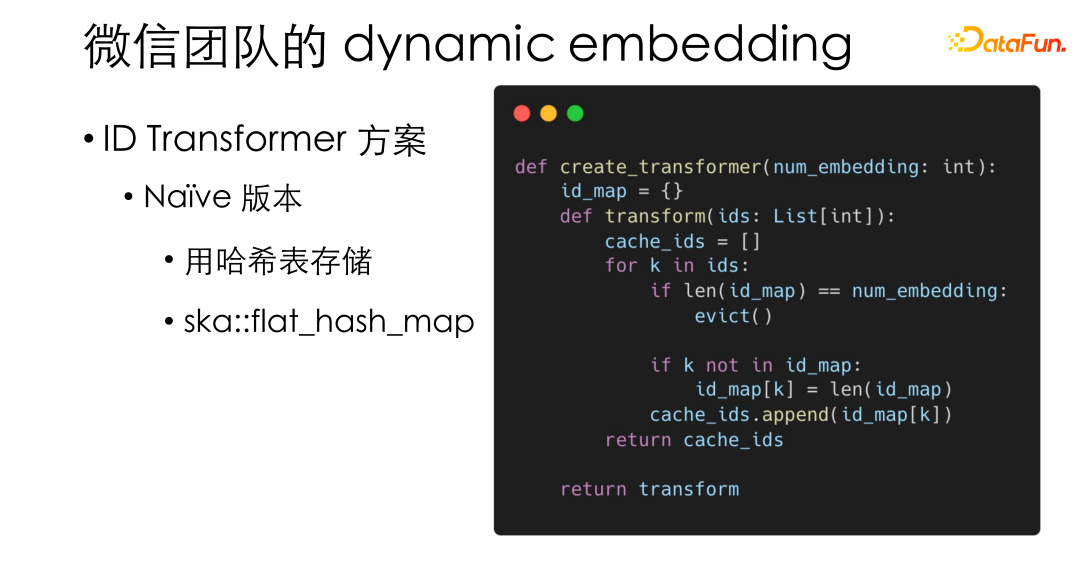
下面介绍一些 dynamic embedding 中的设计细节。我们实现的最简基础的 ID Transformer,其实也就是用一个哈希表,使用的是 PyTorch 里高性能的 ska::flat_hash_map。
ID Transformer 作为流程中仅有的 CPU 操作,对性能要求可能会比较高,所以我们还实现了一个高性能的版本,以 L1 cacheline 为单位存储,从而进一步提升内存的访存效率。
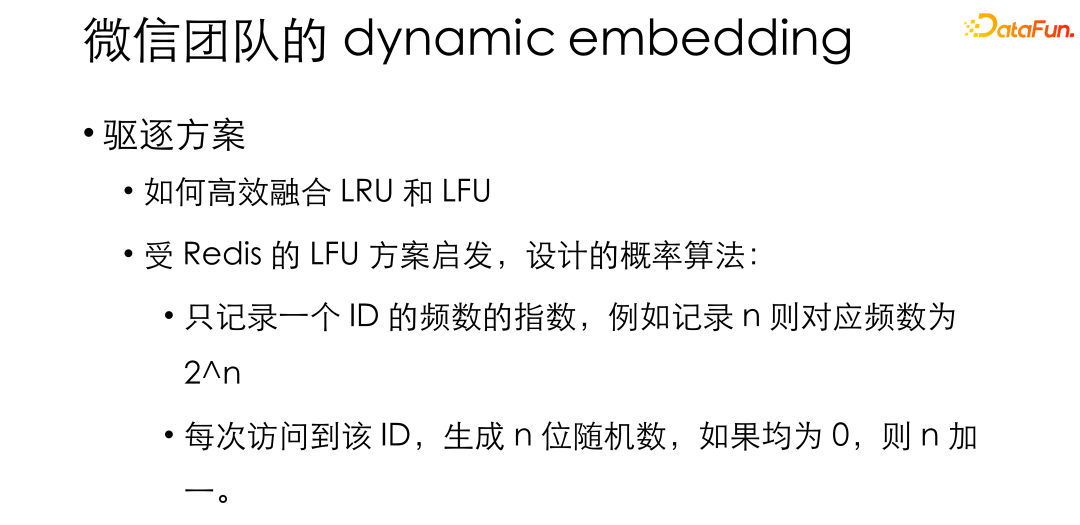
另外,对于驱逐方案,我们希望在不增加内存缓存压力的情况下,高效地融合 LRU 和 LFU。受到 Redis 的 LFU 方案的启发,我们设计了一种概率的算法:只存储 ID 访问频数的指数。比如访问了 32 次即存储 5。在更新频数时,如果又访问到这个 ID,就生成 5 位的随机数,如果在 5 位全为 0,也就是发生了概率为 1/ 32 的事件,我们就增加频数指数为 6。通过这样的概率算法,就可以把 LRU 和LFU 的频数放到 uint32 里面,在不提高访存压力的情况下融合了 LRU 和 LFU。
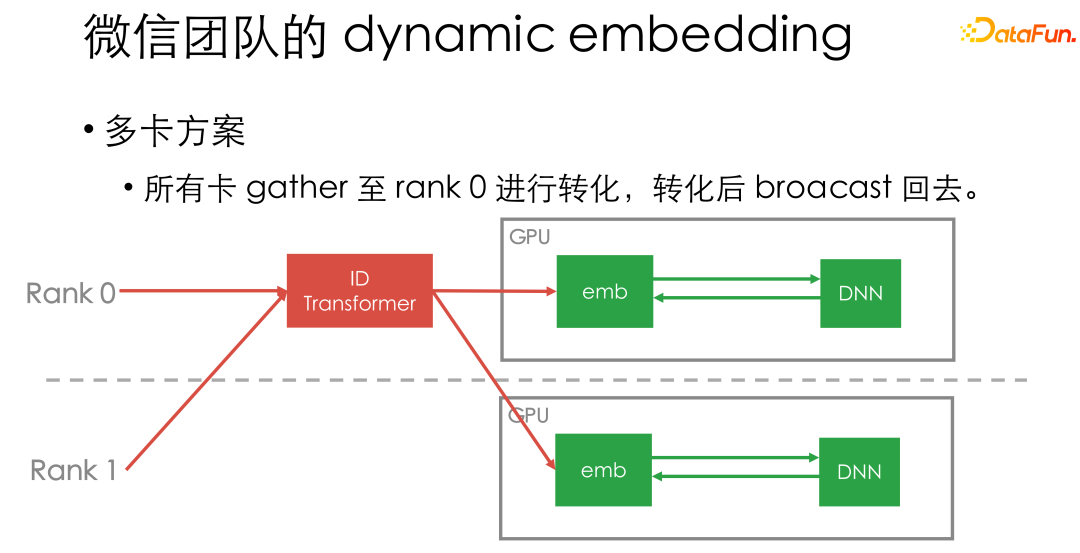
最后来简单介绍一下我们的多卡方案。我们目前是将所有卡的数据都先 gather 到卡一的 ID Transformer 上,之后再 broadcast 回去。因为我们实现的 ID Transformer 的性能非常高,而且可以和 GPU 计算 Pipeline 起来,不会成为具体的性能瓶颈。
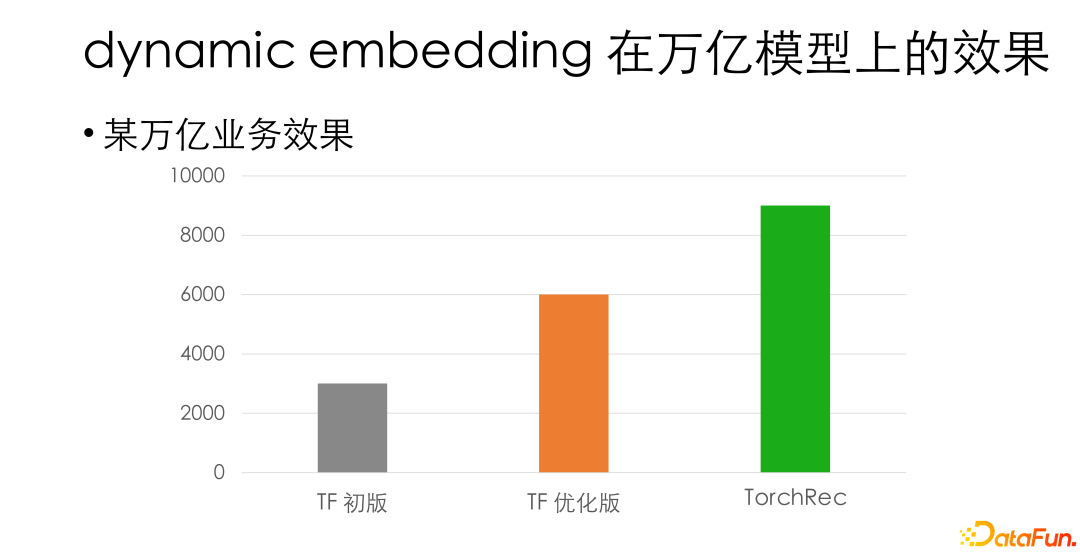
以上就是 dynamic embedding 在设计上一些想法。在我们内部的一个万亿级的业务上,在对齐精度情况下,dynamic embedding 方案相对于我们内部原始的 GPU Tensorflow 框架有 3 倍左右的性能提升。相比于 TF 优化版也仍然有 50% 以上的性能优势。
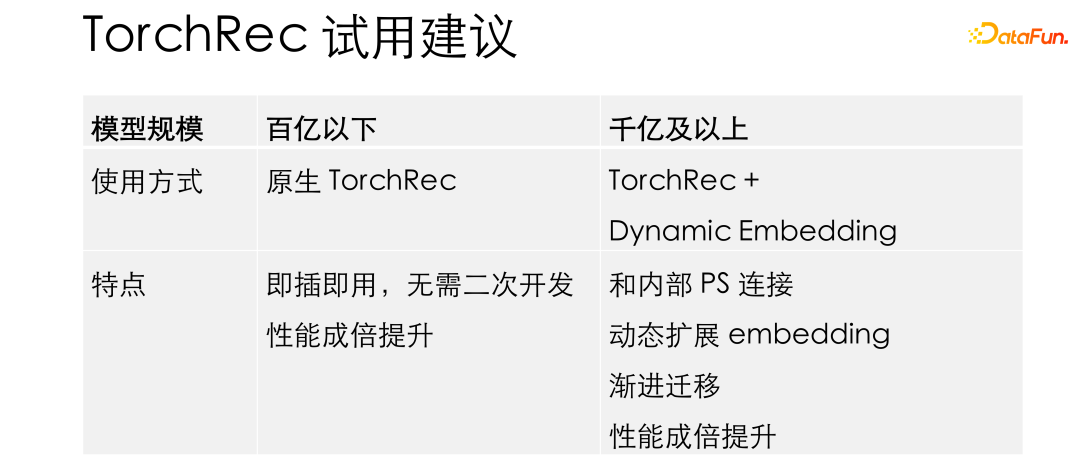
最后推荐大家去试用一下 Torchrec。对于相对较小的业务,比如百亿下的业务,推荐大家直接使用原生的 TorchRec:即插即用,不需要任何的二次开发,性能可以得到成倍的提升。对于极大的业务,则推荐大家尝试配合我们合进 TorchRec 的 dynamic embedding,一方面方便连接内部的 PS,另一方面也支持 embedding 的扩展和渐进迁移,同时还是可以获得一定的性能提升。
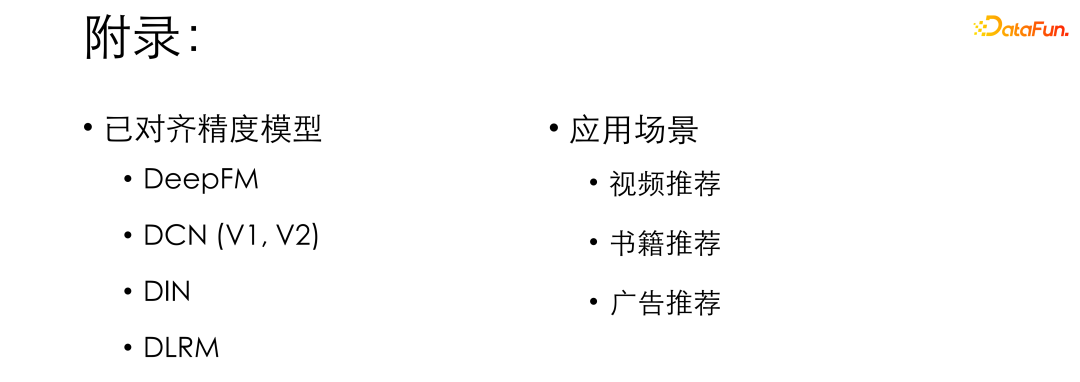
这里是我们已经对齐的一些精度的模型和已有的应用场景,有兴趣的朋友可以去试一下。
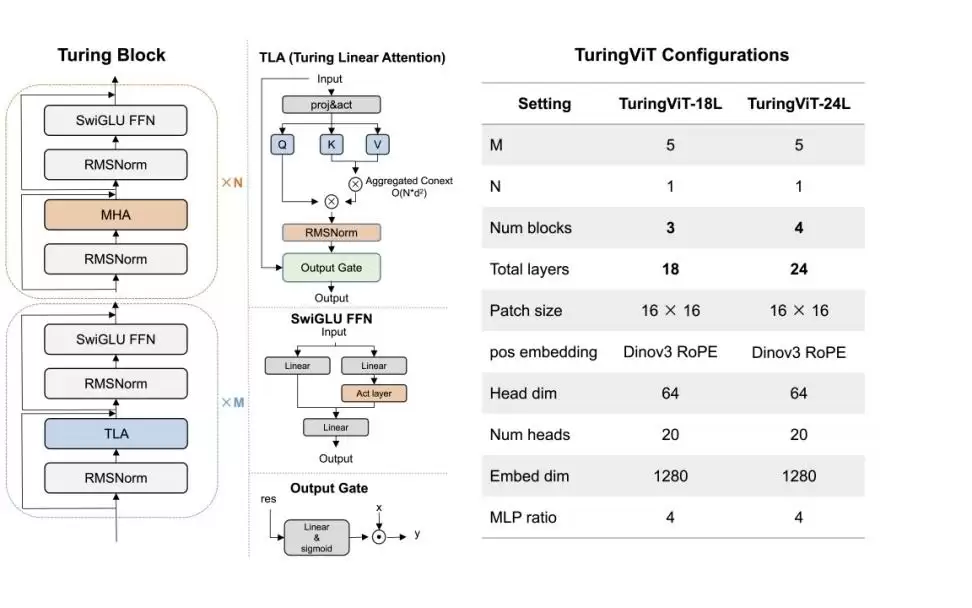
小鹏集团发布TuringViT高效视觉编码器,通过线性注意力主导、高质量数据治理与原生动态分辨率三大技术,仅用0.85B图文对训练即在多项基准上超越10B数据基线,全面支撑智能驾驶、智能座舱及人形机器人场景。
答案:使用scikit-learn训练模型需经历数据准备、模型选择、训练与评估。以鸢尾花数据集为例,通过加载数据、划分训练测试集、选择逻辑回归模型、训练、预测及评估完成流程。初学者宜从逻辑回归、决策树、KNN等易理解的模型入手。数据预处理至关重要,常用方法包括标准化、归一化、缺失值填充和独热编码,Pipeline与ColumnTransformer可整合预处理步骤。为避免过拟合,可采用正则化、交叉验证、简化模型或增加数据;应对欠拟合则需提升模型复杂度或特征数量。
文本分类是自然语言处理(NLP)任务之一,它旨在将文本归类到预定义的类别中。文本分类有很多实际应用,例如电子邮件过滤、垃圾邮件检测、情感分析和问答系统等。使用pythonNLTK库完成文本分类的任务可以分为以下几个步骤:数据预处理:首先,需要对数据进行预处理,包括去除标点符号、转换成小写、去除空格等。特征提取:接下来,需要从预处理后的文本中提取特征。特征可以是词语、词组或句子。模型训练:然后,需要使用提取的特征来训练一个分类模型。通常使用的分类模型包括朴素贝叶斯、支持向量机和决策树等。评估:最后,需要对训

随着机器学习的广泛应用和深度学习的不断发展,高效的模型训练和验证逐渐成为一个非常重要的问题。Go语言是一种开发高效、可靠、简洁的系统级编程语言,其在计算机科学领域的应用日益广泛。本文将介绍如何在Go语言中实现高效的模型训练和验证。一、Go语言与机器学习Go语言作为一种系统级编程语言,被广泛应用于Web应用、网络编程、云计算等领域,并且近年来在机器学习领域也逐
Python底层技术揭秘:如何实现模型训练和预测,需要具体代码示例作为一门易学易用的编程语言,Python在机器学习领域中被广泛使用。Python提供了大量的开源机器学习库和工具,比如Scikit-Learn、TensorFlow等。这些开源库的使用和封装为我们提供了很多便利,但如果我们要深入了解机器学习的底层技术,仅仅会使用这些库和工具是不够的。本文将深入
数据稀缺对模型训练的影响问题,需要具体代码示例在机器学习和人工智能领域,数据是训练模型的核心要素之一。然而,现实中我们经常面临的一个问题是数据稀缺。数据稀缺指的是训练数据的量不足或标注数据的缺乏,这种情况下会对模型训练产生一定的影响。数据稀缺的问题主要体现在以下几个方面:过拟合:当训练数据量不够时,模型很容易出现过拟合的现象。过拟合是指模型过度适应训练数据,
如何在PHP微服务中实现分布式算法和模型训练引言:随着云计算和大数据技术的快速发展,数据处理和模型训练的需求越来越大。分布式算法和模型训练是实现高效、快速、可扩展性的关键。本文将介绍如何在PHP微服务中实现分布式算法和模型训练,并提供一些具体代码示例。一、什么是分布式算法和模型训练分布式算法和模型训练是利用多台机器或者服务器资源同时进行数据处理和模型训练的技
了解DeepSeek V4.1 Flash 1017的Agent Arena指标、约0.20美元任务成本中位数,以及Terminal-Bench 4.0和ProgramBench成绩变化与适用边界。
了解DeepSeek模型权重与DeepInfer推理框架的对象差异,查看官方项目入口,并从价格竞争、开发者协作和小团队参与三个角度理解开源策略。
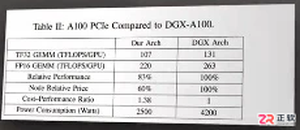
理清幻方量化与DeepSeek的发展脉络,关键在于区分早期萤火二号的A100集群积累与DeepSeek-V3的H800训练配置。本文解析软硬件协同工程在其中的作用,避免将资金投入简单等同于模型能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



