

超参数优化比较之网格搜索、随机搜索和贝叶斯优化
译者|朱先忠审校|孙淑娟简介通常,在尝试改进机器学习模型时,人们首先想到的解决方案是添加更多的训练数据。额外的数据通常是有帮助(在某些情况下除外)的,但生成高质量的数据可能非常昂贵。通过使用现有数据获得最佳模型性能,超参数优化可以节省我们的时间和资源。顾名思义,超参数优化是为机器学习模型确定最佳超参数组合以满足优化函数(即,给定研究中的数据集,最大化模型的性能)的过程。换句话说,每个模型都会提供多个有关选项的调整“按钮”,我们可以改变它们,直到我们模型的超参数达到最佳组合。在超参数优化过程
译者 | 朱先忠
审校 | 孙淑娟
简介
通常,在尝试改进机器学习模型时,人们首先想到的解决方案是添加更多的训练数据。额外的数据通常是有帮助(在某些情况下除外)的,但生成高质量的数据可能非常昂贵。通过使用现有数据获得最佳模型性能,超参数优化可以节省我们的时间和资源。
顾名思义,超参数优化是为机器学习模型确定最佳超参数组合以满足优化函数(即,给定研究中的数据集,最大化模型的性能)的过程。换句话说,每个模型都会提供多个有关选项的调整“按钮”,我们可以改变它们,直到我们模型的超参数达到最佳组合。在超参数优化过程中,我们可以更改的参数的一些示例可以是学习率、神经网络的架构(例如,隐藏层的数量)、正则化等。
在这篇文章中,我们将从概念上介绍三种最常见的超参数优化方法,即网格搜索、随机搜索和贝叶斯优化,然后对它们进行逐一实现。
我将在文章一开始提供一个高级别的比较表,以供读者参考,然后将在本文的其余部分进一步探讨、解释和实施比较表中的每一项。
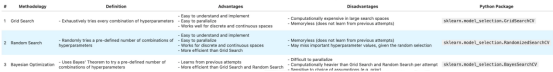
表1:超参数优化方法比较
1.网格搜索算法
网格搜索可能是超参数优化的最简单和最直观的方法,它涉及在定义的搜索空间中彻底搜索超参数的最佳组合。在此上下文中的“搜索空间”是整个超参数以及在优化过程中考虑的此类超参数的值。让我们通过一个示例来更好地理解网格搜索。
假设我们有一个只有三个参数的机器学习模型,每个参数都可以取下表中提供的值:
parameter_1 = [1, 2, 3] parameter_2 = [a, b, c] parameter_3 = [x, y, z]
我们不知道这些参数的哪个组合将优化我们的模型的优化功能(即为我们的机器学习模型提供最佳输出)。在网格搜索中,我们只需尝试这些参数的每一个组合,测量每个参数的模型性能,然后简单地选择产生最佳性能的组合!在此示例中,参数1可以取3个值(即1、2或3),参数2可以取3种值(即a、b和c),参数3可以取3种值(即x、y和z)。换句话说,总共有3*3*3=27个组合。本例中的网格搜索将涉及27轮评估机器学习模型的性能,以找到性能最佳的组合。
如您所见,这种方法非常简单(类似于试错任务),但也有一些局限性。让我们一起总结一下此方法的优点和缺点。
其中,优势包括:
- 易于理解和实施
- 易于并行化
- 适用于离散和连续空间缺点主要有:
- 在具有大量超参数的大型和/或复杂模型中成本高昂(因为必须尝试和评估所有组合)
- 无记忆——不从过去的观察中学习
- 如果搜索空间太大,可能无法找到最佳组合我的建议是,如果您有一个搜索空间较小的简单模型,请使用网格搜索;否则,建议继续往下阅读以找到更适合更大搜索空间的解决方案。
现在,让我们用一个真实的例子来实现网格搜索。
1.1.网格搜索算法实现
为了实现网格搜索,我们将使用scikit-learn中的Iris数据集创建一个随机森林分类模型。该数据集包括3种不同的鸢尾花瓣和萼片长度,将用于本次分类练习。在本文中,模型开发是次要的,因为目标是比较各种超参数优化策略的性能。我鼓励您关注模型评估结果,以及每种超参数优化方法达到所选超参数集所需的时间。我将描述运行结果,然后为本文中使用的三种方法提供一个汇总比较表。
包括所有超参数值的搜索空间,定义如下:
search_space = {'n_estimators': [10, 100, 500, 1000],
'max_depth': [2, 10, 25, 50, 100],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 5, 10]}上述搜索空间由4*5*3*3=180个超参数的总组合组成。我们将使用网格搜索来找到优化目标函数的组合,如下所示:
# Import libraries
from sklearn.model_selection import GridSearchCV
from sklearn.datasets import load_iris
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score
import time
# 加载Iris数据集
iris = load_iris()
X, y = iris.data, iris.target
#定义超参数搜索空间
search_space = {'n_estimators': [10, 100, 500, 1000],
'max_depth': [2, 10, 25, 50, 100],
'min_samples_split': [2, 5, 10],
'min_samples_leaf': [1, 5, 10]}
#定义随机林分类器
clf = RandomForestClassifier(random_state=1234)
# 生成优化器对象
optimizer = GridSearchCV(clf, search_space, cv=5, scoring='accuracy')
#存储起始时间,以便用于计算总的耗时
start_time = time.time()
#拟合数据上的优化器
optimizer.fit(X, y)
# 存储结束时间,以便用于计算总的耗时
end_time = time.time()
# 打印最佳超参数集和相应分数
print(f"selected hyperparameters:")
print(optimizer.best_params_)
print("")
print(f"best_score: {optimizer.best_score_}")
print(f"elapsed_time: {round(end_time-start_time, 1)}")上面代码的输出结果如下:
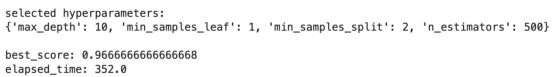
这里我们可以看到使用网格搜索选择的超参数值。其中,best_score描述了使用所选超参数集的评估结果,而elapsed_time描述了我的本地笔记本电脑执行此超参数优化策略所花费的时间。在进行下一种方法时,请记住评估结果和经过的时间,以便进行比较。现在,让我们进入随机搜索的讨论。
2.随机搜索算法
顾名思义,随机搜索是从定义的搜索空间中随机采样超参数的过程。与网格搜索不同,随机搜索只会在预定义的迭代次数(取决于可用资源,如时间、预算、目标等)中选择超参数值的随机子集,并计算每个超参数的机器学习模型的性能,然后选择最佳的超参数值。
根据上述方法,您可以想象,与完整的网格搜索相比,随机搜索成本更低,但仍有其自身的优势和劣势,如下所示:
优势:
- 易于理解和实施
- 易于并行化
- 适用于离散和连续空间
- 比网格搜索便宜
- 与具有相同尝试次数的网格搜索相比,更可能收敛到最优缺点:
- 无记忆——不从过去的观察中学习
- 考虑到随机选择,可能会错过重要的超参数值
在下一个方法中,我们将通过贝叶斯优化解决网格和随机搜索的“无记忆”缺点。但在讨论此方法之前,让我们先来实现随机搜索。
2.1.随机搜索算法实现
使用下面的代码片段,我们将针对网格搜索实现中描述的相同问题实现随机搜索超参数优化。
# 导入库
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint
# 创建一个RandomizedSearchCV对象
optimizer = RandomizedSearchCV(clf, param_distributinotallow=search_space,
n_iter=50, cv=5, scoring='accuracy',
random_state=1234)
# 存储开始时间以计算总运行时间
start_time = time.time()
# 拟合数据上的优化器
optimizer.fit(X, y)
# 存储结束时间以计算总运行时间
end_time = time.time()
# 打印最佳超参数集和相应分数
print(f"selected hyperparameters:")
print(optimizer.best_params_)
print("")
print(f"best_score: {optimizer.best_score_}")
print(f"elapsed_time: {round(end_time-start_time, 1)}")上面代码的输出结果如下:
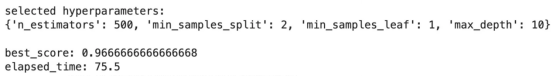
随机搜索结果
与网格搜索的结果相比,这些结果非常有趣。best_score保持不变,但elapsed_time从352.0秒减少到75.5秒!真是令人印象深刻!换句话说,随机搜索算法设法找到了一组超参数,在网格搜索所需时间的21%左右,其性能与网格搜索相同!但是,这里的效率高得多。
接下来,让我们继续我们的下一种方法,称为贝叶斯优化,它从优化过程中的每一次尝试中学习。
3.贝叶斯优化
贝叶斯优化是一种超参数优化方法,它使用概率模型从以前的尝试中“学习”,并将搜索引向搜索空间中超参数的最佳组合,从而优化机器学习模型的目标函数。
贝叶斯优化方法可以分为4个步骤,我将在下面描述。我鼓励您通读这些步骤,以便更好地理解流程,但使用这种方法并不需要什么前提知识。
- 定义一个“先验”,这是一个关于我们在某个时间点对优化目标函数最可能的超参数组合的信念的概率模型
- 评估超参数样本的模型
- 使用步骤2中获得的知识,更新步骤1中的概率模型(即我们所称的“先验”),了解我们认为优化目标函数的超参数的最可能组合在哪里。我们更新的信念称为“后验”。换句话说,在步骤2中获得的知识帮助我们更好地了解搜索空间,并将我们从先验带到后验,使后验成为我们关于搜索空间和目标函数的“最新”知识,由步骤2提供信息
- 重复步骤2和3,直到模型性能收敛、资源耗尽或满足其他预定义指标
如果您有兴趣了解更多有关贝叶斯优化的详细信息,可以查看以下帖子:
《机器学习中的贝叶斯优化算法》,地址是:
https://medium.com/@fmnobar/conceptual-overview-of-bayesian-optimization-for-parameter-tuning-in-machine-learning-a3b1b4b9339f。
现在,既然我们已经了解了贝叶斯优化是如何工作的,那么让我们来看看它的优点和缺点。
优势:
- 从过去的观察中学习,因此效率更高。换句话说,与无记忆方法相比,它有望在更少的迭代中找到一组更好的超参数
- 在给定某些假设的情况下收敛到最优缺点:
- 难以并行化
- 计算量大于网格和每次迭代的随机搜索
- 先验和贝叶斯优化中使用的函数(例如,获取函数等)的初始概率分布的选择会显著影响性能及其学习曲线
在排除了细节之后,让我们实现贝叶斯优化并查看结果。
3.1.贝叶斯优化算法实现
与上一节类似,我们将使用下面的代码片段为网格搜索实现中描述的相同问题实现贝叶斯超参数优化。
# 导入库
from skopt import BayesSearchCV
# 执行贝叶斯优化
optimizer = BayesSearchCV(estimator=RandomForestClassifier(),
search_spaces=search_space,
n_iter=10,
cv=5,
scoring='accuracy',
random_state=1234)
# 存储开始时间以计算总运行时间
start_time = time.time()
optimizer.fit(X, y)
# 存储结束时间以计算总运行时间
end_time = time.time()
# 打印最佳超参数集和相应分数
print(f"selected hyperparameters:")
print(optimizer.best_params_)
print("")
print(f"best_score: {optimizer.best_score_}")
print(f"elapsed_time: {round(end_time-start_time, 1)}")上面代码的输出结果如下:
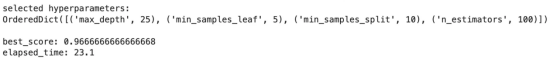
贝叶斯优化结果
另一组有趣的结果!best_score与我们通过网格和随机搜索获得的结果保持一致,但结果仅用了23.1秒,而随机搜索为75.5秒,网格搜索为352.0秒!换句话说,使用贝叶斯优化所需的时间比网格搜索所需的时间大约少93%。这是一个巨大的生产力提升,在更大、更复杂的模型和搜索空间中变得更有意义。
请注意,贝叶斯优化只使用了10次迭代就获得了这些结果,因为它可以从以前的迭代中学习(与随机和网格搜索相反)。
结果比较
下表对目前所讨论的三种方法的结果进行了比较。“Methodology(方法论)”一栏描述了所使用的超参数优化方法。随后是使用每种方法选择的超参数。“Best Score”是使用特定方法获得的分数,然后是“Elapsed Time”,表示优化策略在我的本地笔记本电脑上运行所需的时间。最后一列“获得的效率(Gained Efficiency)”假设网格搜索为基线,然后计算与网格搜索相比,其他两种方法中每种方法获得的效率(使用经过的时间)。例如,由于随机搜索耗时75.5秒,而网格搜索耗时352.0秒,因此相对于网格搜索的基线,随机搜索的效率计算为1–75.5/352.0=78.5%。
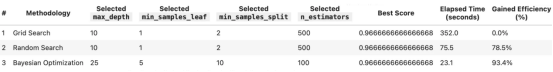
表2——方法性能比较表
以上比较表中的两个主要结论:
- 效率:我们可以看到贝叶斯优化等学习方法如何在更短的时间内找到一组优化的超参数。
- 参数选择:可以有多个正确答案。例如,贝叶斯优化的选定参数与网格和随机搜索的参数不同,尽管评估度量(即best_score)保持不变。这在更大、更复杂的环境中更为重要。
结论
在这篇文章中,我们讨论了什么是超参数优化,并介绍了用于此优化练习的三种最常见的方法。然后,我们详细介绍了这三种方法中的每一种,并在分类练习中实现了它们。最后,我们比较了实施这三种方法的结果。我们发现,从以前的尝试中学习的贝叶斯优化等方法可以显著提高效率,这可能是大型复杂模型(如深度神经网络)中的一个重要因素,其中效率可能是一个决定因素。
译者介绍
朱先忠,51CTO社区编辑,51CTO专家博客、讲师,潍坊一所高校计算机教师,自由编程界老兵一枚。
原文标题:Hyperparameter Optimization — Intro and Implementation of Grid Search, Random Search and Bayesian Optimization,作者:Farzad Mahmoodinobar
想了解Claude怎么收费?本文梳理了Claude Free、Pro及Team版的最新月费价格、消息限额与高级功能权益,并对比了不同层级的性价比,助你快速找到适合的AI办公伙伴。

本文详细解析Sora在国内的使用现状,指出目前官方未对公众开放注册,提醒用户警惕虚假链接,并提供关注官方动态及替代方案的实用建议。
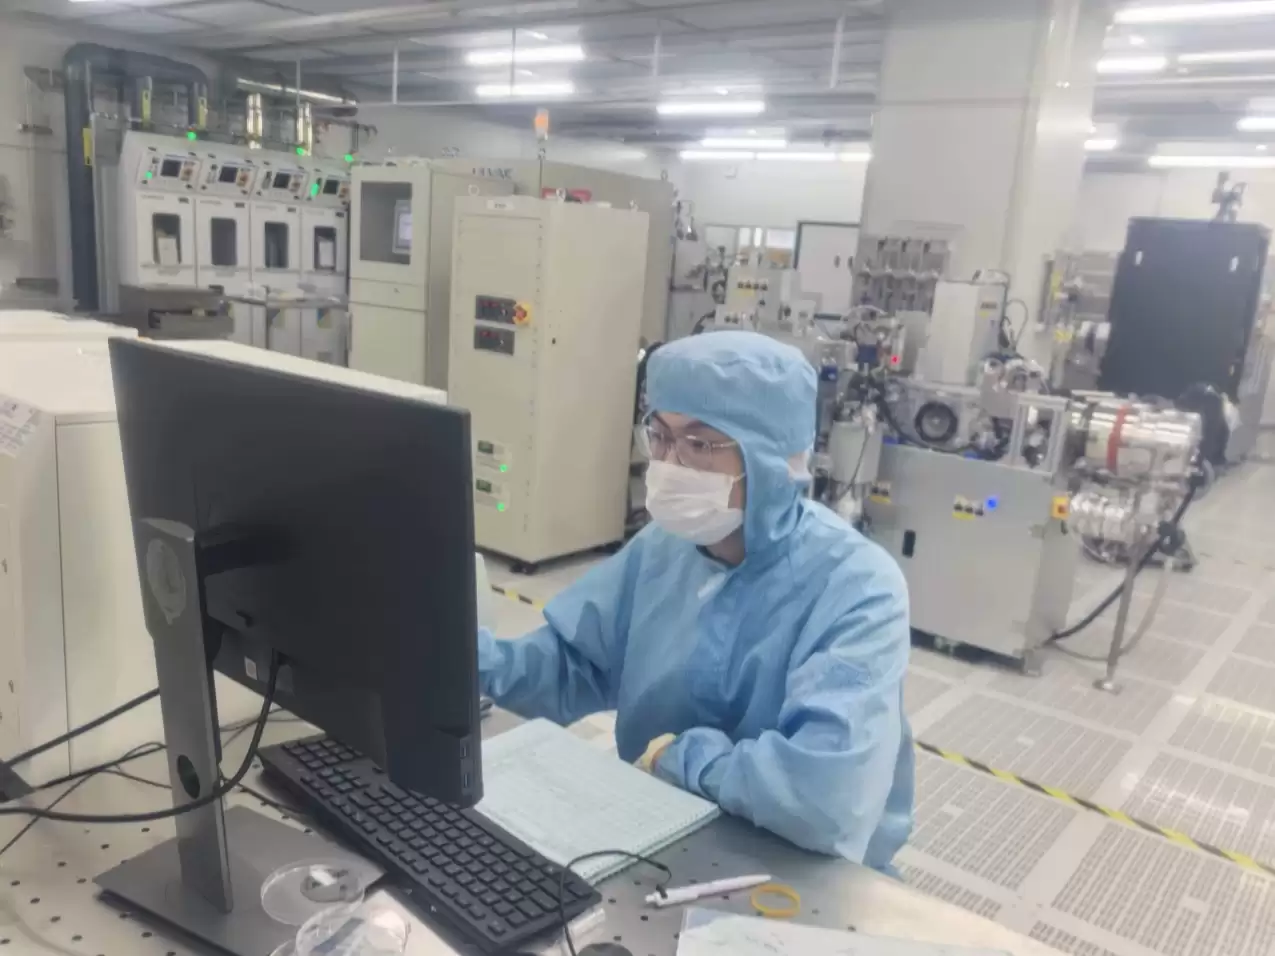
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。

苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。
一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。
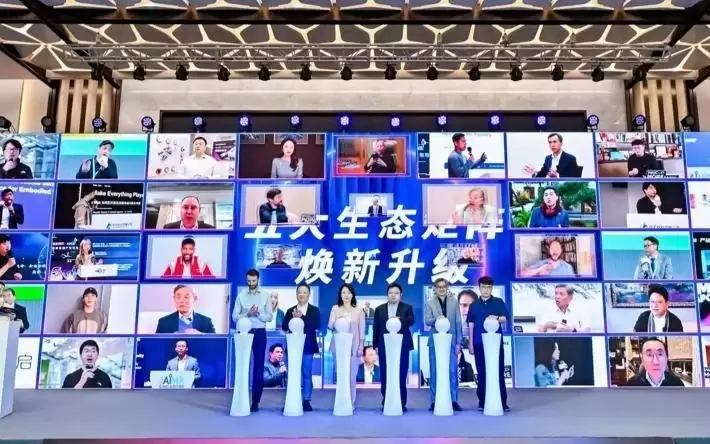
2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
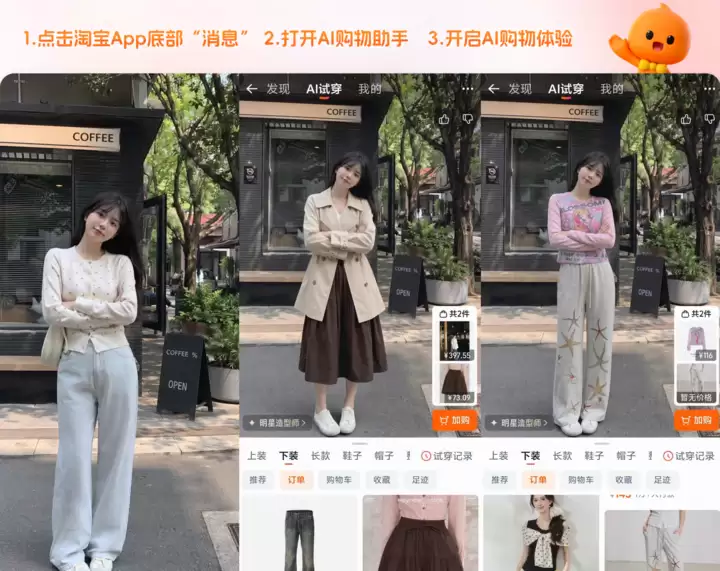
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。
商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



