

使用OpenAI的Whisper 模型进行语音识别
语音识别是人工智能中的一个领域,它允许计算机理解人类语音并将其转换为文本。该技术用于Alexa和各种聊天机器人应用程序等设备。而我们最常见的就是语音转录,语音转录可以语音转换为文字记录或字幕。wav2vec2、Conformer和Hubert等最先进模型的最新发展极大地推动了语音识别领域的发展。这些模型采用无需人工标记数据即可从原始音频中学习的技术,从而使它们能够有效地使用未标记语音的大型数据集。它们还被扩展为使用多达1,000,000小时的训练数据,远远超过学术监督数据集中使用的传统1,
语音识别是人工智能中的一个领域,它允许计算机理解人类语音并将其转换为文本。该技术用于 Alexa 和各种聊天机器人应用程序等设备。而我们最常见的就是语音转录,语音转录可以语音转换为文字记录或字幕。
wav2vec2、Conformer 和 Hubert 等最先进模型的最新发展极大地推动了语音识别领域的发展。这些模型采用无需人工标记数据即可从原始音频中学习的技术,从而使它们能够有效地使用未标记语音的大型数据集。它们还被扩展为使用多达 1,000,000 小时的训练数据,远远超过学术监督数据集中使用的传统 1,000 小时,但是以监督方式跨多个数据集和领域预训练的模型已被发现表现出更好的鲁棒性和对持有数据集的泛化,所以执行语音识别等任务仍然需要微调,这限制了它们的全部潜力 。为了解决这个问题OpenAI 开发了 Whisper,一种利用弱监督方法的模型。
本文将解释用于训练的数据集的种类以及模型的训练方法,以及如何使用Whisper
Whisper 模型介绍
使用数据集:
Whisper模型是在68万小时标记音频数据的数据集上训练的,其中包括11.7万小时96种不同语言的演讲和12.5万小时从”任意语言“到英语的翻译数据。该模型利用了互联网生成的文本,这些文本是由其他自动语音识别系统(ASR)生成而不是人类创建的。该数据集还包括一个在VoxLingua107上训练的语言检测器,这是从YouTube视频中提取的短语音片段的集合,并根据视频标题和描述的语言进行标记,并带有额外的步骤来去除误报。
模型:
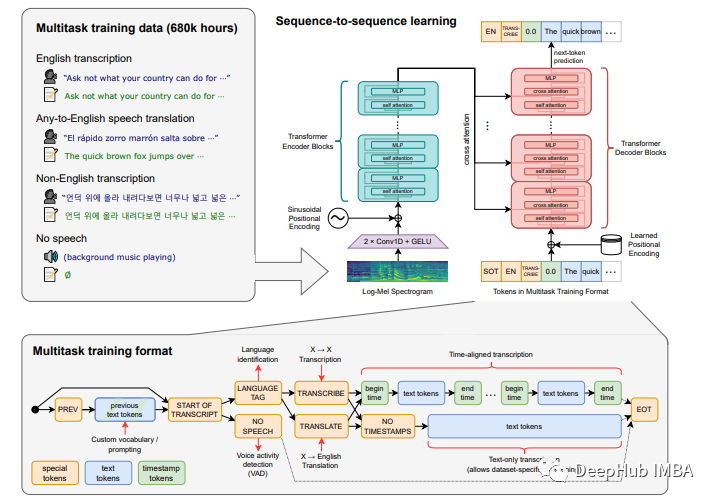
主要采用的结构是编码器-解码器结构。
重采样:16000 Hz
特征提取方法:使用25毫秒的窗口和10毫秒的步幅计算80通道的log Mel谱图表示。
特征归一化:输入在全局内缩放到-1到1之间,并且在预训练数据集上具有近似为零的平均值。
编码器/解码器:该模型的编码器和解码器采用Transformers。
编码器的过程:
编码器首先使用一个包含两个卷积层(滤波器宽度为3)的词干处理输入表示,使用GELU激活函数。
第二个卷积层的步幅为 2。
然后将正弦位置嵌入添加到词干的输出中,然后应用编码器 Transformer 块。
Transformers使用预激活残差块,编码器的输出使用归一化层进行归一化。
模型框图:
解码的过程:
在解码器中,使用了学习位置嵌入和绑定输入输出标记表示。
编码器和解码器具有相同的宽度和数量的Transformers块。
训练
为了改进模型的缩放属性,它在不同的输入大小上进行了训练。
通过 FP16、动态损失缩放,并采用数据并行来训练模型。
使用AdamW和梯度范数裁剪,在对前 2048 次更新进行预热后,线性学习率衰减为零。
使用 256 个批大小,并训练模型进行 220次更新,这相当于对数据集进行两到三次前向传递。
由于模型只训练了几个轮次,过拟合不是一个重要问题,并且没有使用数据增强或正则化技术。这反而可以依靠大型数据集内的多样性来促进泛化和鲁棒性。
Whisper 在之前使用过的数据集上展示了良好的准确性,并且已经针对其他最先进的模型进行了测试。
优点:
- Whisper 已经在真实数据以及其他模型上使用的数据以及弱监督下进行了训练。
- 模型的准确性针对人类听众进行了测试并评估其性能。
- 它能够检测清音区域并应用 NLP 技术在转录本中正确进行标点符号的输入。
- 模型是可扩展的,允许从音频信号中提取转录本,而无需将视频分成块或批次,从而降低了漏音的风险。
- 模型在各种数据集上取得了更高的准确率。
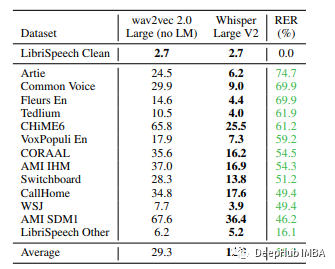
Whisper在不同数据集上的对比结果,相比wav2vec取得了目前最低的词错误率
模型没有在timit数据集上进行测试,所以为了检查它的单词错误率,我们将在这里演示如何使用Whisper来自行验证timit数据集,也就是说使用Whisper来搭建我们自己的语音识别应用。
使用Whisper 模型进行语音识别
TIMIT 阅读语音语料库是语音数据的集合,它专门用于声学语音研究以及自动语音识别系统的开发和评估。它包括来自美国英语八种主要方言的 630 位演讲者的录音,每人朗读十个语音丰富的句子。语料库包括时间对齐的拼字、语音和单词转录以及每个语音的 16 位、16kHz 语音波形文件。该语料库由麻省理工学院 (MIT)、SRI International (SRI) 和德州仪器 (TI) 共同开发。TIMIT 语料库转录已经过手工验证,并指定了测试和训练子集,以平衡语音和方言覆盖范围。
安装:
!pip install git+https://github.com/openai/whisper.git
 !pip install jiwer
 !pip install datasets==1.18.3
第一条命令将安装whisper模型所需的所有依赖项。jiwer是用来下载文字错误率包的datasets是hugface提供的数据集包,可以下载timit数据集。
导入库
import whisper
 from pytube import YouTube
 from glob import glob
 import os
 import pandas as pd
 from tqdm.notebook import tqdm
加载timit数据集
from datasets import load_dataset, load_metric

 timit = load_dataset("timit_asr")
计算不同模型尺寸下的Word错误率
考虑到过滤英语数据和非英语数据的需求,我们这里选择使用多语言模型,而不是专门为英语设计的模型。
但是TIMIT数据集是纯英文的,所以我们要应用相同的语言检测和识别过程。另外就是TIMIT数据集已经分割好训练和验证集,我们可以直接使用。
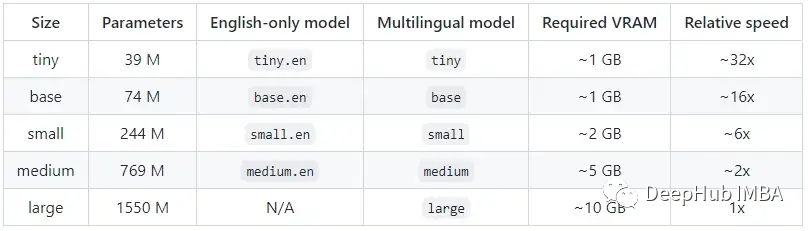
要使用Whisper,我们就要先了解不同模型的的参数,大小和速度。
加载模型
model = whisper.load_model('tiny')tiny可以替换为上面提到的模型名称。
定义语言检测器的函数
def lan_detector(audio_file):
 print('reading the audio file')
 audio = whisper.load_audio(audio_file)
 audio = whisper.pad_or_trim(audio)
 mel = whisper.log_mel_spectrogram(audio).to(model.device)
 _, probs = model.detect_language(mel)
 if max(probs, key=probs.get) == 'en':
 return True
 return False
转换语音到文本的函数
def speech2text(audio_file):
 text = model.transcribe(audio_file)
 return text["text"]
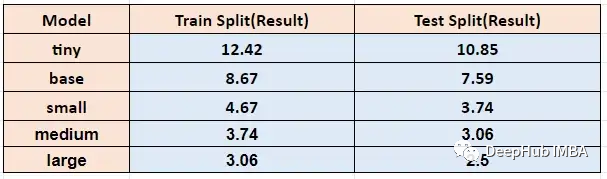
在不同模型大小下运行上面的函数,timit训练和测试得到的单词错误率如下:
从u2b上转录语音
与其他语音识别模型相比,Whisper 不仅能识别语音,还能解读一个人语音中的标点语调,并插入适当的标点符号,我们下面使用u2b的视频进行测试。
这里就需要一个包pytube,它可以轻松的帮助我们下载和提取音频
def youtube_audio(link):
 youtube_1 = YouTube(link)
 videos = youtube_1.streams.filter(only_audio=True)

 name = str(link.split('=')[-1])
 out_file = videos[0].download(name)

 link = name.split('=')[-1]
 new_filename = link+".wav"
 print(new_filename)
 os.rename(out_file, new_filename)
 print(name)
 return new_filename,link
获得wav文件后,我们就可以应用上面的函数从中提取文本。
总结
本文的代码在这里
https://drive.google.com/file/d/1FejhGseX_S1Ig_Y5nIPn1OcHN8DLFGIO/view
还有许多操作可以用Whisper完成,你可以根据本文的代码自行尝试。
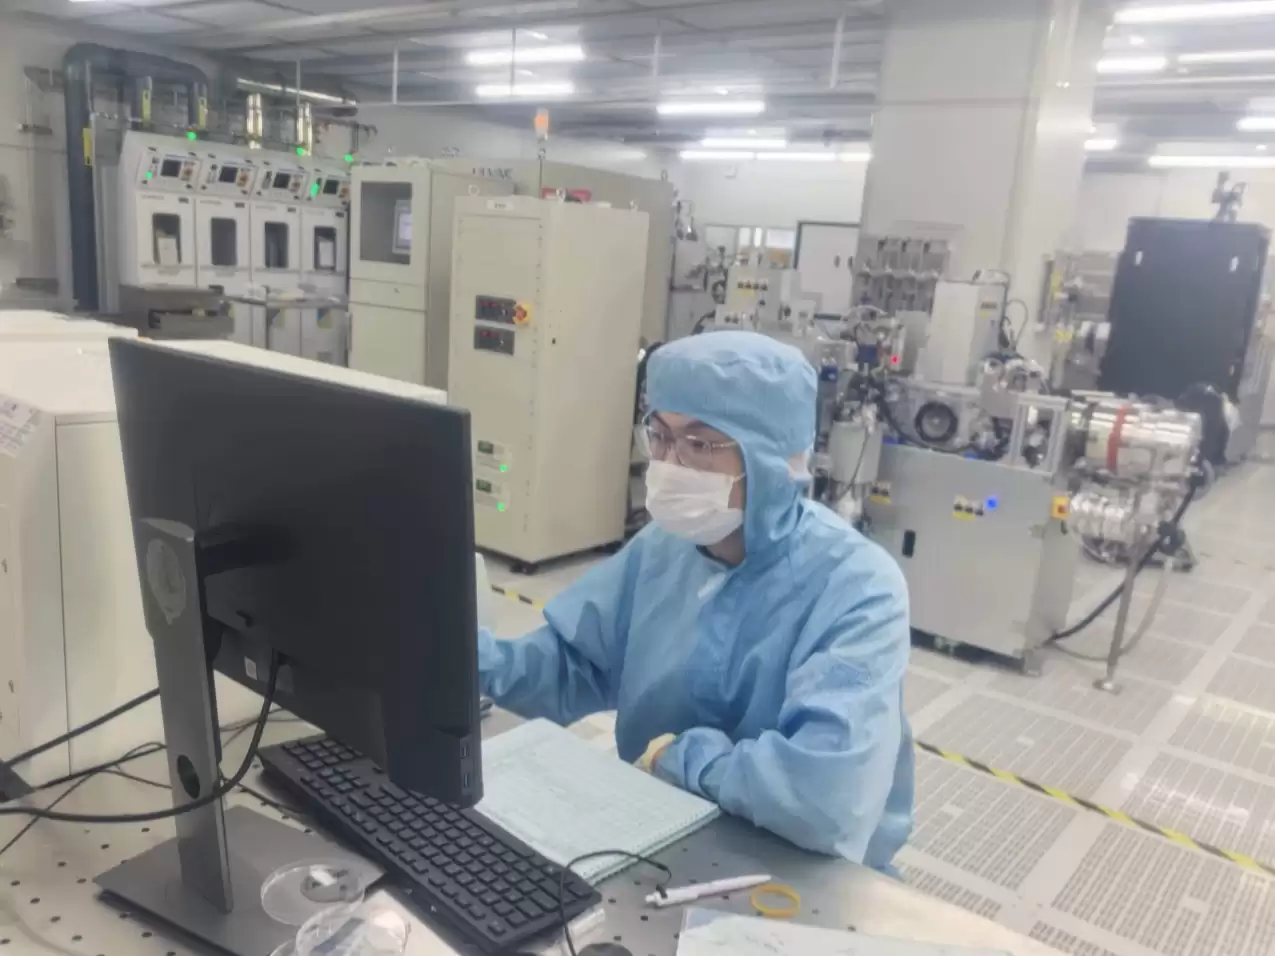
南京邮电大学“光擎智算”团队联合南京大学,攻克GaN基Micro-LED器件技术,成功搭建实验室级光计算验证系统。团队自主研发的5×5 Micro-LED光电计算阵列芯片已进入流片封装阶段,实现了图像识别等算力任务验证,推动光计算技术从理论走向工程落地。
苹果与铠侠签署为期3-5年的NAND闪存长期供应协议,且可能不设价格上限。此举旨在应对AI数据中心需求激增导致的芯片供应紧张,从单纯压价转向确保稳定供货。

一项研究揭示大语言模型在文本嵌入任务中表现平庸的根源:反嵌入矩阵边缘频谱引入高频词偏见。提出的EmbedFilter方法通过滤除该噪声,在MTEB49项任务上显著提升性能,且无需重新训练,兼容多种基线方法。

2026年世界人工智能大会将于7月17日至20日举办,超过300款人工智能新品全球首发,1400多位嘉宾参会,近140场论坛,展览面积超过10万平方米,促成意向合作金额达162亿元,并且推出首个自主举办的国际顶级人工智能学术会议。
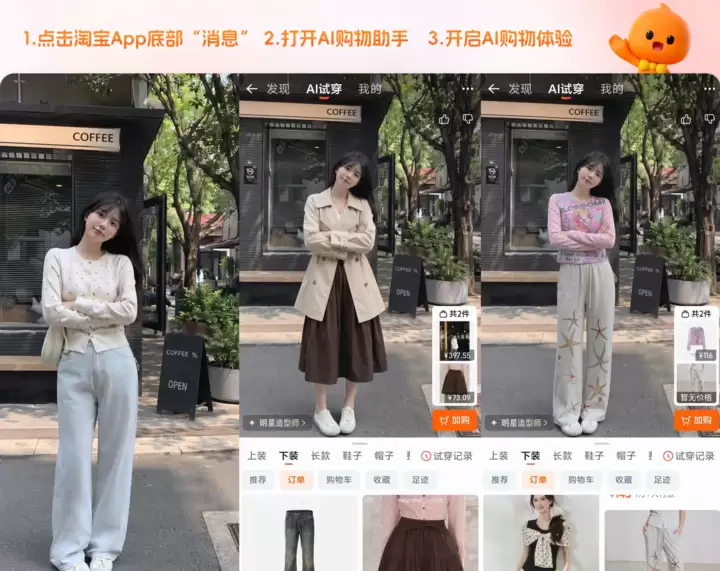
618”期间,AI全面渗透电商,超百万商家使用AI工具提升效率。政策补贴拉动绿色智能家电及汽车消费,市场回暖。供应链升级实现仓配一体化,时效大幅提升,多链协同激活内需活力。
AI生成作品虽完美却缺乏“活人感”,这一悖论贯穿艺术史。《红楼梦》中已批判套路化创作。真正活人感源于创作者内化形式美规律后的即兴发挥与平衡,而非单纯拒绝美化。能否尊重生活细节、容忍碰撞,决定作品是否鲜活,这也是艺术的根本功用。
商务部等8部门发布《关于加快“人工智能+消费”发展的实施意见》,围绕服务消费和商品消费两大领域,明确居家、养老、文旅、教育等场景的AI应用方向,推广智能家居、养老机器人等产品,并适度超前布局城市智能设施。

商汤与香港科技园合作共建国产AI算力中心,目标2030年前实现超40000P算力规模,首阶段预计今年完成。该中心配备国产GPU集群,支撑模型训练与推理,服务本地及国际客户。商汤临港AIDC已有4.04万P算力运营经验。

亚马逊正考虑将其开发的TrainiumAI芯片直接出售给其他公司,以挑战英伟达主导地位。该芯片面向需要本地化数据解决方案的国际企业,亚马逊表示不会影响AWS云业务收入,谷歌也有类似计划。
广东省印发服务业扩能提质方案,聚焦AI机遇,建设国际竞争力的软件与信息技术创新中心,包括培育核心企业、构建AI服务体系、攻关核心技术、建设开源生态,并部署融资租赁、金融合作、算力网络、6G及智能应用。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
