

多篇论文入选Interspeech 2023,火山语音有效解决多类实践问题
日前,火山语音团队多篇论文入选Interspeech2023,内容涵盖短视频语音识别、跨语言音色与风格以及口语流利度评估等多个应用方向的创新突破。Interspeech作为国际语音通信协会ISCA组织的语音研究领域的顶级会议之一,也被称为全球最大的综合性语音信号处理盛会,受到全球语言领域人士的广泛关注。Interspeech2023活动现场基于随机语句串联的数据增强改进短视频语音识别(RandomUtteranceConcatenationBasedDataAugmentationforImproving
日前,火山语音团队多篇论文入选Interspeech 2023,内容涵盖短视频语音识别、跨语言音色与风格以及口语流利度评估等多个应用方向的创新突破。Interspeech作为国际语音通信协会ISCA组织的语音研究领域的顶级会议之一,也被称为全球最大的综合性语音信号处理盛会,受到全球语言领域人士的广泛关注。
Interspeech2023活动现场
基于随机语句串联的数据增强改进短视频语音识别(Random Utterance Concatenation Based Data Augmentation for Improving Short-video Speech Recognition)
一般来说,端到端自动语音识别(ASR)框架的限制之一,就是如果训练和测试语句的长度不匹配,其性能可能会受到影响。在该论文中,火山语音团队提出了一种基于即时随机语句串联(RUC)的数据增强方法作为前端数据增强,以减轻短视频ASR任务中训练和测试语句长度不匹配的问题。
具体来说,团队发现以下观察结果对创新实践起到了主要作用:通常情况下,短视频自发语音的训练语句比人工转录的语句要短得多(平均约3秒),而从语音活动检测前端生成的测试语句要长得多(平均约10秒)。因此,这种不匹配可能会导致性能不佳
火山语音团队表示,为了进行实证,我们使用了来自15种语言的多类ASR模型。这些语言的数据集范围从1,000小时到30,000小时不等。在模型微调阶段,我们还即时加入了采样多条数据后并拼接的数据。相比于没有增强过的数据,这种方法在所有语言上平均达到了5.72%的相对词错误率降低
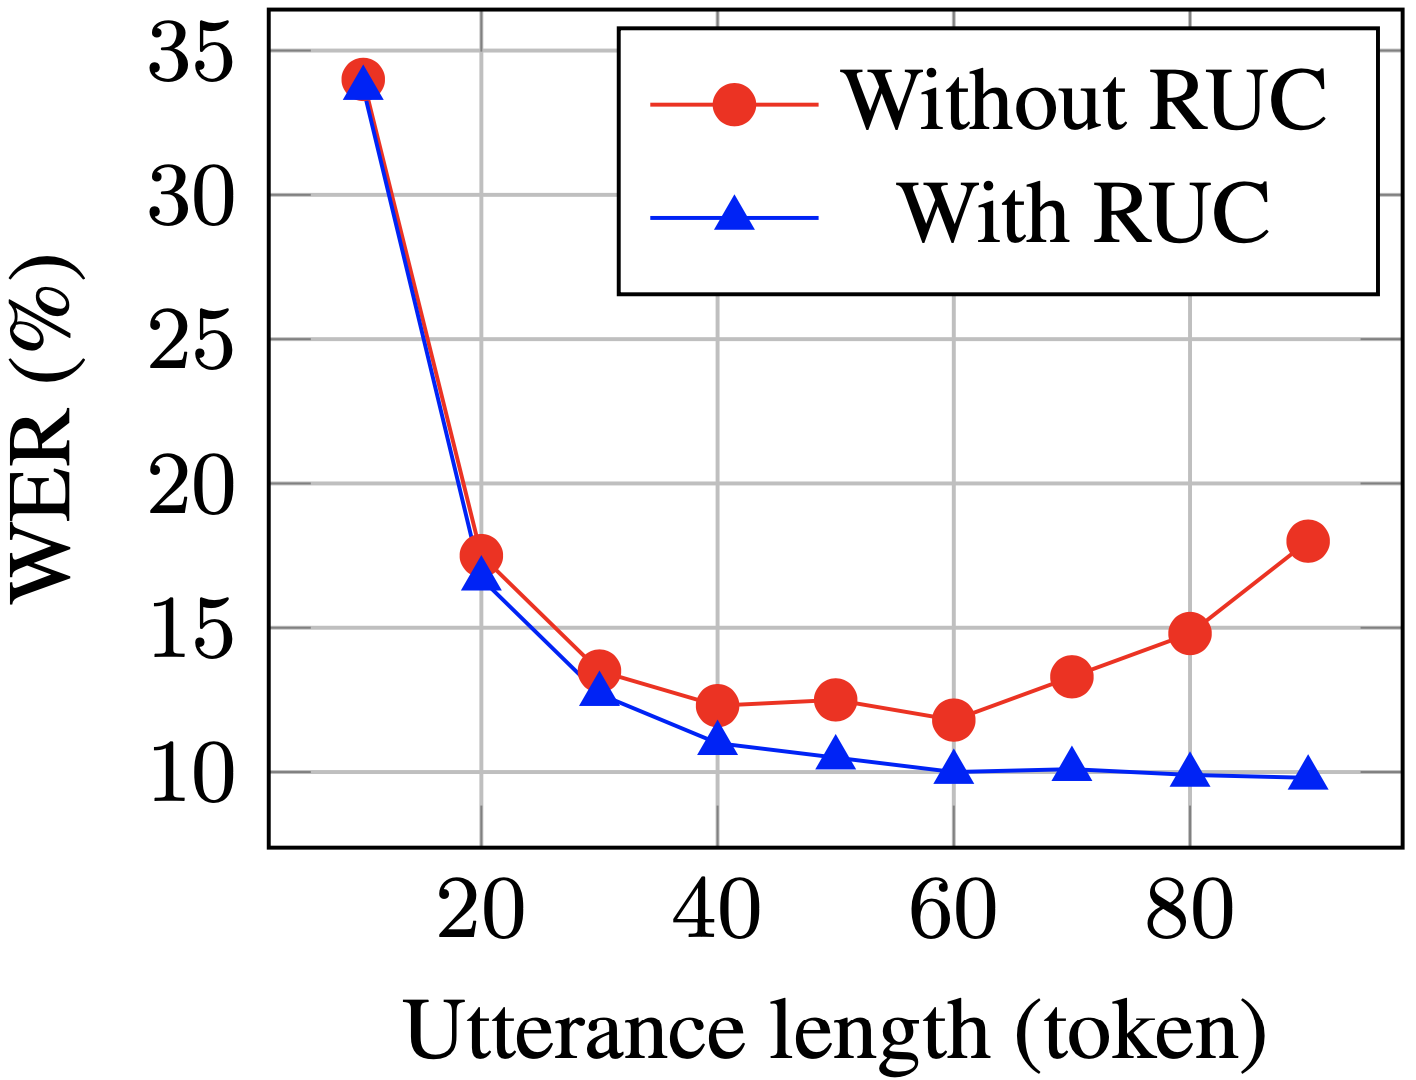
测试集上长句的 WER 通过 RUC 训练过后显著下降(蓝色 vs. 红色)
根据实验观察,RUC方法明显改善了长句的识别能力,而短句的性能没有下降。进一步分析发现,所提出的数据增强方法可以减少ASR模型对长度归一化变化的敏感性,这可能意味着ASR模型在多样环境下更具鲁棒性。综上所述,RUC数据增强方法虽然操作简单,但效果显著
基于语音和韵律自监督方法的流利度打分(Phonetic and Prosody-aware Self-supervised Learning Approach for Non-native Fluency Scoring)
评价二语学习者语言能力的重要维度之一是口语的流利程度。流利的发音主要表现在说话时没有太多停顿、犹豫或自我纠正等异常现象,而是能够轻松、正常地发出语音。相比母语者,大多数二语学习者通常会说得较慢,并且会更频繁地停顿。为了评估口语流利度,火山语音团队提出了一种基于语音和韵律相关的自监督建模方法
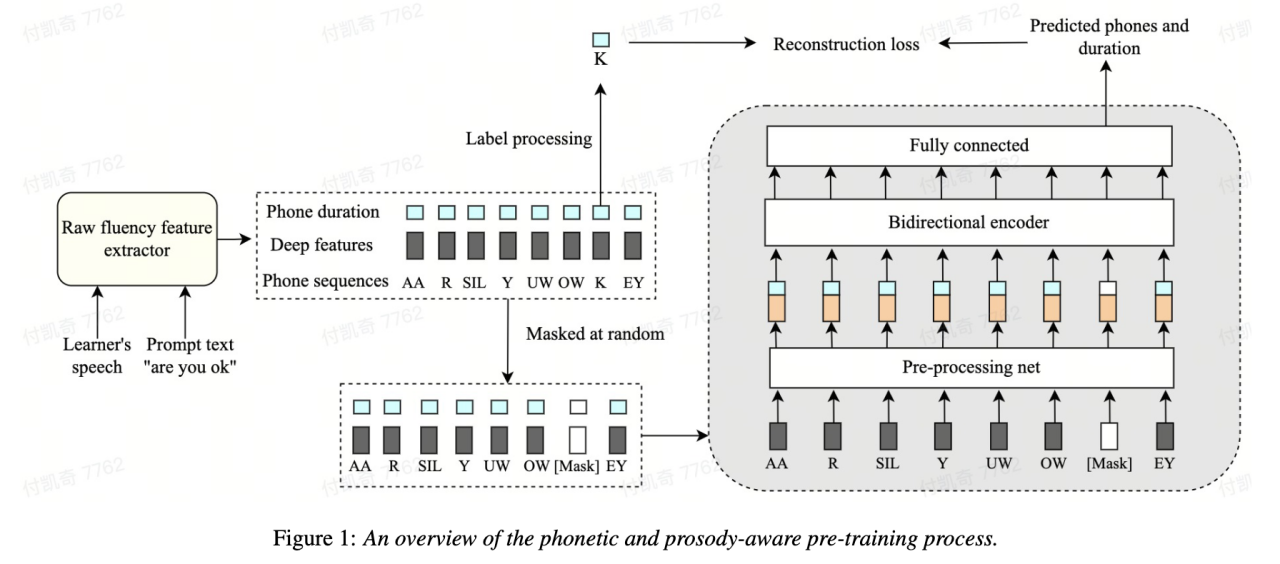
具体来说,在预训练阶段,需要对模型的输入序列特征(声学特征、音素id、音素时长)进行掩码,将掩码后的特征送入模型,利用上下文相关的编码器根据时序信息来还原掩码部分的音素id和音素时长信息,从而模型具有更强大的语音和韵律表征能力。该方案将序列建模框架中原始时长、音素和声学信息这三种特征进行掩码重构,让机器自动去学习上下文的语音和时长表征,更好用于流利度打分。
这种基于语音和韵律的自监督学习方法超过了领域内其他方法,在内部测试集上机器预测结果和人类专家打分之间相关性达到了0.833,与专家和专家之间的相关性 0.831持平。在开源数据集上,机器预测结果和人类专家打分之间相关性达到了0.835,性能超越过去在该任务上提出的一些自监督方法。应用场景方面,该方法可被应用于有流利度自动评估的需求场景中,例如口语考试以及各种在线口语练习等。
解耦非母语语音在发音评估中的贡献(Disentangling the Contribution of Non-native Speech in Automated Pronunciation Assessment)
非母语发音评估的一个基本思想就是量化学习者发音与母语者发音的偏差,因此早期用于发音评测的声学模型通常仅仅使用目的语的数据进行训练,但最近的一些研究开始将非母语语音数据纳入模型训练。将非母语语音纳入二语ASR 与非母语评估或发音错误检测中的目的存在根本区别:前者的目标是尽可能使模型适应非母语数据以达到最优 ASR 性能;后者则需要平衡两个看似相悖的需求,即在非母语语音的较高识别精度以及对非母语发音的发音水平实现客观的评估。
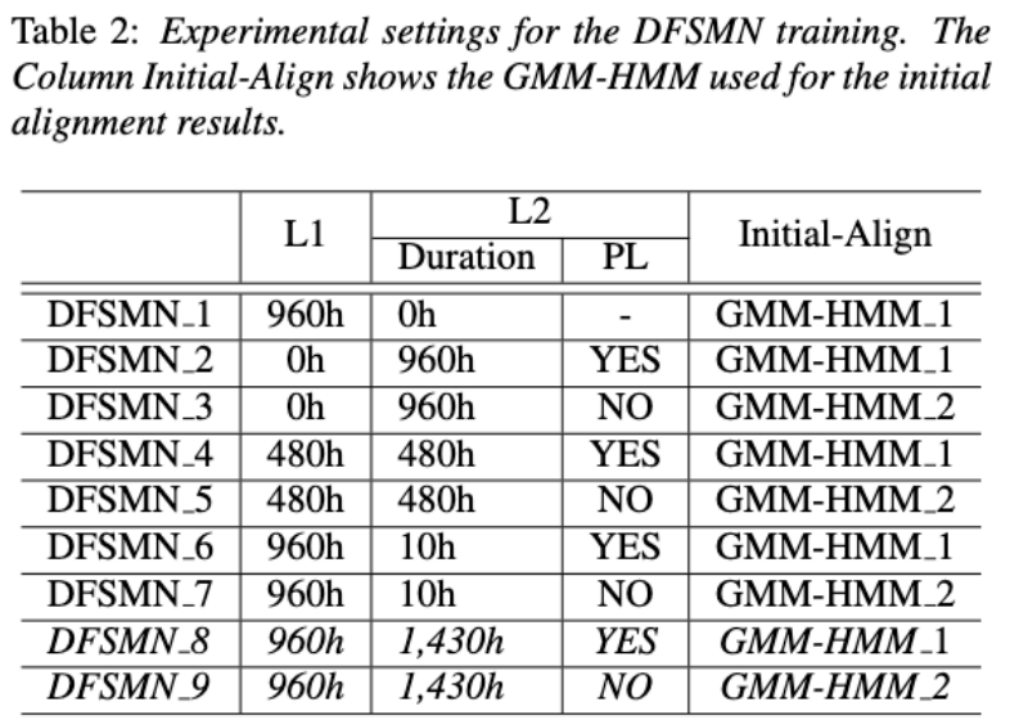
火山语音团队旨在从两个不同的角度,即对齐精度和评估表现,研究非母语语音在发音评估中的贡献。为此,他们设计了不同的数据组合和训练声学模型时的文本转录形式,如上图所示
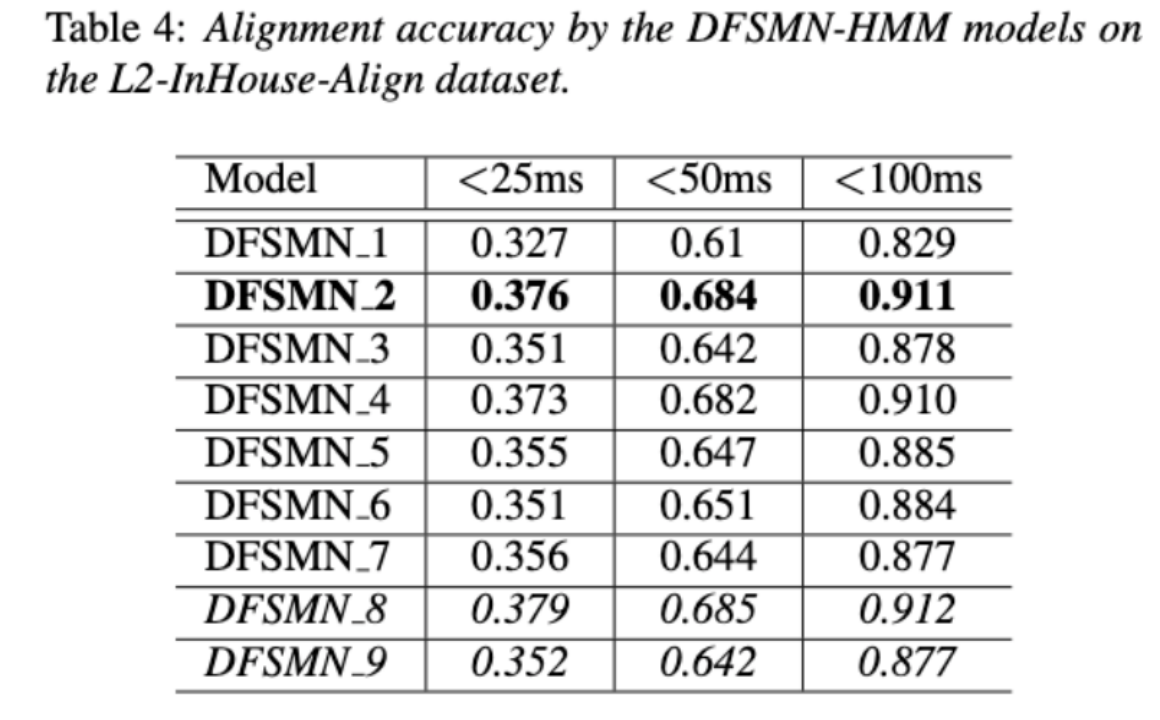
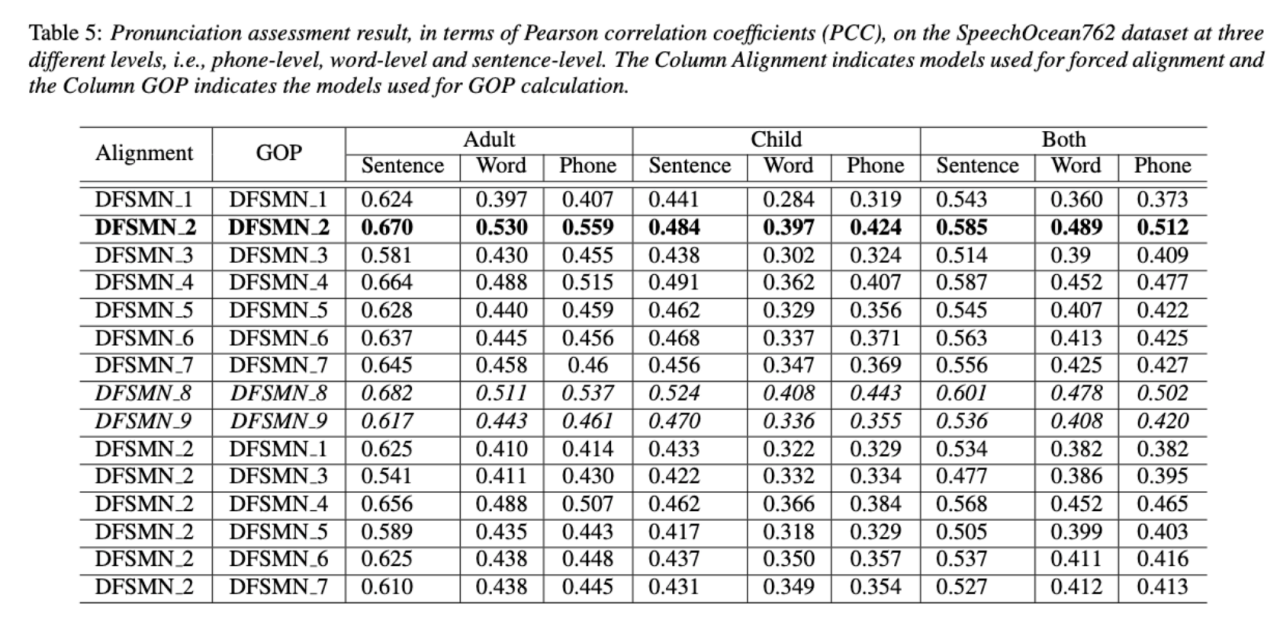
上述两个表格分别展现了不同组合的声学模型在对齐精度和评估中的性能。实验结果表明,在声学模型训练期间仅使用带有人工标注的音素序列的非母语数据,可以实现非母语语音的对齐以及发音评估的最高准确度。具体来说,在训练中将一半母语数据和一半非母语数据(人工标注的音素序列)混合可能会稍差,但可以媲美仅使用非母语数据与人工标注的音素序列。
此外,在对母语数据进行发音评估时,上述混合情况表现更出色。在资源有限的情况下,与仅使用母语数据进行声学模型训练相比,无论使用哪种文本转录类型,添加10小时的非母语数据都能显著提高对齐准确性和评估性能。这项研究对于语音评估领域的数据应用具有重要的指导意义
在端到端语音识别通过非尖峰的CTC优化帧分类器解决时间戳问题(Improving Frame-level Classifier for Word Timings with Non-peaky CTC in End-to-End Automatic Speech Recognition)
自动语音识别(ASR)领域的端到端系统已经展示出与混合系统相媲美的性能。作为ASR的附带产物,时间戳在许多应用中都是至关重要的,特别在字幕生成和计算辅助发音训练等场景,本论文旨在优化端到端系统中的帧级分类器来获取时间戳。对此团队引入使用CTC(connectionist temporal classification)损失来训练帧级分类器,并且引入标签先验的信息使得CTC的尖峰现象有所缓解,还将梅尔滤波器与ASR编码器的输出相结合,作为输入特征。
在内部的中文实验上,该方法在单词时间戳200ms准确性上达到了95.68%/94.18%,而传统混合系统仅为93.0%/90.22%。此外,相对于之前的端到端方法,团队在内部的7种语言上取得了4.80%/8.02%的绝对性能提升。通过逐帧的知识蒸馏方法,还进一步提高了单词定时的准确性,尽管此实验仅针对LibriSpeech进行。
这项研究结果表明,端到端语音识别系统中的时间戳性能可以通过引入标签先验和融合不同级别的特征进行有效优化。在内部中文实验上,该方法相较于混合系统和之前的端到端方法,都取得了显著的改进;此外对于多种语言,方法也展现出了明显的优势;通过知识蒸馏方法的应用进一步提高了单词定时的准确性。这些结果不仅对字幕生成和发音训练等应用具有重要意义,还为自动语音识别技术的发展提供了有益的探索方向。
基于语种区分声学边界学习的中英混语音识别(Language-specific Acoustic Boundary Learning for Mandarin-English Code-switching Speech Recognition )
重写后的内容:众所周知,代码切换(CS)的主要目标是促进不同语言或技术领域之间的有效交流。CS需要在一个句子中交替使用两种或多种语言,然而,合并来自多种语言的单词或短语可能会导致语音识别的错误和混淆,这使得代码切换语音识别(CSSR)成为一项更具挑战性的任务
通常的端到端ASR模型由编码器、解码器和对齐机制组成。现有的端到端CSASR模型大多只关注于优化编码器和解码器结构,很少讨论是否需要对对齐机制进行语种相关的设计。大部分已有的工作都是针对中英混合场景使用普通话字符和英语子词的混合作为建模单元。普通话字符通常表示普通话中的单个音节,并且具有清晰的声学边界;而英文子词是在不参考任何声学知识的情况下获得的,因此它们的声学边界可能是模糊的。为了在CSASR系统中获得普通话和英语的良好声学边界(对齐),进行语种相关的声学边界学习是非常必要的。因此,我们在CIF模型的基础上进行了改进,提出了一种语种区分的声学边界学习方法,用于CSASR任务。模型架构的详细信息请见下图
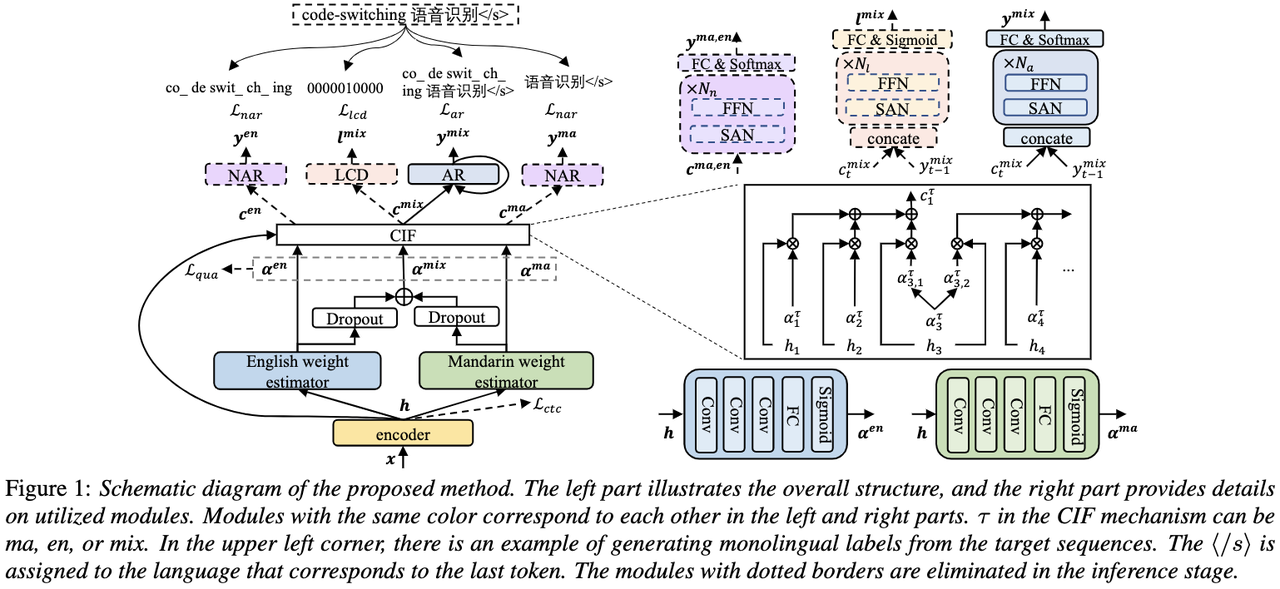
该模型由六个组件组成,分别是编码器、语种区分的权重估计器(LSWE)、CIF模块、自回归(AR)解码器、非自回归(NAR)解码器和语种变化检测(LCD)模块。编码器和自回归解码器以及CIF的计算过程与原始的CIF-based的ASR方法无异,语种区分的权重估计器负责完成语种独立的声学边界的建模,非自回归(NAR)解码器和语种变化检测(LCD)模块都是设计来辅助模型的训练,在解码阶段不再保留
实验结果显示,该方法在开源中英混数据集SEAME的两个测试集 和
 上获得了新的SOTA效果,分别是16.29%和22.81%的MER。为了进一步验证该方法在更大数据量中的效果,团队在9000小时的内部数据集上进行了实验,最终也是获得了相对7.9%的MER收益。据了解,本论文也是第一篇在CSASR任务中进行语种区分的声学边界学习的工作内容。
USTR:基于统一的表征和纯文本进行 ASR 领域适应(Text-only Domain Adaptation using Unified Speech-Text Representation in Transducer)
众所周知,领域迁移一直是ASR中十分重要的任务,但在目标领域获取成对的语音数据非常耗时且成本很高,因此其中很多工作都是利用目标领域相关文本数据来提升识别效果。传统方法中,TTS 会增加训练的周期和相关数据的存储成本,ILME和Shallow fusion等方法会增加推理时的复杂度。
基于该任务,团队在 RNN-T的基础上,将Encoder拆分成Audio Encoder和Shared Encoder,同时引入Text Encoder用于学习和语音信号类似的表征;语音和文本的表征则通过Shared Encoder,使用RNN-T loss进行训练,被称为 USTR(Unified Speech-Text Representation)。“对于Text Encoder这部分,我们探究了不同类型的表征形式,包括Character序列,Phone序列和Sub-word 序列,最终结果表明Phone序列的效果最好。对于训练方式,本文探究了基于给定RNN-T模型的Multi-step训练方式和完全随机初始化的Single-step训练方式。”
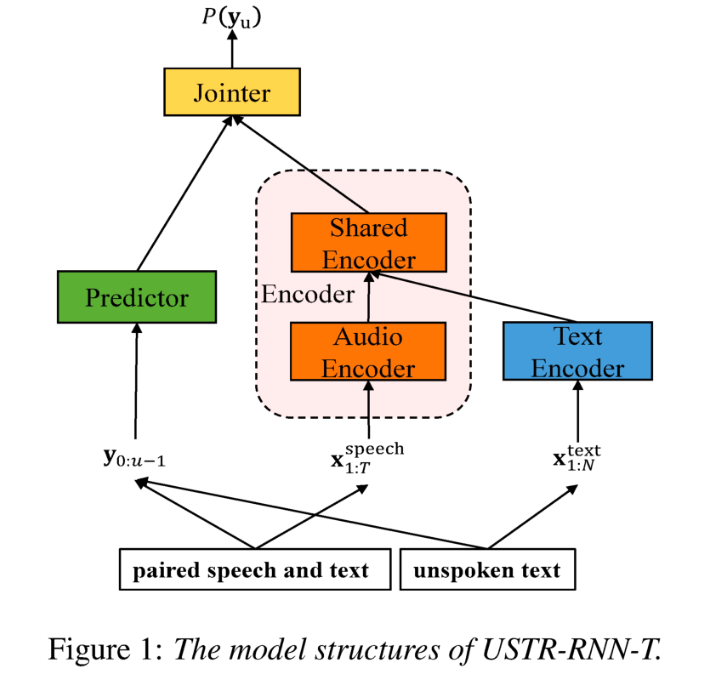
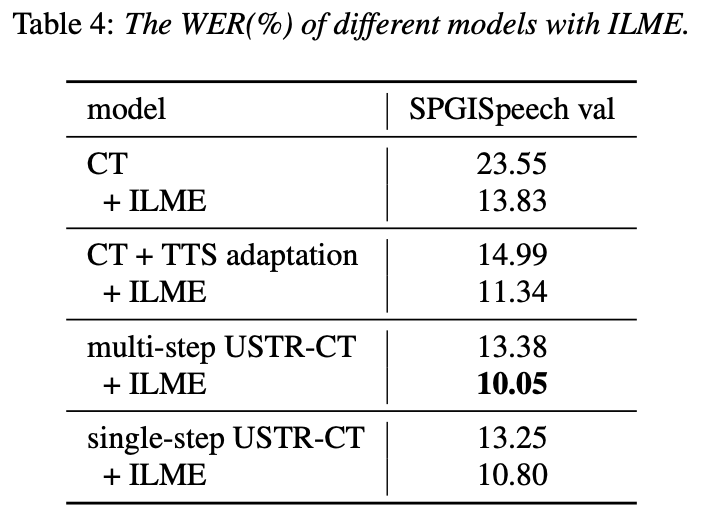
具体来说,团队使用LibriSpeech数据集作为Source domain,并利用 SPGISpeech 的标注文本作为纯文本进行领域迁移实验。实验结果表明,该方法在目标领域的效果提升可以和 TTS 基本持平;Single-step训练效果更高,效果和 Multi-step基本持平;同时还发现USTR方法可以和ILME这种外挂语言模型的方法进一步结合,即便LM使用的是相同的文本训练语料。最终,在目标领域测试集上,不结合外部语言模型,本方法相对基线 WER 23.55% -> 13.25%,相对下降 43.7%。
基于知识蒸馏的高效内部语言模型估计方法 (Knowledge Distillation Approach for Efficient Internal Language Model Estimation)
尽管内部语言模型估计(ILME)已经证明其在端到端ASR语言模型融合中的有效性,但是与传统的Shallow fusion相比,ILME额外引入了内部语言模型的计算,增加了推理成本。为了估计内部语言模型,需要基于ASR解码器上做一次额外的前向计算,或者基于密度比率(Density Ratio)方法,用ASR训练集文本训练一个独立的语言模型(DR-LM),作为内部语言模型的近似。基于ASR解码器的ILME方法,由于直接利用ASR参数进行估计,通常可以取得优于密度比率方法的性能,但其计算量取决于ASR解码器的参数量;密度比率方法的优势则在于可以通过控制DR-LM的大小实现高效的内部语言模型估计。
为此火山语音团队提出在密度比率方法的框架下,用基于ASR解码器的ILME方法作为教师,蒸馏学习DR-LM,从而在保持ILME性能的同时,大幅降低ILME的计算成本。
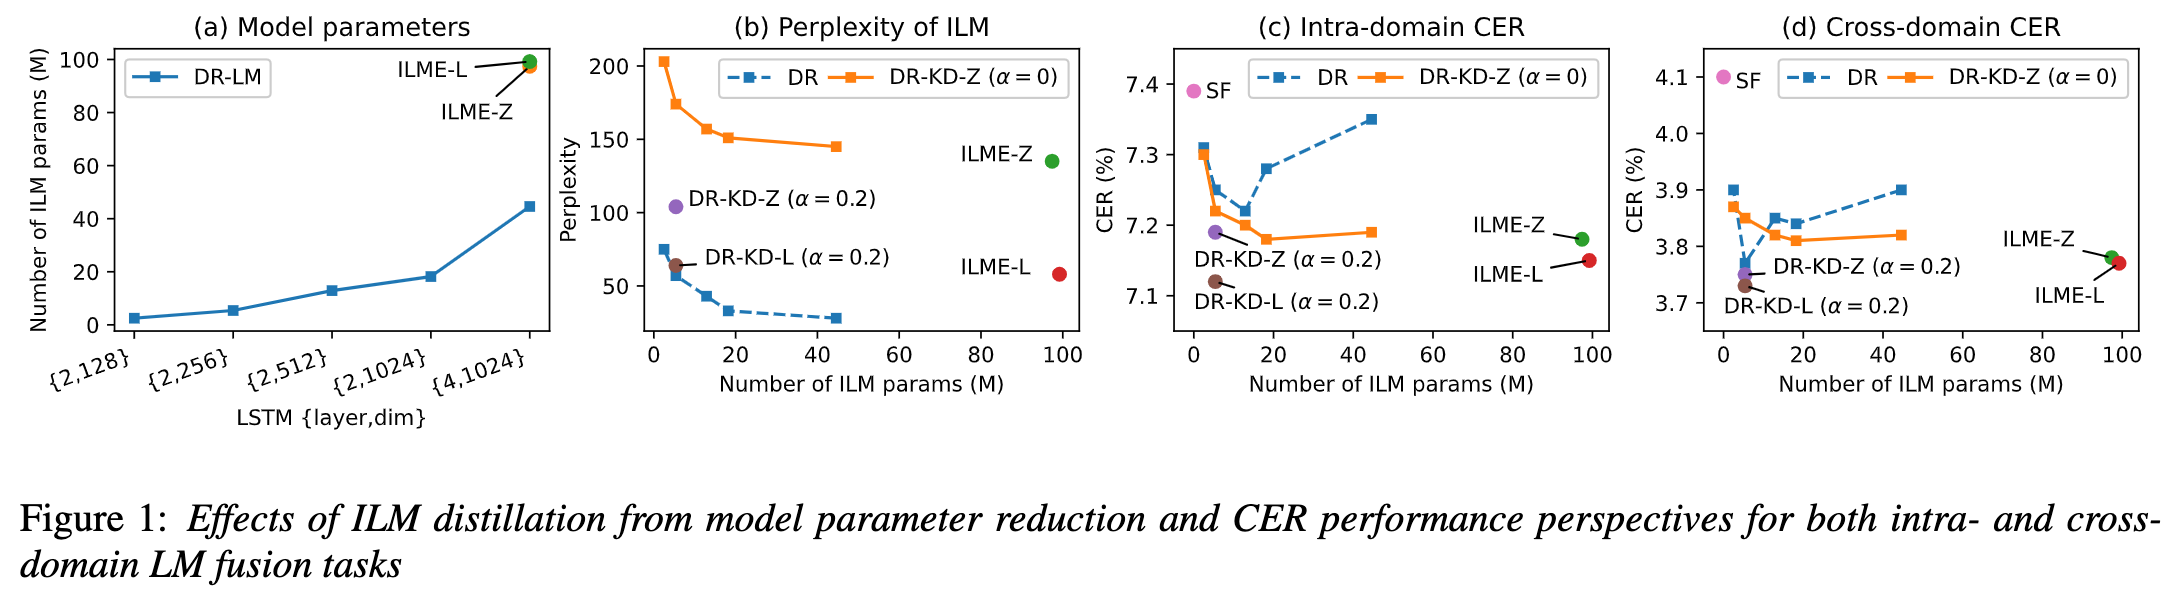
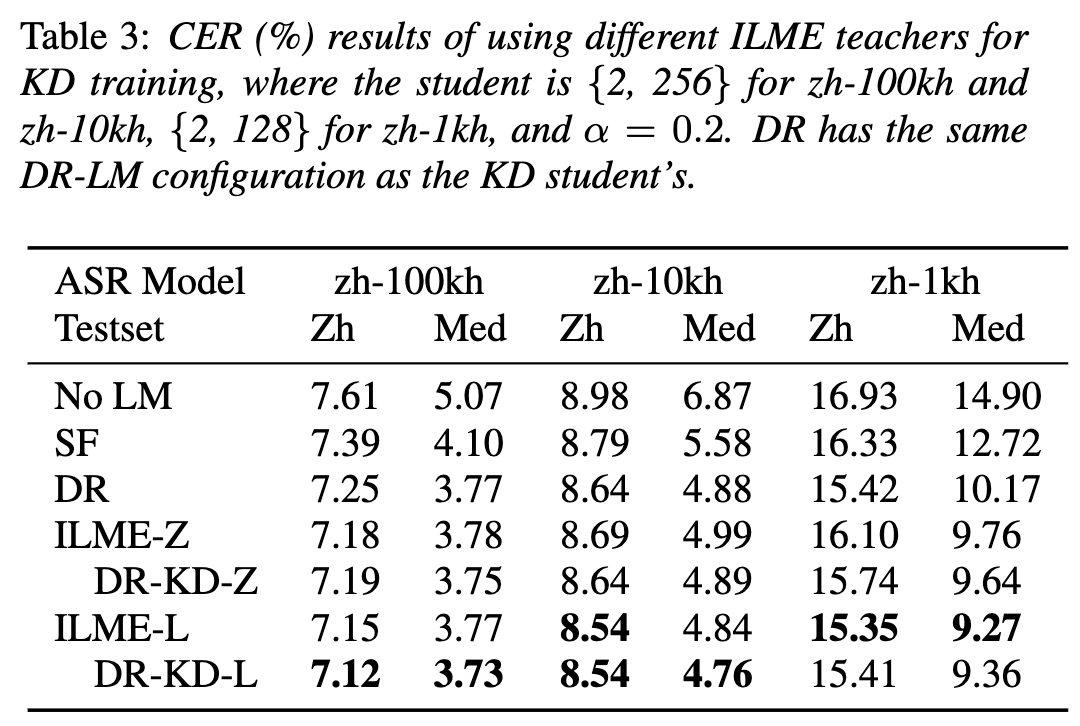
实验结果显示,这种方法可以减少95%的内部语言模型参数,并且在性能上与基于ASR解码器的ILME方法相当。当采用性能更好的ILME方法作为教师时,相应的学生模型也能够取得更好的效果。与计算量相当的传统密度比率方法相比,在高资源场景下,这种方法的性能稍优,在低资源跨领域迁移场景下,CER收益可达8%,并且对于融合权重更加鲁棒
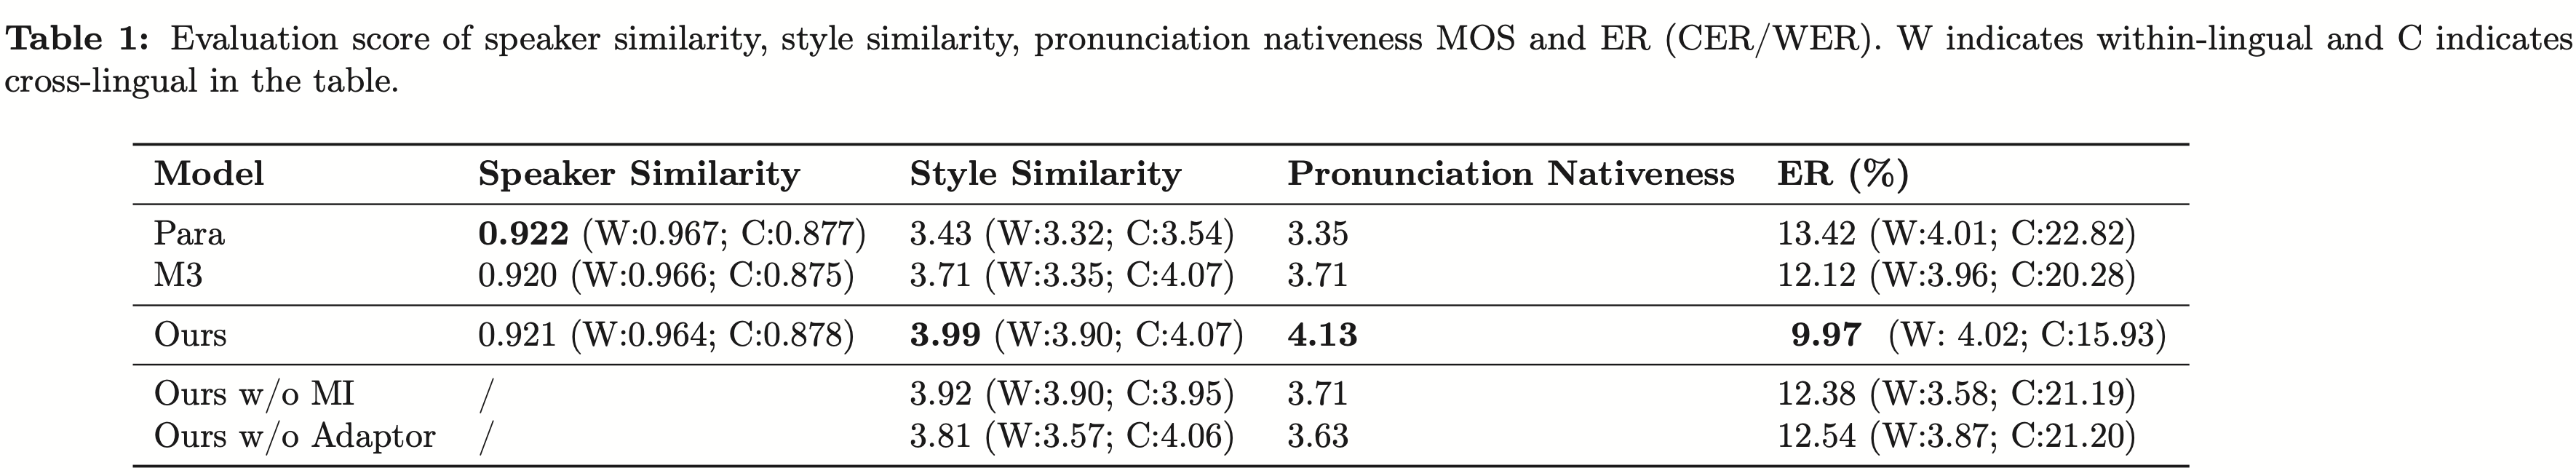
GenerTTS:跨语言语音合成中音色和风格与发音解耦和泛化(GenerTTS: Pronunciation Disentanglement for Timbre and Style Generalization in Cross-Lingual Text-to-Speech)
跨语言音色和风格可泛化的语音合成(TTS)旨在合成具有特定参考音色或风格的语音,该音色或风格并未在目标语言中进行过训练。它面临着这样的挑战,例如音色和发音之间难以分离,因为通常很难获取特定说话人的多语言语音数据;风格和发音混合在一起,因为语音风格包含语言无关和语言相关两部分。
为了应对这些挑战,火山语音团队提出了GenerTTS。他们仔细设计了基于HuBERT的信息瓶颈,以解除音色和发音/风格之间的联系。同时,他们还通过最小化风格和语言之间的互信息来消除风格中的语言特定信息
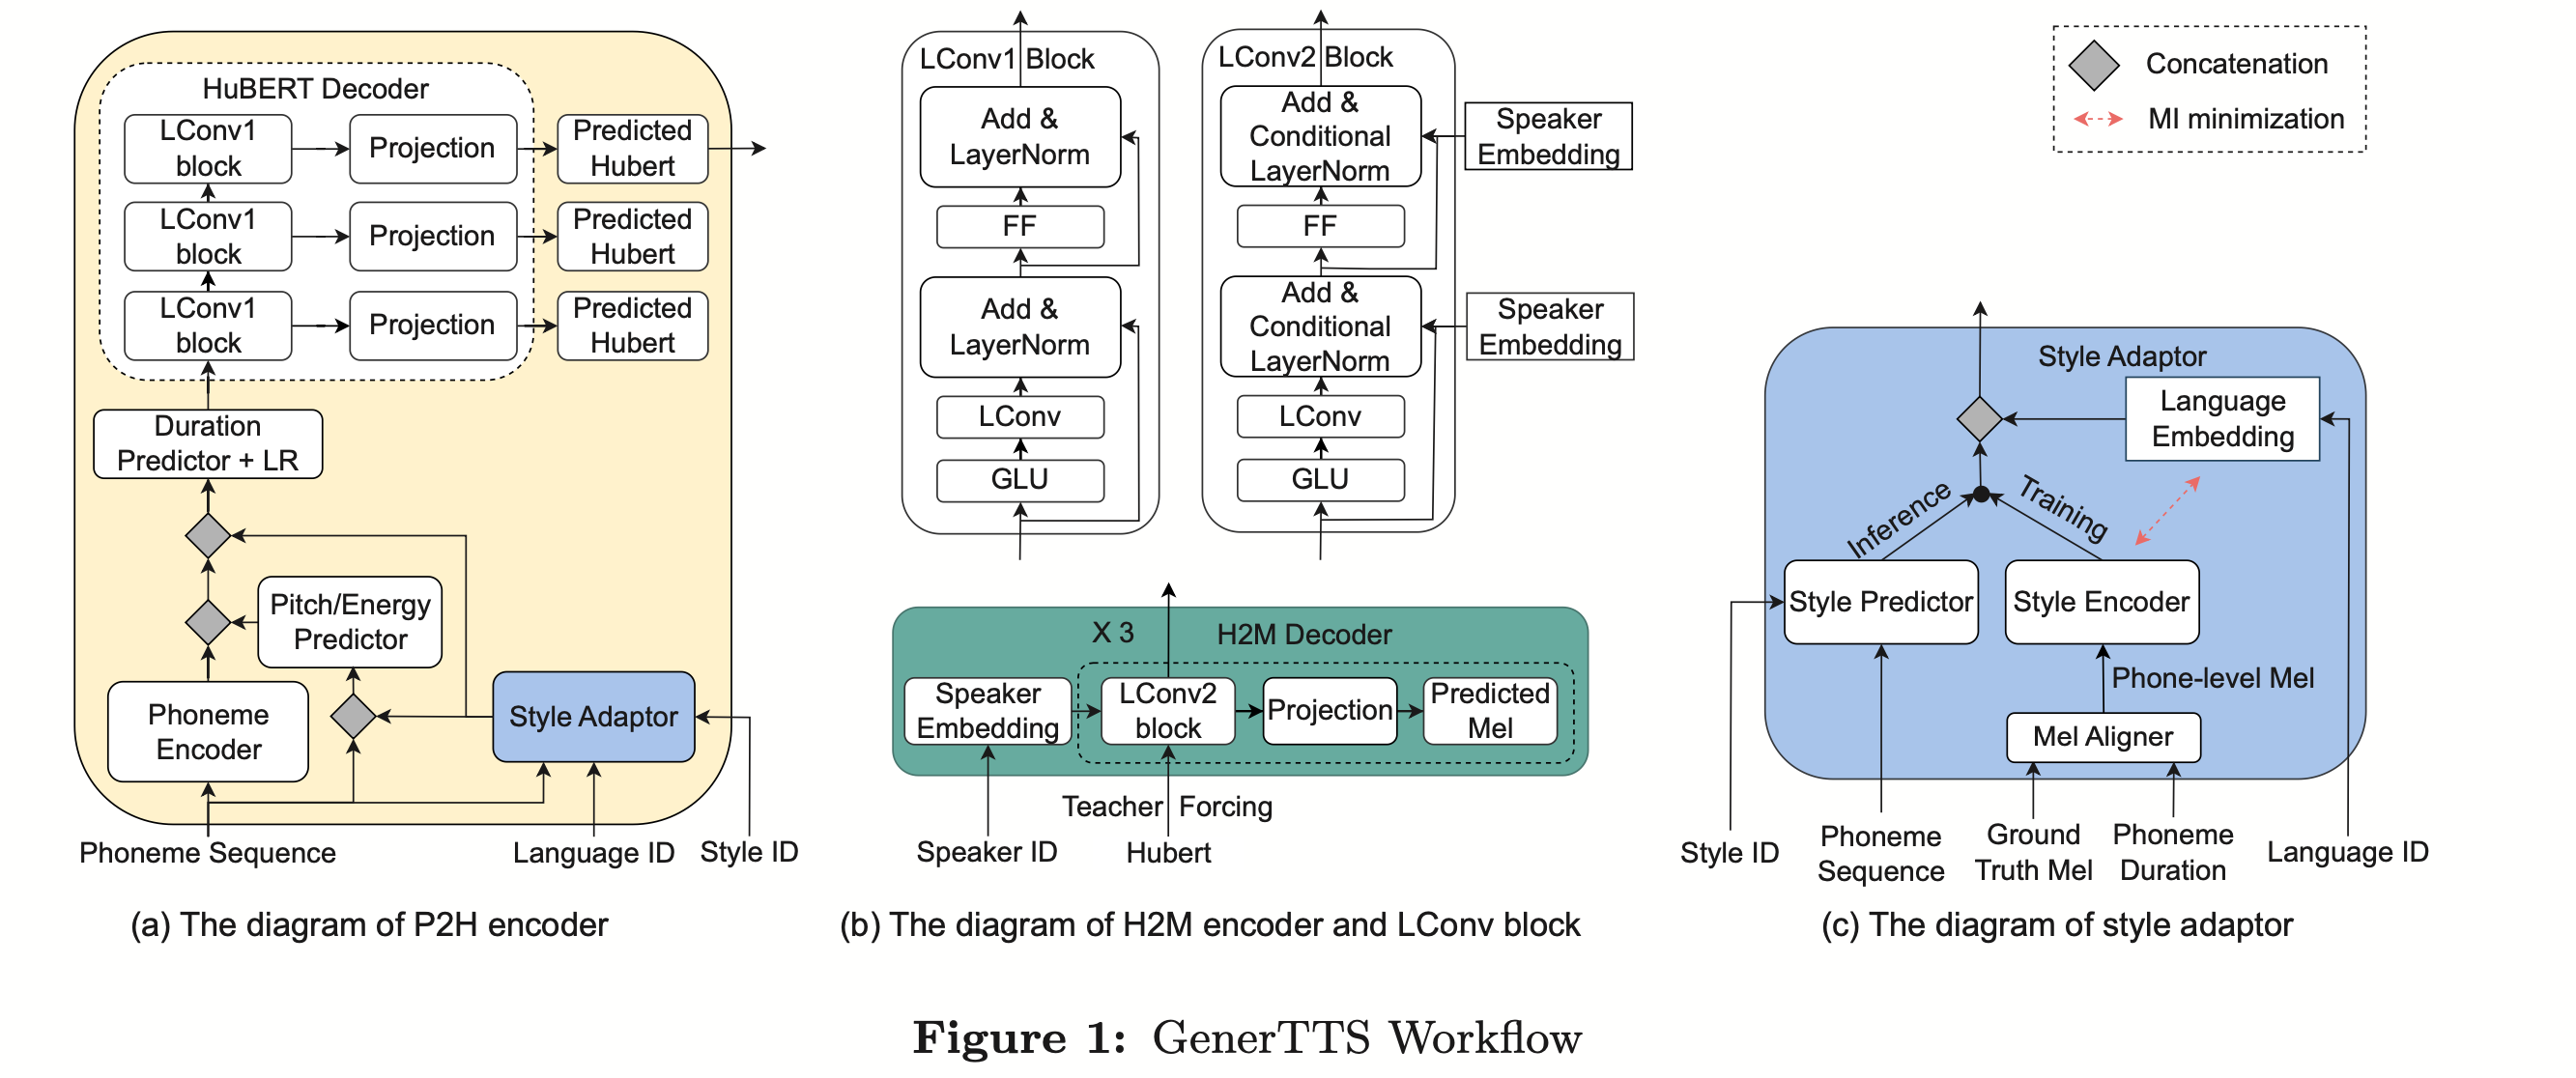
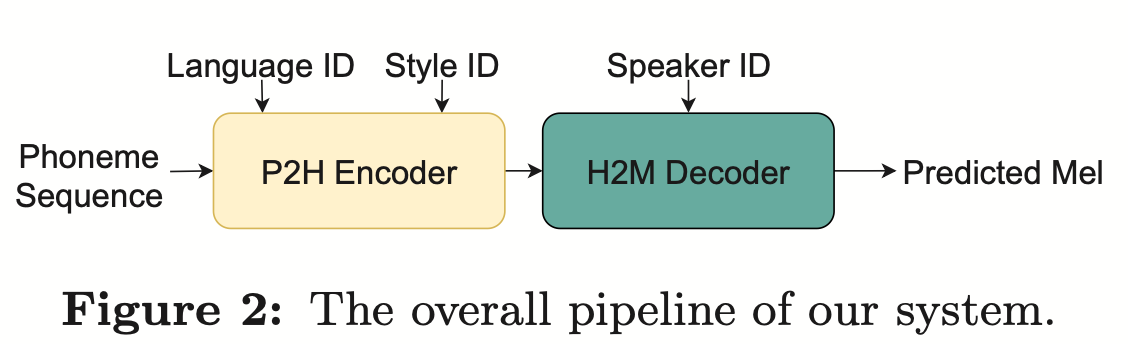
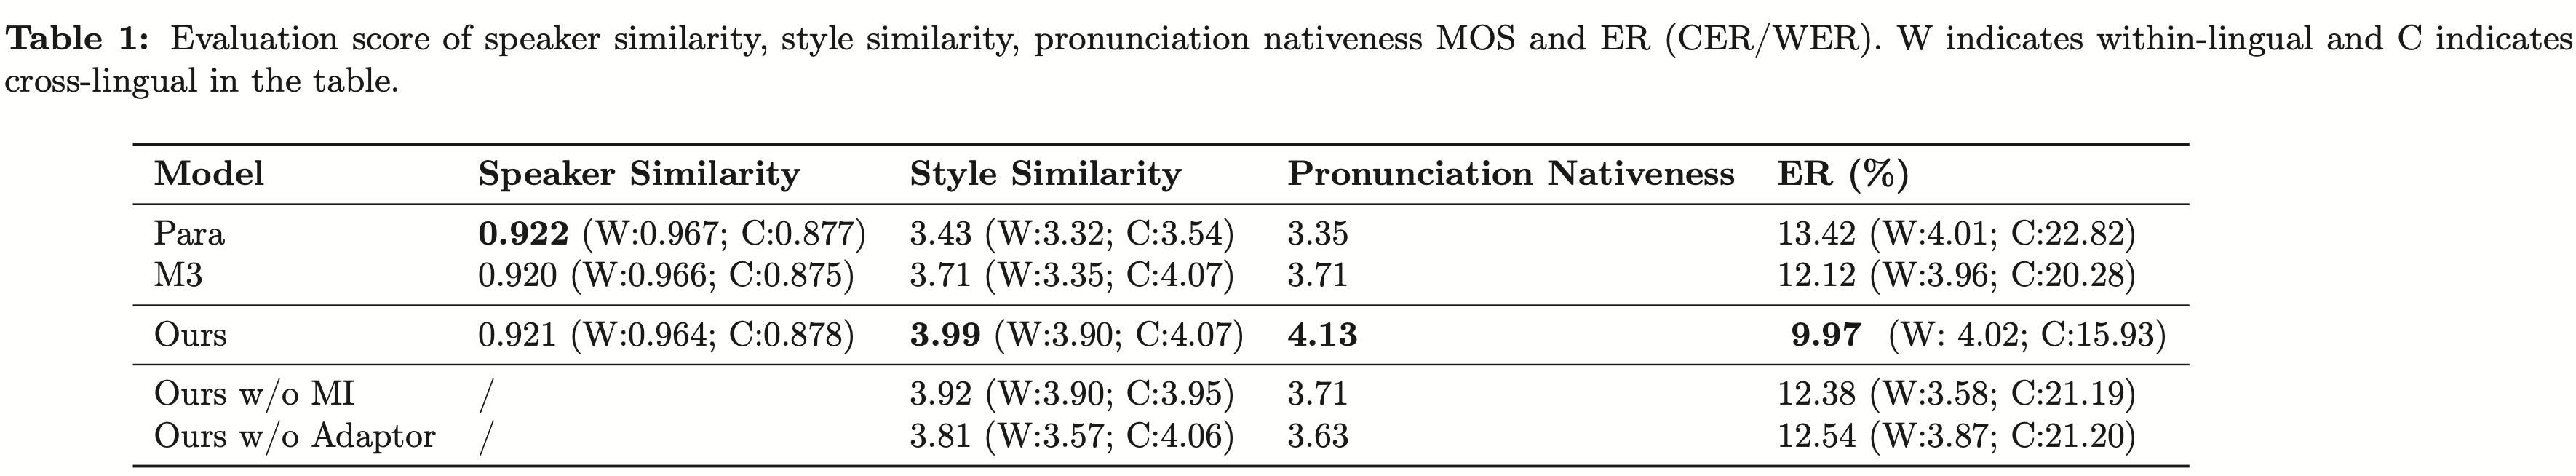
实验证明,GenerTTS在风格相似性和发音准确性方面优于基准系统,并实现了跨语言音色和风格的可泛化性。
一直以来,火山语音团队面向字节跳动内部各业务线,提供优质的语音AI技术能力以及全栈语音产品解决方案,并通过火山引擎对外提供服务。自 2017 年成立以来,团队专注研发行业领先的 AI 智能语音技术,不断探索AI 与业务场景的高效结合,以实现更大的用户价值。

3月28日,OPPOFind系列产品负责人周意保在微博发文,表示OPPO已经进入了5.5G时代。OPPOFindX7系列周意保在微博上传了一张截图,图中的手机锁屏界面右上方状态栏信号一栏显示为5GA,也就是人们更加熟悉的5.5G。此外,周意保也发文称:"和大家一起进入5.5G新移动网络时代!"宣布了5.5G新移动网络时代的到来。OPPOFind系列产品负责人周意保微博有博主表示,OPPOFindX7系列即将行业首发支持5G-A(5.5G),OTA固件已经准备好了。5G-A理论上可以实现10倍提升的连接速率
作者|香港中文大学白帆编辑|ScienceAI近日,香港中文大学和智源联合提出的M3D系列工作,包括M3D-Data,M3D-LaMed和M3D-Bench,从数据集、模型和测评全方面推动3D医学图像分析的发展。(1)M3D-Data是目前最大的3D医学图像数据集,包括M3D-Cap(120K3D图文对),M3D-VQA(510K问答对),M3D-Seg(150K3DMask),M3D-RefSeg(3K推理分割)共四个子数据集。(2)M3D-LaMed是目前最多功能的3D医学多模态大模型,能够解决文本(
编辑|紫罗AI在简化药物发现方面的应用正在爆炸式增长。从数十亿种候选分子中筛选出可能具有开发新药所需特性的分子。需要考虑的变量太多了,从材料价格到出错的风险,即使科学家使用AI,权衡合成最佳候选分子的成本也不是一件容易的事。在此,MIT研究人员开发了一个定量决策算法框架SPARROW,来自动识别最佳分子候选物,从而最大限度地降低合成成本,同时最大限度地提高候选物具有所需特性的可能性。该算法还确定了合成这些分子所需的材料和实验步骤。SPARROW考虑了一次合成一批分子的成本,因为多个候选分子通常可以从一些相
编辑|萝卜皮OpenAI的GPT和MetaAI的Llama等大型语言模型(LLM)因其在化学信息学领域的潜力而日益受到认可,特别是在理解简化分子输入行输入系统(SMILES)方面。这些LLM还能够将SMILES字符串解码为矢量表示。加拿大温莎大学(UniversityofWindsor)的研究人员比较了GPT和Llama与SMILES上的预训练模型在下游任务中嵌入SMILES字符串的性能,重点关注两个关键应用:分子特性预测和药物-药物相互作用预测。该研究以「Canlargelanguagemodelsun
编辑|萝卜皮在处理语言时,大脑会部署专门的计算来从复杂的语言结构中构建含义。基于Transformer架构的人工神经网络是自然语言处理的重要工具。普林斯顿大学的研究人员探讨了Transformer模型和人类大脑在语言处理中的功能特殊化问题。Transformer通过结构化电路计算整合单词间的上下文信息。不过,当前的研究主要集中于这些电路生成的内部表征(「嵌入」)。研究人员直接分析电路计算:他们将这些计算解构为功能专门的「transformations」,将跨词语的上下文信息整合在一起。利用参与者聆听自然故
编辑|X人工智能(AI)在过去几年中以惊人的速度发展。一些科学家现在着眼于超级人工智能(ArtificialSuperintelligence,ASI)的发展,这是一种不仅超越人类智能,而且不受人类学习速度限制的AI。超级人工智能的发展可能会带来巨大的影响和挑战。一方面,它可能为我们带来前所未有的技术进步和创新,解决各种复杂的问题。另一方面,由于其超越人类智慧的能力,我们也需要谨慎对待和管理它的发展,以避免可能的风险和危害。因此但如果这个里程碑不仅仅是一项了不起的成就呢?如果它也代表了所有文明发展的一个巨
编辑|枯叶蝶准确识别药物-靶标相互作用(DTI)是药物发现和药物重新定位过程中的关键步骤之一。目前,许多基于计算的模型已被提出,用于预测DTI,并取得了一些显著的进步。然而,这些方法很少关注如何以适当的方式融合与药物和靶标相关的多视角相似性网络。此外,如何充分结合已知的相互作用关系来准确表示药物和靶标尚未得到很好的研究。因此,提高DTI预测模型的准确性仍然是必要的。在最新的研究中,郑州大学、电子科技大学团队提出了一种新方法MIDTI。该方法采用多视图相似性网络融合策略和深度交互式注意机制来预测药物-靶标相
来自清华大学AIR、北京大学、南京大学的研究团队提出了ESM-AA模型。该模型在蛋白质语言建模领域取得了重要进展,提供了一套整合多尺度信息的统一建模方案。它是首个能同时处理氨基酸信息和原子信息的蛋白质预训练语言模型。模型的出色性能展示了多尺度统一建模在克服现有局限和解锁新能力方面的巨大潜力。作为基座模型,ESM-AA获得了多位学者的关注与广泛讨论(截图见下方),被认为有潜力基于ESM-AA开发出可与AlphaFold3、RoseTTAFoldAll-Atom相竞争的模型,为研究不同生物结构间的相互作用开辟
编辑|萝卜皮生物大分子结构对于药物开发和生物催化至关重要。量子力学(QM)方法进行晶体细化,在提高结构质量至纠正生物大分子的结构方面显露出前景。量子细化(Quantumrefinement,QR)方法采用可靠的量子力学(QM)方法进行晶体精化,以显示出前景。然而,巨大的计算成本和复杂的量子力学/分子力学(QM/MM)设置限制了QR的应用。在南方科技大学的研究团队将稳健的机器学习势(MachineLearningPotentials,MLP)融入多尺度ONIOM(QM:MM)方案中,来描述核心部分(例如药物
序列建模的进展具有极大的影响力,因为它们在广泛的应用中发挥着重要作用,包括强化学习(例如,机器人和自动驾驶)、时间序列分类(例如,金融欺诈检测和医学诊断)等。在过去的几年里,Transformer的出现标志着序列建模中的一个重大突破,这主要得益于Transformer提供了一种能够利用GPU并行处理的高性能架构。然而,Transformer在推理时计算开销很大,主要在于内存和计算需求呈二次扩展,从而限制了其在低资源环境中的应用(例如,移动和嵌入式设备)。尽管可以采用KV缓存等技术提高推理效率,但Trans





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



