

Spark实时流计算入门与实战技巧
SparkStreaming和StructuredStreaming是ApacheSpark生态系统中用于流处理的两种不同框架。让我们详细比较它们的特点和优势。SparkStreaming的特点:SparkStreaming是Spark最初推出的流处理框架,采用微批处理的方式进行流数据处理。它使用基于RDD的DStreamAPI,每个时间间隔内的数据被视为一个RDD,通过不断处理这些RDD来实现流计算。然而,SparkStreaming也存在一些不足:处理时间而非事件时间:SparkStr
Spark Streaming和Structured Streaming是Apache Spark生态系统中用于流处理的两种不同框架。让我们详细比较它们的特点和优势。
Spark Streaming的特点:
Spark Streaming是Spark最初推出的流处理框架,采用微批处理的方式进行流数据处理。它使用基于RDD的DStream API,每个时间间隔内的数据被视为一个RDD,通过不断处理这些RDD来实现流计算。
然而,Spark Streaming也存在一些不足:
处理时间而非事件时间:Spark Streaming基于处理时间(Processing Time)进行数据切割,而非事件时间(Event Time)。处理时间是数据到达Spark被处理的时间,而事件时间是数据本身产生的时刻。这种基于处理时间的切割使得使用事件时间进行数据处理变得非常困难。
复杂且低级的API:DStream API类似于RDD API,属于低级API。开发者需要构造RDD的DAG执行图,这可能导致执行效率因开发者水平不同而有显著差异,影响开发体验。
难以保证端到端的一致性:DStream只能保证自身的exactly-once一致性语义,而输入和输出的一致性需要开发者自己保证,这对开发者来说是一个挑战。
批流代码不统一:尽管批处理和流处理是两套系统,但统一它们是有必要的。将DStream代码转换为RDD需要额外的工作量,而现在Spark的批处理已经使用DataSet/DataFrame API。
Structured Streaming的优势:
Structured Streaming是Spark 2.0版本推出的新的实时流处理框架(2.0和2.1为实验版本,从Spark 2.2开始为稳定版本)。自Spark 2.X版本后,Spark Streaming进入维护模式,而Structured Streaming成为Spark流处理的主要方向。
Structured Streaming的优势包括:
简洁的模型:Structured Streaming将流数据视为一个不断增长的表,模型简洁易懂。
一致的API:与Spark SQL共用大部分API,使得熟悉Spark SQL的用户容易上手。批处理和流处理可以共用代码,提高开发效率。
卓越的性能:Structured Streaming使用Spark SQL的Catalyst优化器和Tungsten引擎,性能出色,并能从Spark SQL的未来性能优化中受益。
多语言支持:支持Spark SQL支持的所有语言,包括Scala、Java、Python、R和SQL,用户可以选择自己喜欢的语言进行开发。
基于事件时间:与Spark Streaming基于处理时间不同,Structured Streaming支持基于事件时间的处理,更符合业务场景。
支持Spark 2的DataFrame处理:解决了Spark Streaming在代码升级、DAG图变化导致的任务失败和无法断点续传的问题。
基于Spark SQL的可扩展和容错流处理引擎:使得实时流处理和离线计算可以使用相同的处理方式(DataFrame&SQL)。
底层原理差异:
Spark Streaming:采用微批处理方法,每个批处理间隔为一个批次,即一个RDD,通过操作RDD实现持续数据处理。
Structured Streaming:将实时数据视为被连续追加的表,每条数据类似于向表中添加一行新数据。
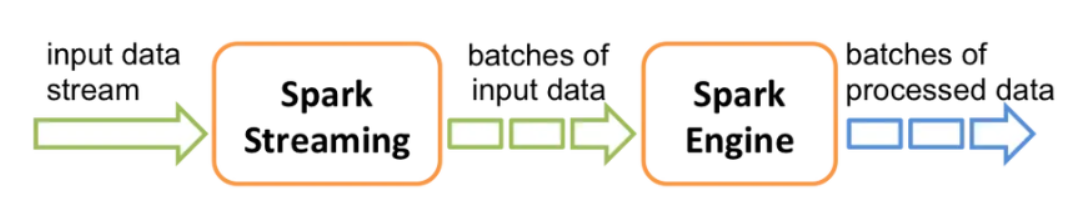
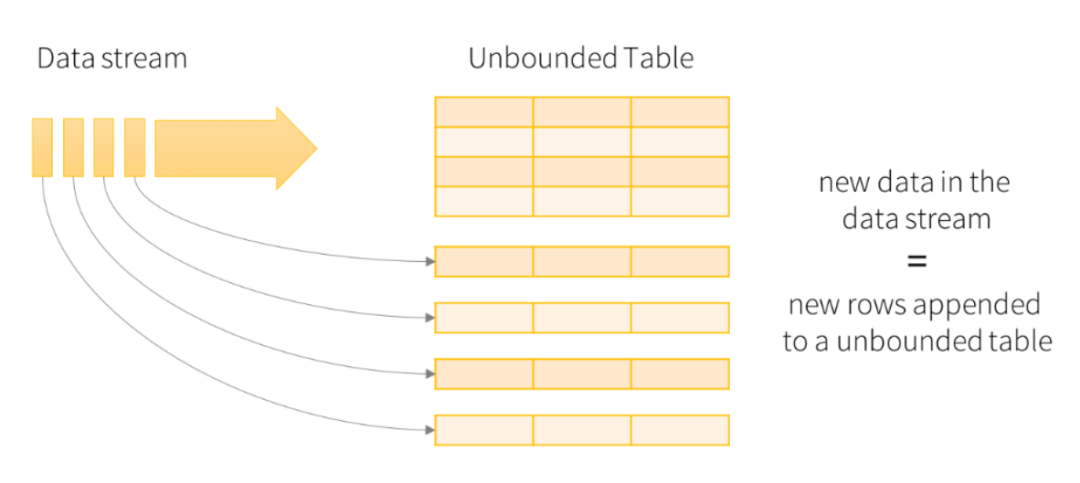
自Spark 3.0.0发布后,Structured Streaming迎来了全新的UI界面,预示着Structured Streaming将在未来不断进步。
通过上述比较可以看出,Structured Streaming在简洁性、一致性、性能和多语言支持等方面都优于Spark Streaming,是Spark流处理的未来方向。
针对Java开发者的实用大数据技术路线解析,深入梳理Hadoop生态存储与资源调度、Spark离线计算与内存模型、Flink低延迟流处理的核心技术要点及递进学习方法。

针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
NVIDIA展台以巨型RTX显卡为造型,RTXSPARK系列笔记本首次在中国大陆公开亮相,现场展示多款OEM产品及离电性能。DGXSPARK支持图像识别与问答。技术体验区涵盖DLSS4.5游戏试玩和多元AI功能。联合多家厂商推出二次元定制显卡,但未公布发售计划。
达瓦科技基于NVIDIADGXSpark构建工程体系,将大模型推理部署于销售场景。其智能销售辅助机器人DealCat在高并发、低延迟环境下实现稳定运行,解决了实时推理与算力不足等瓶颈,助力企业销售全链路智能化。
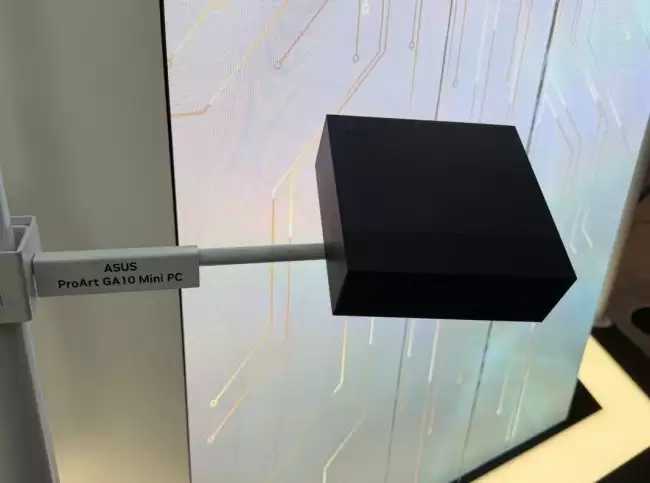
在台北电脑展上,联想、华硕、戴尔、微星四大厂商均推出了RTXSpark迷你主机新品,全部配备万兆网口。这款主机搭载二十核心CPU与四十八组SM的BlackwellGPU,最高可支持一百二十八GBLPDDR5X统一内存容量,并提供USB-C高速接口与PCIeGen5M.2扩展插槽。
Meta AI“推倒重来”:华人天团交出首份答卷Muse Spark,但更大的战争才刚刚开始 作者 | 猫猫头邮箱 | cathy@pingwest.com 在Llama 4的“崩盘”成为旧闻之后,Meta的AI路线图经历了一场彻底的自我革命。创始人扎克伯格亲手拆解了过去的团队与技术架构,转而押注一

随着数据量的不断增加,大规模数据处理已经成为了企业必须面对和解决的问题。传统的关系型数据库已经无法满足这种需求,而对于大规模数据的存储和分析,Hadoop、Spark、Flink等分布式计算平台成为了最佳选择。在数据处理工具的选择过程中,PHP作为一种易于开发和维护的语言,越来越受到开发者的欢迎。在本文中,我们将探讨如何利用PHP来实现大规模数据处理,以及如
ApacheSpark是一种流行的数据处理框架,它能够处理不同类型的数据并提供高效的分布式计算能力。同时,PHP是一种流行的开发语言,它具有简单易学、开源免费、跨平台等优点。那么如何将PHP与ApacheSpark进行集成,以实现大数据处理的目的呢?一、使用PHP连接ApacheSpark首先,需要使用PHP连接ApacheSpark,并且指定一组为
Java大数据技术栈:了解Java在大数据领域的应用,如Hadoop、Spark、Kafka等随着数据量不断增加,大数据技术成为了当今互联网时代的热门话题。在大数据领域,我们常常听到Hadoop、Spark、Kafka等技术的名字。这些技术起到了至关重要的作用,而Java作为一门广泛应用的编程语言,也在大数据领域发挥着巨大的作用。本文将重点介绍Java在大
随着互联网技术的不断发展,大数据时代已经到来。大数据处理的重要性也日益增强。在处理大数据时,Hadoop和Spark是目前非常流行的解决方案。在使用这两个工具时,Beego是一种极受欢迎的Web框架,让开发人员可以更加高效地开发和管理代码。在本文中,我们将探讨如何在Beego中使用Hadoop和Spark进行大数据处理。Hadoop是基于Java的一个分布式





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



