

使用Panda-Gym的机器臂模拟实现Deep Q-learning强化学习
强化学习(RL)是一种机器学习方法,它允许代理通过试错来学习如何在环境中表现。行为主体会因为采取行动导致预期结果而获得奖励或受到惩罚。随着时间的推移,代理会学会采取行动,以使得其预期回报最大化RL代理通常使用马尔可夫决策过程(MDP)进行训练,MDP是为顺序决策问题建模的数学框架。MDP由四个部分组成:状态:环境的可能状态的集合。动作:代理可以采取的一组动作。转换函数:在给定当前状态和动作的情况下,预测转换到新状态的概率的函数。奖励函数:为每次转换分配奖励给代理的函数。代理的目标是学习策略函数,将状态映射
强化学习(RL)是一种机器学习方法,它允许代理通过试错来学习如何在环境中表现。行为主体会因为采取行动导致预期结果而获得奖励或受到惩罚。随着时间的推移,代理会学会采取行动,以使得其预期回报最大化
RL代理通常使用马尔可夫决策过程(MDP)进行训练,MDP是为顺序决策问题建模的数学框架。MDP由四个部分组成:
- 状态:环境的可能状态的集合。
- 动作:代理可以采取的一组动作。
- 转换函数:在给定当前状态和动作的情况下,预测转换到新状态的概率的函数。
- 奖励函数:为每次转换分配奖励给代理的函数。
代理的目标是学习策略函数,将状态映射到动作。通过策略函数来最大化代理随着时间的预期回报。
Deep Q-learning是一种使用深度神经网络学习策略函数的强化学习算法。深度神经网络以当前状态作为输入,并输出一个值向量,其中每个值代表一个可能的动作。然后代理根据具有最高值的操作进行采取
Deep Q-learning是一种基于值的强化学习算法,这意味着它学习每个状态-动作对的值。状态-动作对的值是agent在该状态下采取该动作所获得的预期奖励。
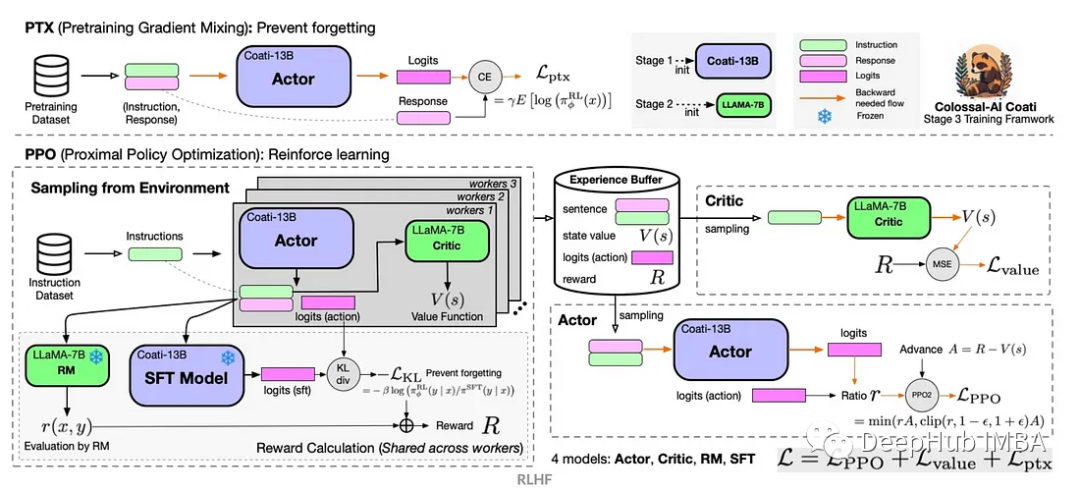
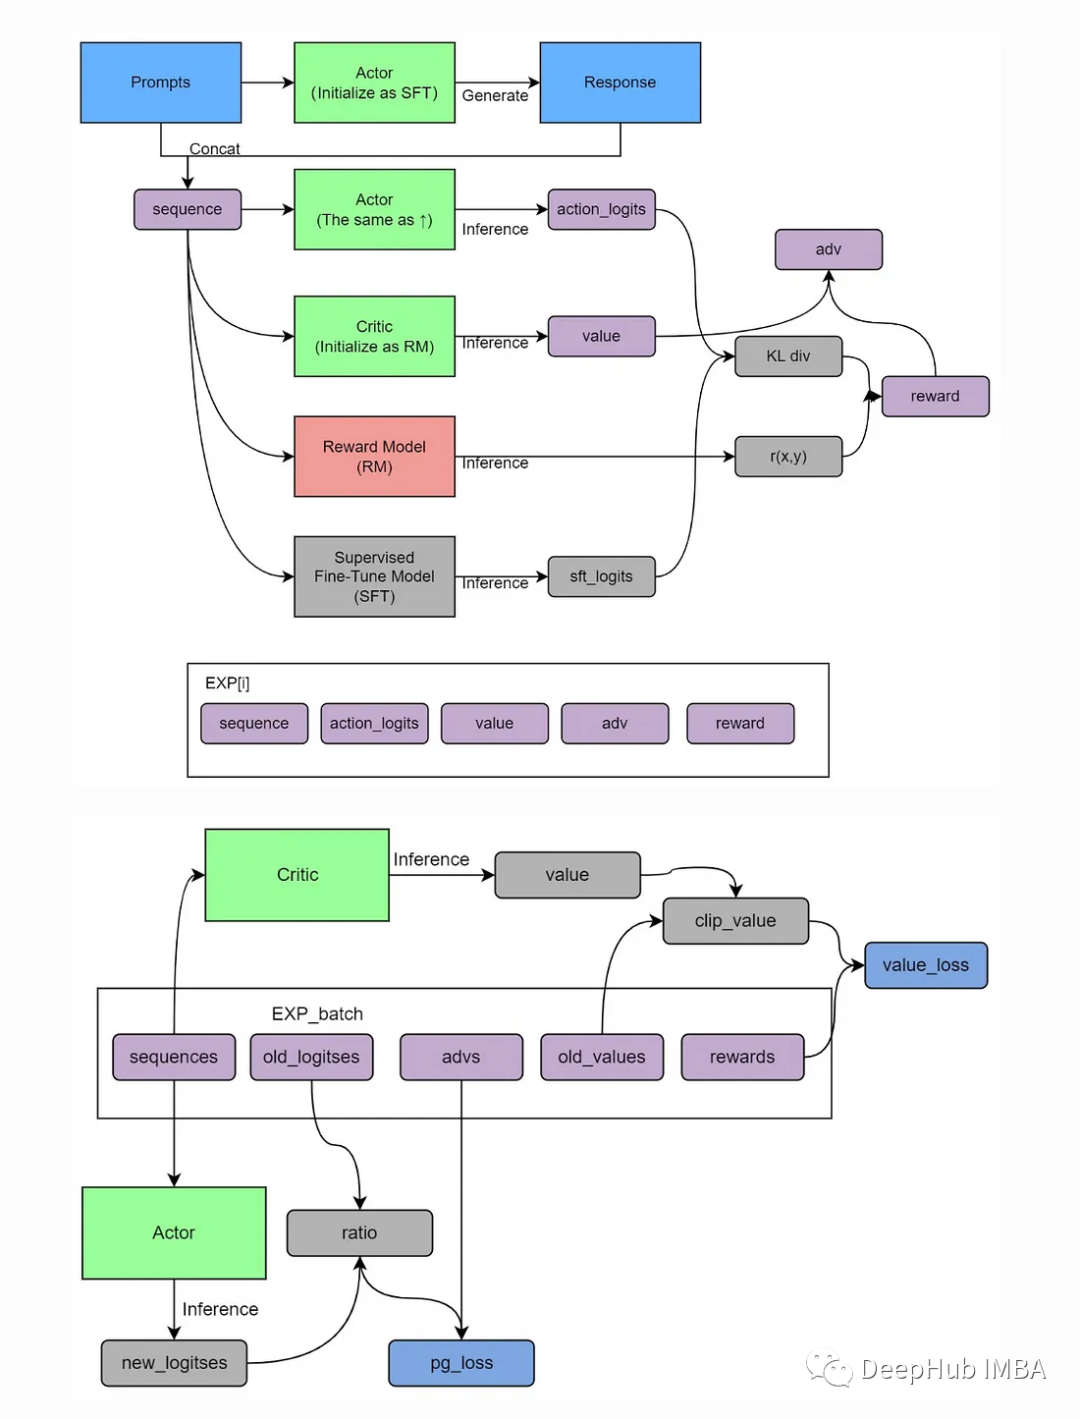
Actor-Critic是一种结合了基于值和基于策略的RL算法。有两个组成部分:
Actor:参与者负责选择操作。
Critic:负责评价Actor的行为。
演员和评论家同时接受培训。演员接受培训以最大化预期奖励,评论家接受培训以准确预测每个状态-动作对的预期奖励
Actor-Critic算法相对于其他强化学习算法有几个优点。首先,它更加稳定,这意味着在训练过程中不太可能出现偏差。其次,它更加高效,这意味着它可以更快地学习。第三,它具有更好的可扩展性,可以应用于具有大型状态和操作空间的问题
下面的表格总结了Deep Q-learning和Actor-Critic之间的主要区别:

Actor-Critic (A2C)的优势
演员-评论家是一种受欢迎的强化学习体系结构,它结合了基于策略和基于价值的方法。它有许多优点,使其成为解决各种强化学习任务的强有力的选择:
1、低方差
相较于传统的策略梯度方法,A2C 在训练过程中通常具有较低的方差。这是因为 A2C 同时使用了策略梯度和值函数,在梯度的计算中利用值函数来降低方差。低方差表示训练过程更加稳定,能够更快地收敛到更优的策略
2、更快的学习速度
由于低方差的特性,A2C 通常能够以更快的速度学习到一个良好的策略。这对于那些需要进行大量模拟的任务来说尤为重要,因为较快的学习速度可以节省宝贵的时间和计算资源。
3、结合策略和值函数
A2C 的一个显著特点是它同时学习策略和值函数。这种结合使得代理能够更好地理解环境和动作的关联,从而更好地指导策略改进。值函数的存在还有助于减小策略优化中的误差,提高训练的效率。
4、支持连续和离散动作空间
A2C 可以适应不同类型的动作空间,包括连续和离散动作,而且非常通用。这就使得 A2C 成为一个广泛适用的强化学习算法,可以应用于各种任务,从机器人控制到游戏玩法优化
5、并行训练
A2C 可以轻松地并行化,充分利用多核处理器和分布式计算资源。这意味着可以在更短的时间内收集更多的经验数据,从而提高训练效率。
尽管Actor-Critic方法具有一些优势,但是它们也面临着一些挑战,比如超参数调优和训练中的潜在不稳定性。然而,通过适当的调整以及经验回放和目标网络等技术,这些挑战可以在很大程度上得到缓解,使得Actor-Critic成为强化学习中有价值的方法
panda-gym
panda-gym 基于 PyBullet 引擎开发,围绕 panda 机械臂封装了 reach、push、slide、pick&place、stack、flip 等 6 个任务,主要也是受 OpenAI Fetch 启发。
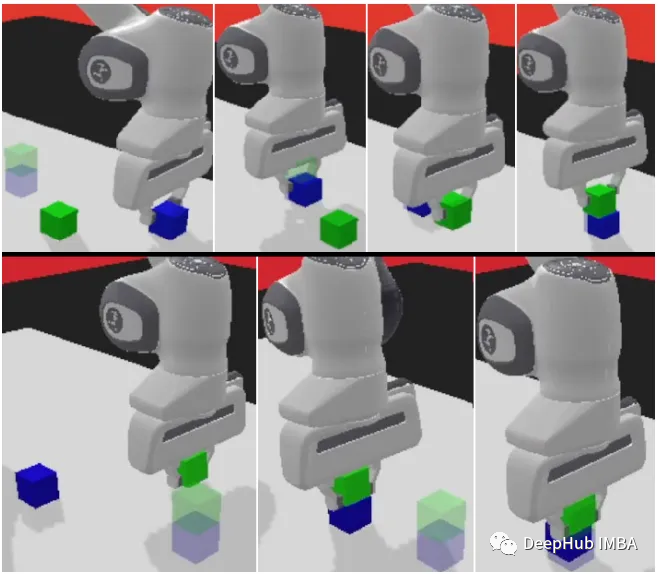
我们将使用panda-gym作为示例来展示下面的代码
1、安装库
首先,我们需要初始化强化学习环境的代码:
!apt-get install -y \libgl1-mesa-dev \libgl1-mesa-glx \libglew-dev \xvfb \libosmesa6-dev \software-properties-common \patchelf !pip install \free-mujoco-py \pytorch-lightning \optuna \pyvirtualdisplay \PyOpenGL \PyOpenGL-accelerate\stable-baselines3[extra] \gymnasium \huggingface_sb3 \huggingface_hub \ panda_gym
2、导入库
import os import gymnasium as gym import panda_gym from huggingface_sb3 import load_from_hub, package_to_hub from stable_baselines3 import A2C from stable_baselines3.common.evaluation import evaluate_policy from stable_baselines3.common.vec_env import DummyVecEnv, VecNormalize from stable_baselines3.common.env_util import make_vec_env
3、创建运行环境
env_id = "PandaReachDense-v3" # Create the env env = gym.make(env_id) # Get the state space and action space s_size = env.observation_space.shape a_size = env.action_space print("\n _____ACTION SPACE_____ \n") print("The Action Space is: ", a_size) print("Action Space Sample", env.action_space.sample()) # Take a random action4、观察和奖励的规范化
强化学习优化的一个好方法是对输入特征进行归一化。我们通过包装器计算输入特征的运行平均值和标准偏差。同时还通过添加norm_reward = True来规范化奖励
env = make_vec_env(env_id, n_envs=4) env = VecNormalize(env, norm_obs=True, norm_reward=True, clip_obs=10.)
5、创建A2C模型
我们使用Stable-Baselines3团队训练过的官方代理
model = A2C(policy = "MultiInputPolicy",env = env,verbose=1)
6、训练A2C
model.learn(1_000_000) # Save the model and VecNormalize statistics when saving the agent model.save("a2c-PandaReachDense-v3") env.save("vec_normalize.pkl")7、评估代理
from stable_baselines3.common.vec_env import DummyVecEnv, VecNormalize # Load the saved statistics eval_env = DummyVecEnv([lambda: gym.make("PandaReachDense-v3")]) eval_env = VecNormalize.load("vec_normalize.pkl", eval_env) # We need to override the render_mode eval_env.render_mode = "rgb_array" # do not update them at test time eval_env.training = False # reward normalization is not needed at test time eval_env.norm_reward = False # Load the agent model = A2C.load("a2c-PandaReachDense-v3") mean_reward, std_reward = evaluate_policy(model, eval_env) print(f"Mean reward = {mean_reward:.2f} +/- {std_reward:.2f}")总结
在“panda-gym”将Panda机械臂和GYM环境有效的结合使得我们可以轻松的在本地进行机械臂的强化学习,
Actor-Critic架构中代理会学会在每个时间步骤中进行渐进式改进,这与稀疏的奖励函数形成对比(在稀疏的奖励函数中结果是二元的),这使得Actor-Critic方法特别适合于此类任务。
通过无缝结合策略学习和值估计,机器人代理能够熟练地操纵机械臂末端执行器,准确到达指定的目标位置。这不仅为机器人控制等任务提供了实用的解决方案,还具有改变各种需要敏捷和明智决策的领域的潜力
针对编程示例任务中缺乏过程监督的问题,提出PRM-PBE框架,通过反馈引导构建推理树生成过程监督数据,训练过程奖励模型评估中间推理步骤,并采用三阶段课程学习与PPO优化。在多个基准上,以DeepSeek-Coder-V2为基础模型,Pass@1提升至56.61%,显著优于现有方法。

机器学习奠基人MichaelJordan认为AGI是公关炒作,AI的真正挑战在于让系统学会协调。他主张机器学习必须与经济学结合,关注不确定性、激励机制和数据流动等社会系统性问题,而非单纯追求模型能力。
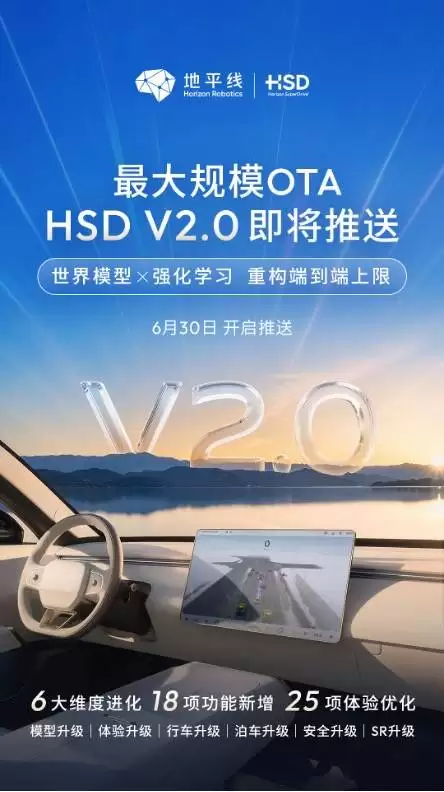
6月29日,地平线正式推出了全场景辅助驾驶系统HSD V2.0版本。这不仅是HSD发布以来最大规模的OTA升级,更是一次从底层能力到用户体验的全方位进化——横跨6大维度,带来18项新增功能和25项体验优化。核心能力总结起来就八个字:“任意点到点,全维防碰撞”。可以说,这为一段式端到端系统持续进化,树
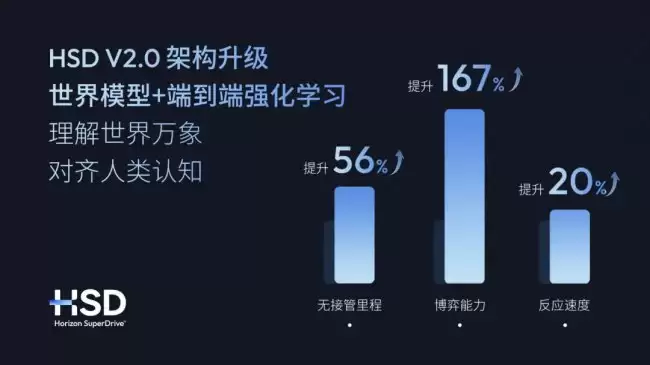
地平线HSDV2.0将端到端强化学习与世界模型深度整合,实现智驾从被动响应到主动预判的跨越。扩展OCC技术至AEB、AES等场景,统一底座模型精准识别各类障碍物。环境响应时延较行业均值快34%,77%用户主动选择该系统,智驾里程占比近50%,系统具备自主进化能力。
奇瑞iCARV27推送地平线HSDV2.0OTA升级,新增点对点智驾、全场景主动避险及高效泊车功能,征程6P芯片效率提升,支持AI定制SR皮肤。数据显示,77%用户选择HSD版本,智驾使用率达85.14%。

持续坚持原创输出,点击蓝字关注我吧 ❝ 沉淀、分享、成长,让自己和他人都能有所收获! ❞ 目录 一、前言二、面试题三、线程池讲解1. 先看个例子2. 手写一个线程池3. 线程池源码分析四、总结五、系列推荐一、前言人看手机,机器学习!正好是2020年,看到这张图还是蛮有意思的。以前小时候总会看到一些科
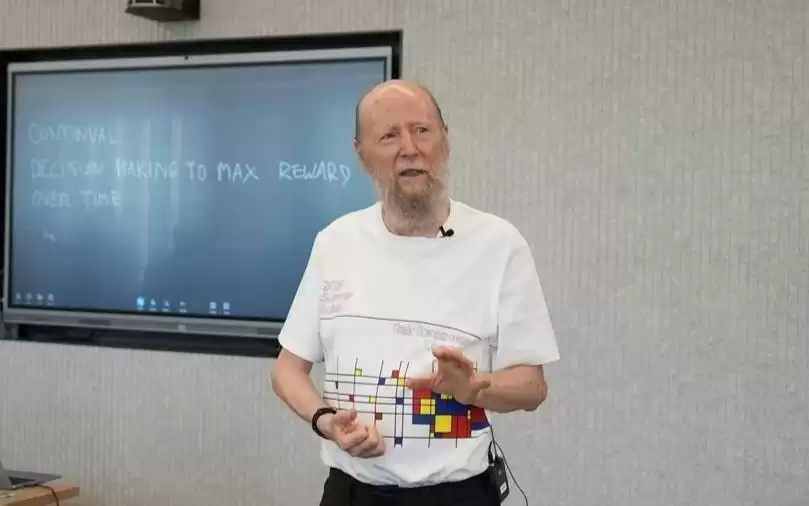
2024年图灵奖得主萨顿预测,2030年出现人类水平通用人工智能的概率为25%,届时仅需约1000美元即可获得人脑级算力。他呼吁回归智能本质研究,强调强化学习需通过实时交互实现长期收益最大化,而非依赖静态数据。
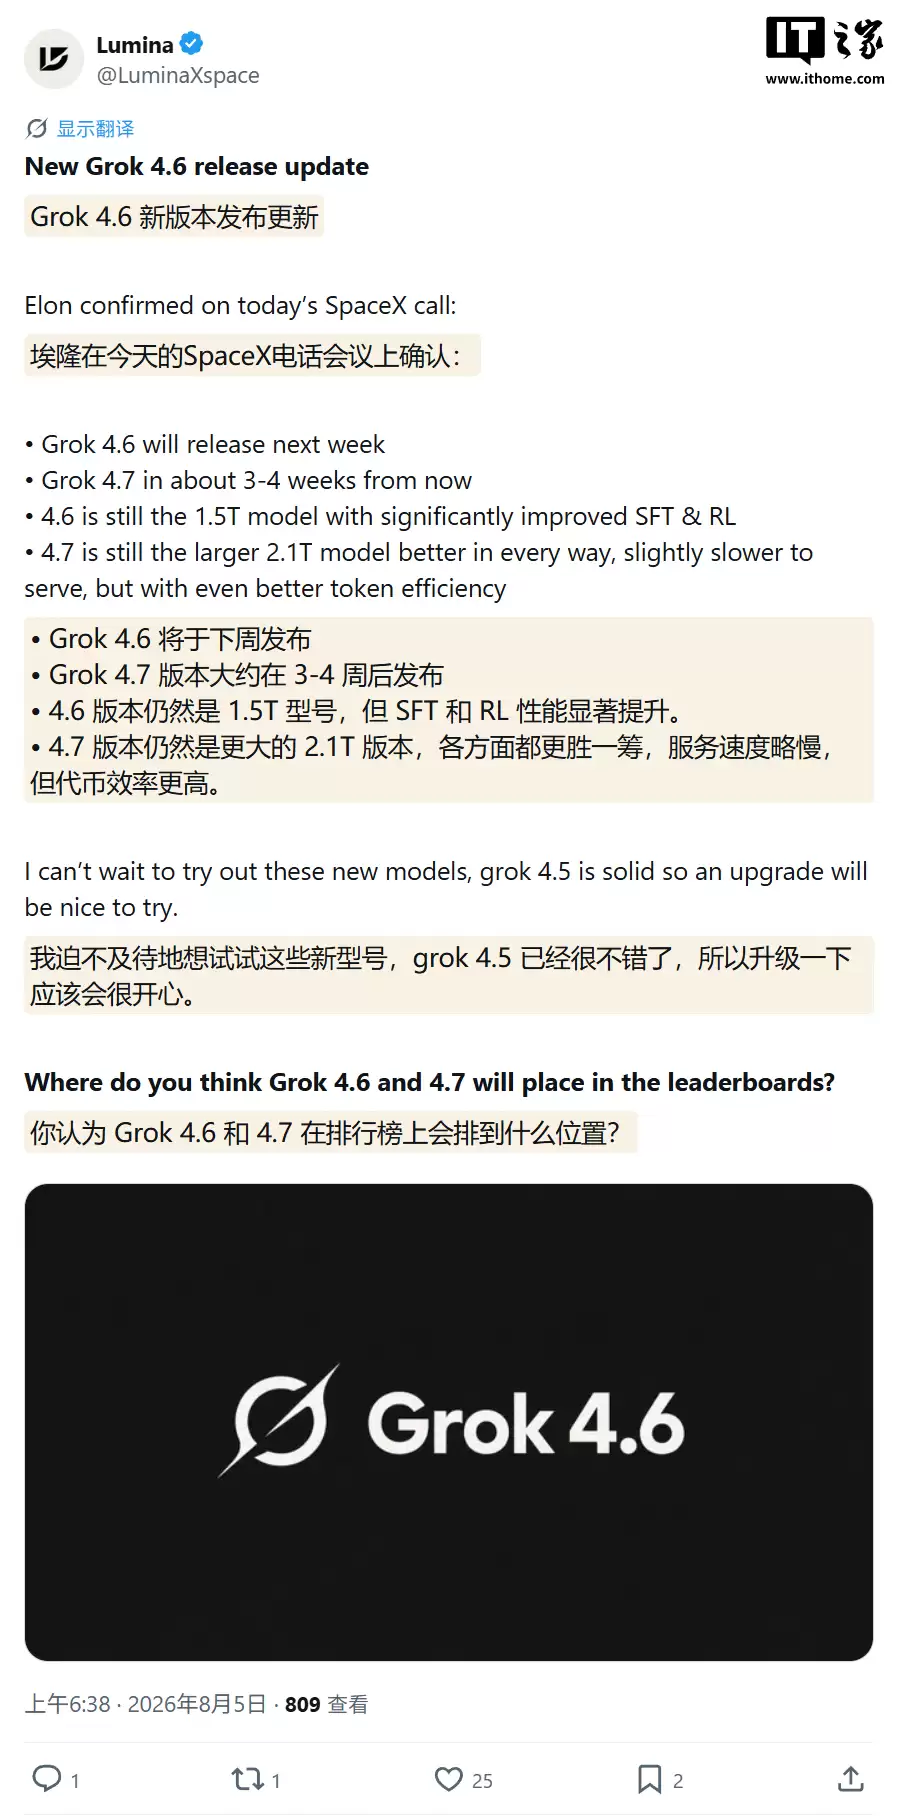
马斯克在SpaceX财报电话会上宣布,下周将发布Grok4.6模型,总参数量1.5万亿,重点优化监督微调与强化学习;同时预告未来3-4周推出Grok4.7模型,参数规模2.1万亿,综合性能更优。

当前数字时代,deepseek入口智能助手凭借前沿技术架构为用户带来革新体验 在如今这个数字浪潮翻涌的时代,deepseek入口智能助手凭借其前沿的技术架构,为用户带来了真正意义上的革新体验。这个平台巧妙融合了自然语言处理与知识图谱技术,能够精准解析那些看似复杂的语义需求,已然成为提升工作效率的智能
CMake已成为现代C++工程基础设施,官方完善了学习资源,提供从入门到精通的系统化路径。Kitware提供培训和高级支持,针对构建系统迁移、优化及企业流程规范。学习资料应分层,结合工具使用、工程规范与CI流程,以发挥CMake价值。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



