

强化学习
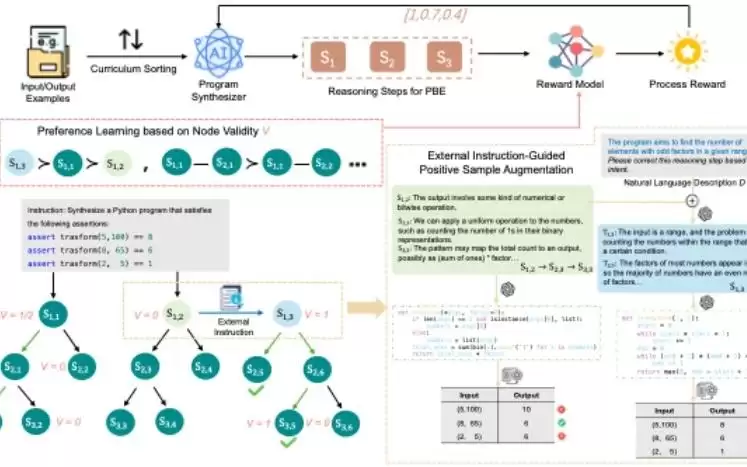
针对编程示例任务中缺乏过程监督的问题,提出PRM-PBE框架,通过反馈引导构建推理树生成过程监督数据,训练过程奖励模型评估中间推理步骤,并采用三阶段课程学习与PPO优化。在多个基准上,以DeepSeek-Coder-V2为基础模型,Pass@1提升至56.61%,显著优于现有方法。
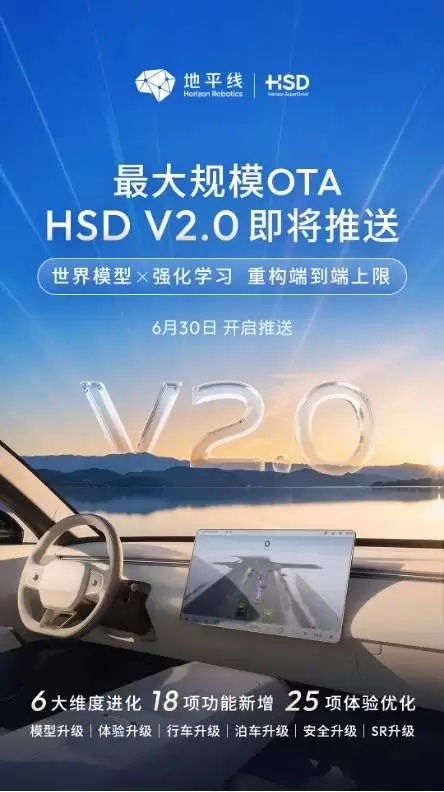
6月29日,地平线正式推出了全场景辅助驾驶系统HSD V2.0版本。这不仅是HSD发布以来最大规模的OTA升级,更是一次从底层能力到用户体验的全方位进化——横跨6大维度,带来18项新增功能和25项体验优化。核心能力总结起来就八个字:“任意点到点,全维防碰撞”。可以说,这为一段式端到端系统持续进化,树
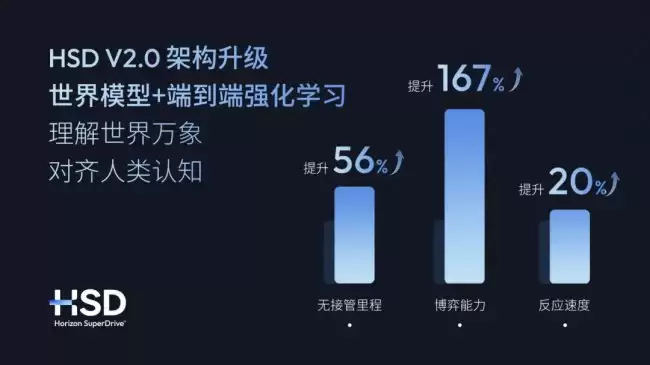
地平线HSDV2.0将端到端强化学习与世界模型深度整合,实现智驾从被动响应到主动预判的跨越。扩展OCC技术至AEB、AES等场景,统一底座模型精准识别各类障碍物。环境响应时延较行业均值快34%,77%用户主动选择该系统,智驾里程占比近50%,系统具备自主进化能力。
奇瑞iCARV27推送地平线HSDV2.0OTA升级,新增点对点智驾、全场景主动避险及高效泊车功能,征程6P芯片效率提升,支持AI定制SR皮肤。数据显示,77%用户选择HSD版本,智驾使用率达85.14%。
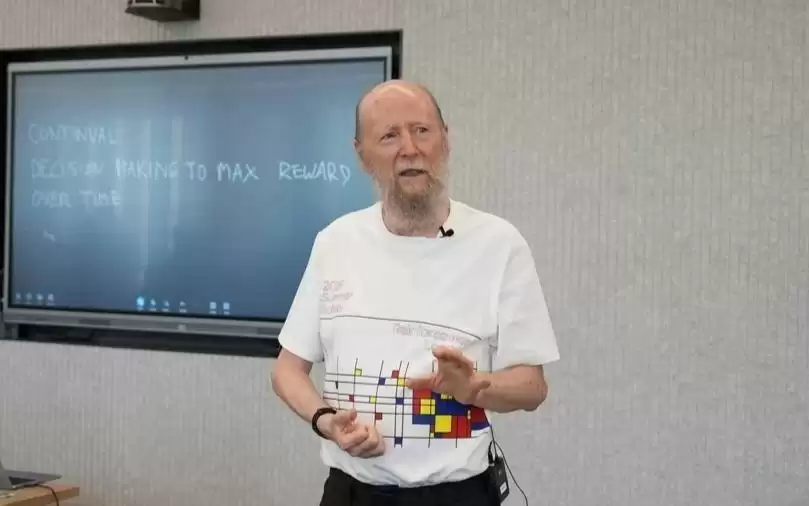
2024年图灵奖得主萨顿预测,2030年出现人类水平通用人工智能的概率为25%,届时仅需约1000美元即可获得人脑级算力。他呼吁回归智能本质研究,强调强化学习需通过实时交互实现长期收益最大化,而非依赖静态数据。

马斯克在SpaceX财报电话会上宣布,下周将发布Grok4.6模型,总参数量1.5万亿,重点优化监督微调与强化学习;同时预告未来3-4周推出Grok4.7模型,参数规模2.1万亿,综合性能更优。

CMake已成为现代C++工程基础设施,官方完善了学习资源,提供从入门到精通的系统化路径。Kitware提供培训和高级支持,针对构建系统迁移、优化及企业流程规范。学习资料应分层,结合工具使用、工程规范与CI流程,以发挥CMake价值。

强化学习之父RichardSutton宣布创立OakLab,旨在打造能从自身经验持续学习、实时进化的AI系统,挑战当前大语言模型范式。他认为LLM依赖人类数据而非经验,真正的智能需通过试错产生新发现。OaK架构基于选项与知识,但面临灾难性遗忘等技术瓶颈。

先说个有意思的场景:7月23日下午2点,上海创智学院102多功能厅外,63位少年早已坐得笔直,眼神里满是期待和兴奋。当一位穿着花衬衫的熟悉身影出现在门口时,掌声毫无预兆地炸开了。 来的是理查德·萨顿——“强化学习之父”,2024年图灵奖得主。刚刚结束2026年世界人工智能大会的紧张日程,他把半小时的

新京报贝壳财经讯 6月15日,均普智能放了个大招——旗下宁波具身智能机器人创新中心、博登智能和上海交通大学MINT实验室联手,正式开源了全球首个面向真实机器人强化学习(RW-RL)的大规模数据集RW-RL-Dataset首批数据。这事儿在圈内引起了不小的关注。 这个数据集打破了传统机器人数据只记录“
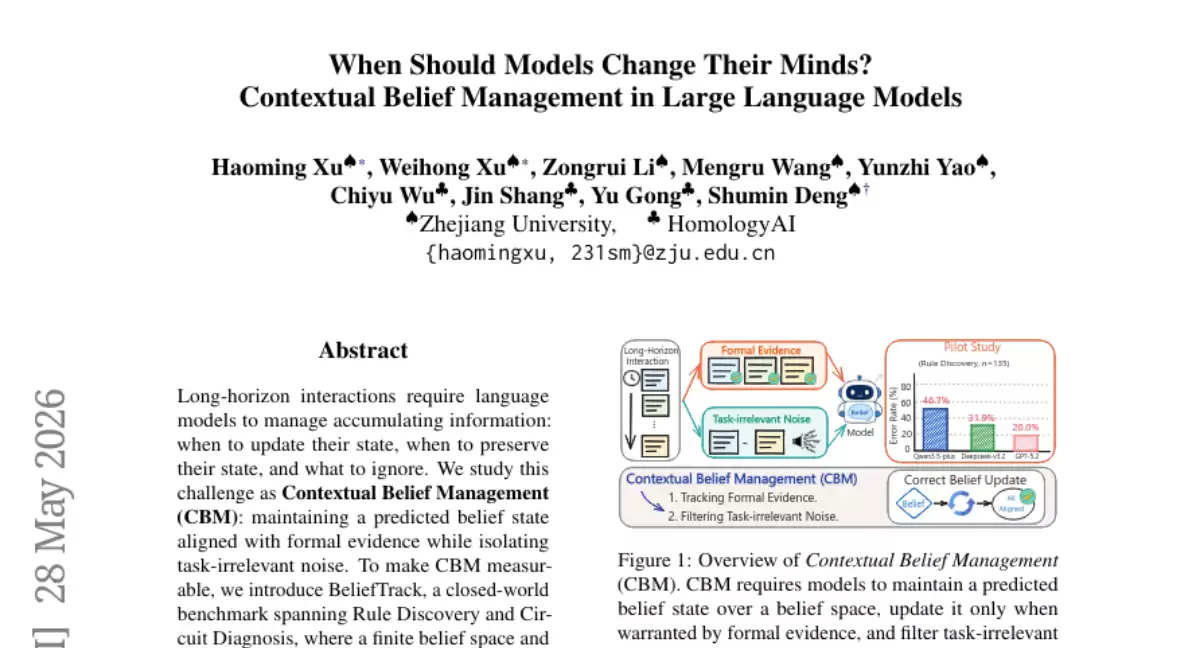
浙江大学联合HomologyAI提出情境信念管理(CBM)概念,设计BeliefTrack测评系统,发现顶尖AI模型在长对话中信念管理失败率高达20%以上。通过强化学习训练,模型证据追踪能力大幅提升,失败率降至0%且可迁移至未见场景,同时不影响通用能力。

腾讯与北大等提出强化学习新算法DR.Q,通过引入互信息损失帮助智能体理解环境本质特征,并结合经验价值与新鲜度设计数据采样策略,平衡历史经验利用。在多项复杂任务测试中,该方法显著提升了学习效率,尤其在处理高维冗余信息时表现优异。

强化学习通过试错调整策略,使程序在环境中学会完成任务。核心步骤包括:1.安装OpenAIGym环境,使用pip命令安装基础包或扩展包;2.创建环境如CartPole,调用gym.make并重置状态;3.与环境交互,随机或基于策略选择动作,执行后获取反馈;4.应用Q-learning算法训练agent,初始化Q表并按epsilon-greedy策略更新;5.评估agent性能,运行多轮测试并计算平均奖励;6.根据任务特性选择合适算法,如DQN、PolicyGradient等;7.调试和优化模型,调整超参数、
Golang在强化学习中的机器学习应用简介强化学习是一种机器学习方法,通过与环境互动并根据奖励反馈学习最优行为。Go语言具有并行、并发和内存安全等特性,使其在强化学习中具有优势。实战案例:围棋强化学习在本教程中,我们将使用Go语言和AlphaZero算法实现一个围棋强化学习模型。第一步:安装依赖项gogetgithub.com/tensorflow/tensorflow/tensorflow/gogogetgithub.com/golang/protobuf/ptypes/times
随着机器学习和人工智能技术的不断发展和进步,深度强化学习逐渐成为业界的热点和趋势。作为一种结合了深度学习和强化学习技术的新型人工智能技术,深度强化学习已经被广泛应用于机器人控制、游戏、自然语言处理等领域。Java作为一种跨平台和大型应用程序开发语言,在深度强化学习技术的应用中发挥着重要作用。本文将探讨Java实现的深度强化学习技术及其应用。深度强化学习技术深
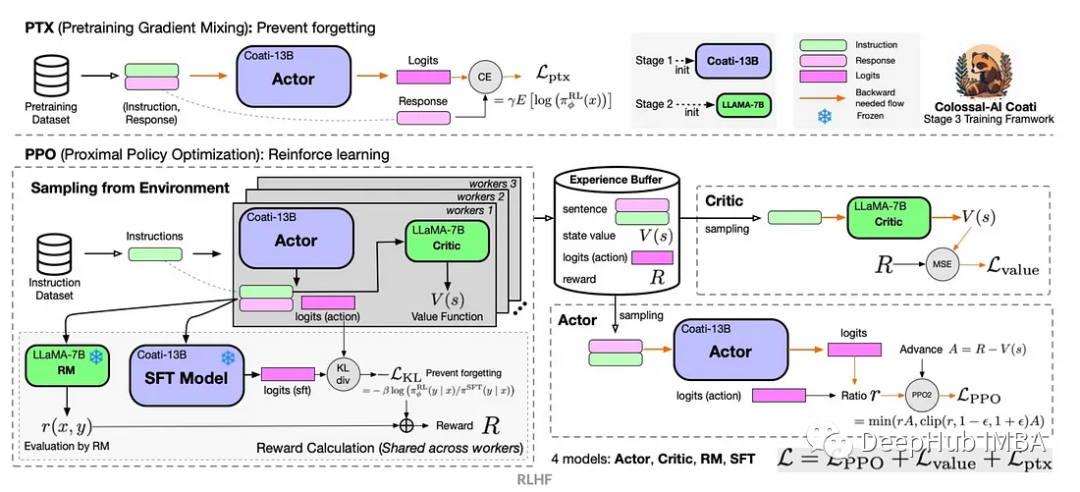
强化学习(RL)是一种机器学习方法,它允许代理通过试错来学习如何在环境中表现。行为主体会因为采取行动导致预期结果而获得奖励或受到惩罚。随着时间的推移,代理会学会采取行动,以使得其预期回报最大化RL代理通常使用马尔可夫决策过程(MDP)进行训练,MDP是为顺序决策问题建模的数学框架。MDP由四个部分组成:状态:环境的可能状态的集合。动作:代理可以采取的一组动作。转换函数:在给定当前状态和动作的情况下,预测转换到新状态的概率的函数。奖励函数:为每次转换分配奖励给代理的函数。代理的目标是学习策略函数,将状态映射
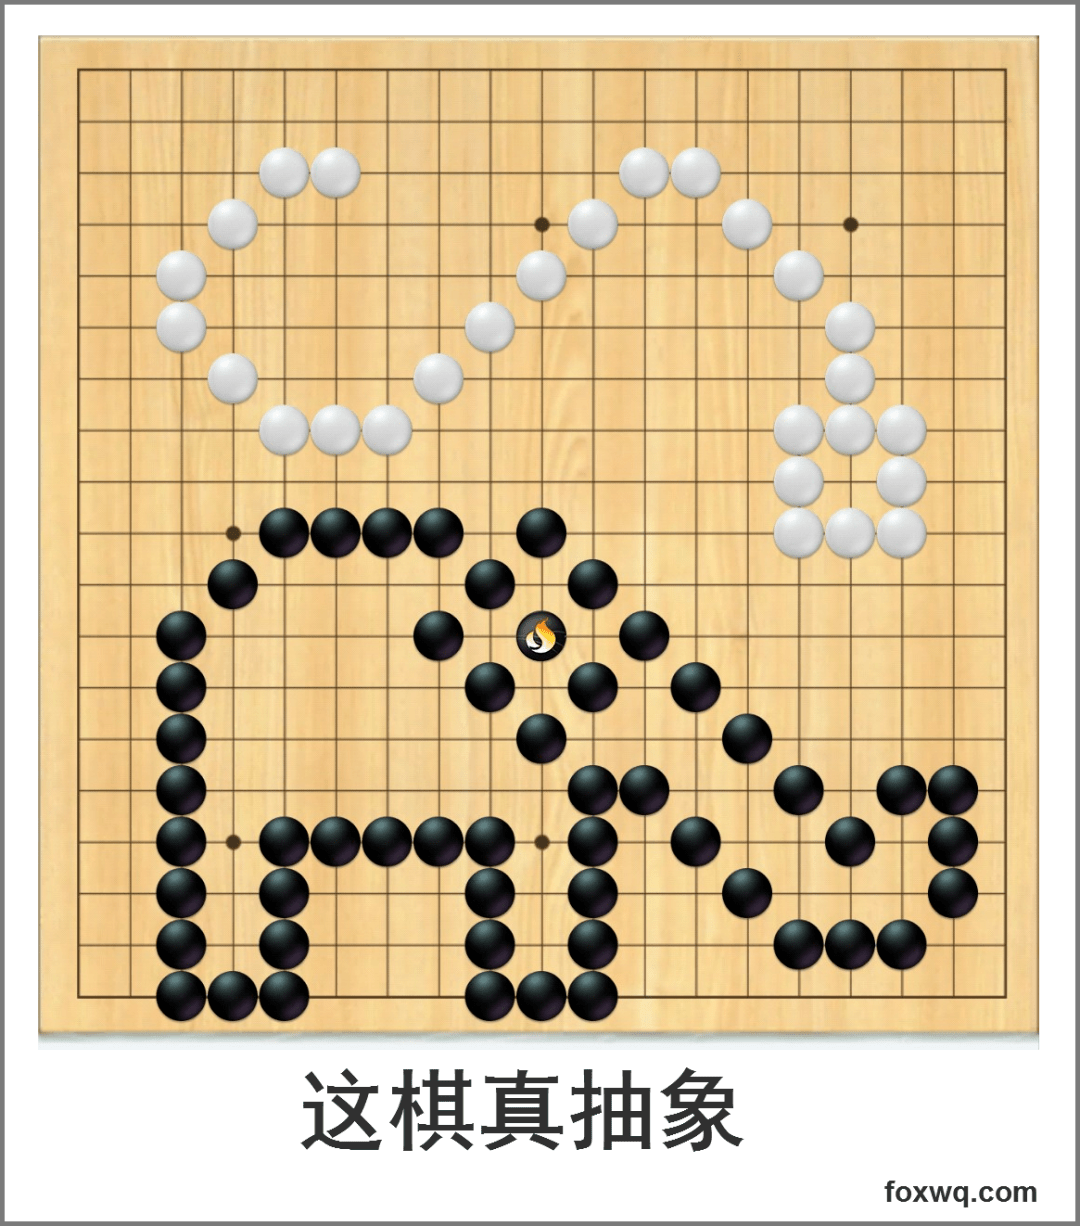
2023年了,您还在为下棋抽象难蚌苦苦煎熬吗?您还在为身处等级边缘艰难挣扎吗?这个秋天,野狐围棋重磅推出记谱研究功能!助您“一飞冲天”!实力强大算力精深,从八冠到三岁雅俗共赏!观战打谱摆棋研究,围棋世界轻松入室登堂!胜率精准变化全面,拒绝技不如人落泪破防!更多选点开拓思路,涨棋升段不再白日空想!任意盘面具体建议,棋海无涯从此告别抽象!手机使用方便快捷,秒变棋友中的“上等马”(APP新版即将上线,敬请期待)心动不如行动,记谱分析搭载绝艺引擎,不要299,拥有绝艺积分即可使用,再也不用自己买显卡装电脑啦!现在
随着人工智能技术的发展,强化学习作为一种重要的人工智能技术,已经被广泛应用于许多领域,例如控制系统、游戏等。Python作为一种流行的编程语言,也提供了许多强化学习算法的实现。本文将介绍Python中常用的强化学习算法及其特点。Q-learningQ-learning是一种基于值函数的强化学习算法,它通过学习一个值函数来指导行为策略,使得智能体能够在环境中选
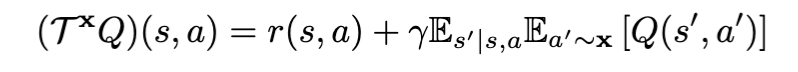
离线强化学习算法(OfflineRL)是当前强化学习最火的子方向之一。离线强化学习不与环境交互,旨在从以往记录的数据中学习目标策略。在面临数据收集昂贵或危险等问题,但是可能存在大量数据领域(例如,机器人、工业控制、自动驾驶),离线强化学习对比到在线强化学习(OnlineRL)尤其具有吸引力。在利用贝尔曼策略评估算子进行策略评估时,根据X的不同可以把当前的离线强化学习算法分为RL-based(x=π)和Imitation-based(x=μ),其中π为目标策略,μ为行为策略(注:目标
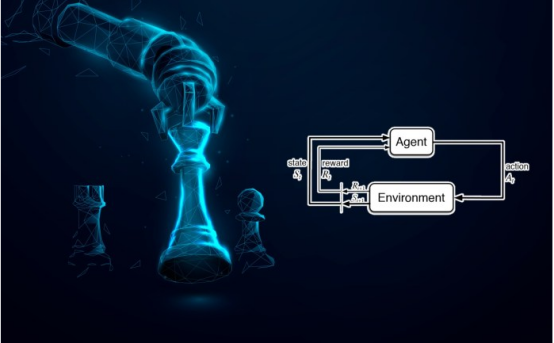
译者|李睿审校|孙淑娟可以想象一下,你正准备和朋友一起下国际象棋,但他并不是人类,而是一个不了解游戏规则的计算机程序。但这个应用程序却明白自己致力实现一个目标,就是在游戏中获胜。因为计算机程序不知道规则,所以开始下棋的招数是随机的。其中有些招数完全没有意义,而对你来说获胜很容易。在这里假设你非常喜欢和这个朋友下国际象棋,以至于沉迷于这个游戏。但计算机程序最终会获胜,因为它会逐渐学会击败你的方法和招数。虽然假设的这个场景看起来有些牵强,但它应该能让你对强化学习(机器学习的一个领域)的大致工作
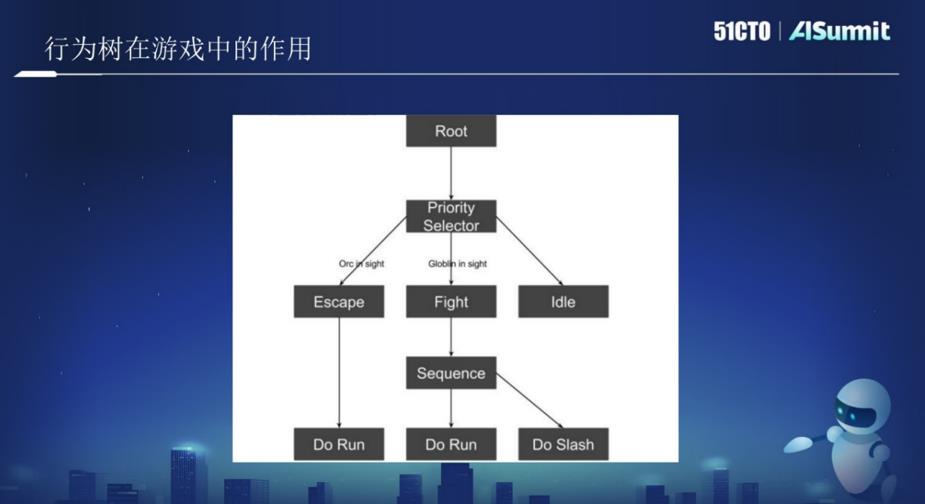
2022年8月6日-7日,AISummit全球人工智能技术大会如期举办。在7日下午举办的《人工智能前沿探索》分论坛上,西山居AI技术专家黄鸿波带来了《游戏中强化学习与行为树融合实战》的主题分享,详细分享了强化学习在游戏领域产生的价值。黄鸿波表示,强化学习技术的落地并不在于要把算法改得多牛,而是要将强化学习技术与深度学习、游戏策划相结合,形成一套完备的解决方案,并将其实现。强化学习让游戏更加智能强化学习在游戏中的落地,能够让游戏变得更加智能,可玩性变得更高,这就是在游戏中采用强化学习的主要目

近年来,强化学习(RL)在深度学习的带动下发展迅速,从游戏到机器人领域的各种突破,激发了人们对设计复杂、大规模RL算法和系统的兴趣。然而,现有RL研究普遍让智能体在面对新的任务时只能从零开始学习,难以利用预先获取的先验知识来辅助决策,导致很大的计算开销。而在监督学习领域,预训练范式已经被验证为有效的获得可迁移先验知识的方式,通过在大规模数据集上进行预训练,网络模型能够快速适应不同的下游任务上。相似的思路同样在RL中有所尝试,尤其是近段时间关于“通才”智能体[1,2]的研究,让人不

Sveltos简化了Kubernetes附加组件跨集群部署,基于集群运行时自动升级并提供事件驱动的工作流自动化框架。Kubernetes本身并不是一个完整的解决方案。要构建生产集群,您需要各种附加组件。如果您要管理多个集群,那不是一件容易的事。Sveltos是一个开源项目,它提供声明式API,允许跨多个Kubernetes集群部署Kubernetes附加组件。Helm图表和资源YAML都可以传递给Sveltos。例如,只需发布以下ClusterProfile实例就足以在一组托管集群中部署KyvernoHe

Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


