

Python强化学习入门:OpenAI Gym实战教程
强化学习通过试错调整策略,使程序在环境中学会完成任务。核心步骤包括:1.安装OpenAIGym环境,使用pip命令安装基础包或扩展包;2.创建环境如CartPole,调用gym.make并重置状态;3.与环境交互,随机或基于策略选择动作,执行后获取反馈;4.应用Q-learning算法训练agent,初始化Q表并按epsilon-greedy策略更新;5.评估agent性能,运行多轮测试并计算平均奖励;6.根据任务特性选择合适算法,如DQN、PolicyGradient等;7.调试和优化模型,调整超参数、
强化学习通过试错调整策略,使程序在环境中学会完成任务。核心步骤包括:1.安装OpenAI Gym环境,使用pip命令安装基础包或扩展包;2.创建环境如CartPole,调用gym.make并重置状态;3.与环境交互,随机或基于策略选择动作,执行后获取反馈;4.应用Q-learning算法训练agent,初始化Q表并按epsilon-greedy策略更新;5.评估agent性能,运行多轮测试并计算平均奖励;6.根据任务特性选择合适算法,如DQN、Policy Gradient等;7.调试和优化模型,调整超参数、探索策略、设计奖励函数等。掌握这些要点有助于实现和提升强化学习效果。

强化学习,听起来就很高大上,用Python来实现它,其实也没那么难。核心就是让你的程序(也就是agent)在一个环境中不断试错,然后根据结果调整策略,最终学会完成某个任务。OpenAI Gym就是一个提供各种环境的工具包,方便我们做强化学习实验。
掌握强化学习的关键在于理解基本概念,并能将其应用于实际问题。
用Python实现强化学习,离不开OpenAI Gym。
如何安装OpenAI Gym?
安装Gym非常简单,直接用pip就可以搞定:
pip install gym
如果你想玩一些更复杂的游戏,比如Atari游戏,还需要安装额外的依赖:
pip install gym[atari]
安装好之后,就可以开始你的强化学习之旅了!
如何创建一个简单的Gym环境?
Gym提供了各种各样的环境,比如经典的CartPole(小车倒立摆)、MountainCar(爬山车)等等。我们先从最简单的CartPole开始。
import gym

# 创建CartPole环境
env = gym.make('CartPole-v1')

# 重置环境,返回初始状态
state = env.reset()

# 渲染环境(可选,用于可视化)
env.render()

# 关闭环境
env.close()这段代码会创建一个CartPole环境,然后重置环境,返回初始状态。env.render()可以用来可视化环境,方便我们观察agent的行为。最后,记得用env.close()关闭环境,释放资源。
如何与Gym环境交互?
与Gym环境交互,就是让agent采取行动,然后观察环境的反馈。
import gym
import random

env = gym.make('CartPole-v1')
state = env.reset()

for _ in range(100):
    # 随机选择一个动作(0或1,分别代表向左或向右)
    action = env.action_space.sample()

    # 执行动作,返回新的状态、奖励、是否结束、额外信息
    next_state, reward, done, info = env.step(action)

    # 渲染环境
    env.render()

    # 如果游戏结束,重置环境
    if done:
        state = env.reset()
    else:
        state = next_state

env.close()这段代码会让agent随机采取100个动作,并渲染环境。env.action_space.sample()会随机返回一个有效的动作。env.step(action)会执行动作,并返回新的状态、奖励、是否结束、额外信息。如果done为True,说明游戏结束,我们需要重置环境。
如何用Q-learning算法训练一个CartPole agent?
Q-learning是一种经典的强化学习算法,它的核心思想是维护一个Q表,记录每个状态-动作对的价值。agent会根据Q表选择动作,并根据环境的反馈更新Q表,最终学会最优策略。
import gym
import numpy as np
import random

# 超参数
alpha = 0.1  # 学习率
gamma = 0.9  # 折扣因子
epsilon = 0.1 # 探索率
episodes = 1000 # 训练轮数

# 创建CartPole环境
env = gym.make('CartPole-v1')

# 初始化Q表
q_table = np.zeros([env.observation_space.shape[0], env.action_space.n])

# 训练
for i in range(episodes):
    state = env.reset()
    done = False
    while not done:
        # epsilon-greedy策略选择动作
        if random.uniform(0, 1) < epsilon:
            action = env.action_space.sample() # 探索
        else:
            action = np.argmax(q_table[int(state[0])]) # 利用

        # 执行动作
        next_state, reward, done, info = env.step(action)

        # 更新Q表
        old_value = q_table[int(state[0]), action]
        next_max = np.max(q_table[int(next_state[0])])
        new_value = (1 - alpha) * old_value + alpha * (reward + gamma * next_max)
        q_table[int(state[0]), action] = new_value

        # 更新状态
        state = next_state

env.close()

print("Q-table trained!")
这段代码实现了一个简单的Q-learning算法,用于训练CartPole agent。alpha是学习率,控制Q表更新的速度。gamma是折扣因子,控制未来奖励的重要性。epsilon是探索率,控制agent探索新动作的概率。在每一轮训练中,agent会根据epsilon-greedy策略选择动作,并根据环境的反馈更新Q表。
如何评估训练好的agent?
训练好agent之后,我们需要评估它的性能。
import gym
import numpy as np

# 创建CartPole环境
env = gym.make('CartPole-v1')

# 加载训练好的Q表(假设已经训练好并保存到文件)
# q_table = np.load('q_table.npy')

# 评估
episodes = 10
total_reward = 0

for i in range(episodes):
    state = env.reset()
    done = False
    episode_reward = 0
    while not done:
        # 选择最优动作
        action = np.argmax(q_table[int(state[0])])

        # 执行动作
        next_state, reward, done, info = env.step(action)

        # 累加奖励
        episode_reward += reward

        # 更新状态
        state = next_state

    # 累加总奖励
    total_reward += episode_reward
    print(f"Episode {i+1}: Reward = {episode_reward}")

# 计算平均奖励
average_reward = total_reward / episodes
print(f"Average Reward: {average_reward}")

env.close()
这段代码会运行10轮游戏,每轮都选择Q表中价值最高的动作,并记录每轮的奖励。最后,计算平均奖励,作为agent性能的指标。
如何选择合适的强化学习算法?
选择合适的强化学习算法,需要根据具体的任务和环境来考虑。Q-learning适合于离散状态空间和离散动作空间的问题。对于连续状态空间和连续动作空间的问题,可以考虑使用Deep Q-Network (DQN)、Policy Gradient、Actor-Critic等算法。
如何调试强化学习算法?
调试强化学习算法,需要仔细观察agent的行为,并分析其原因。可以尝试调整超参数,比如学习率、折扣因子、探索率等等。也可以尝试修改算法的实现,比如增加经验回放、目标网络等等。
如何提高强化学习算法的性能?
提高强化学习算法的性能,可以尝试以下方法:
- 特征工程: 选择合适的特征,可以帮助agent更好地理解环境。
- 探索策略: 使用更有效的探索策略,可以帮助agent更快地找到最优策略。
- 奖励函数: 设计合适的奖励函数,可以引导agent学习到期望的行为。
- 模型优化: 使用更强大的模型,可以提高agent的表达能力。
强化学习是一个充满挑战和机遇的领域。希望这篇文章能帮助你入门强化学习,并开始你的探索之旅!
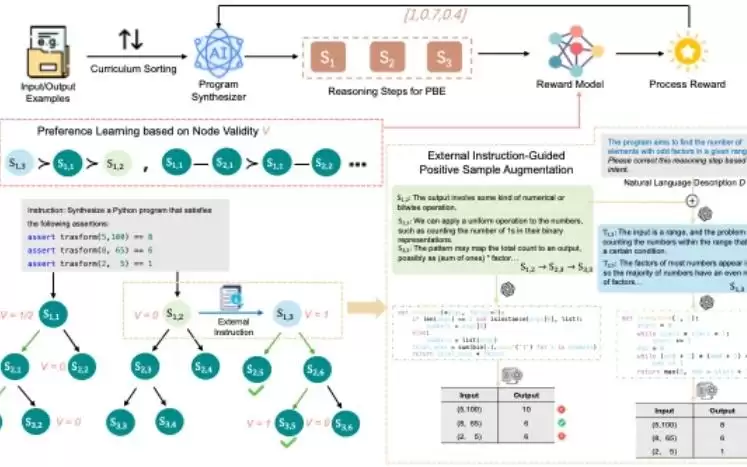
针对编程示例任务中缺乏过程监督的问题,提出PRM-PBE框架,通过反馈引导构建推理树生成过程监督数据,训练过程奖励模型评估中间推理步骤,并采用三阶段课程学习与PPO优化。在多个基准上,以DeepSeek-Coder-V2为基础模型,Pass@1提升至56.61%,显著优于现有方法。
6月29日,地平线正式推出了全场景辅助驾驶系统HSD V2.0版本。这不仅是HSD发布以来最大规模的OTA升级,更是一次从底层能力到用户体验的全方位进化——横跨6大维度,带来18项新增功能和25项体验优化。核心能力总结起来就八个字:“任意点到点,全维防碰撞”。可以说,这为一段式端到端系统持续进化,树
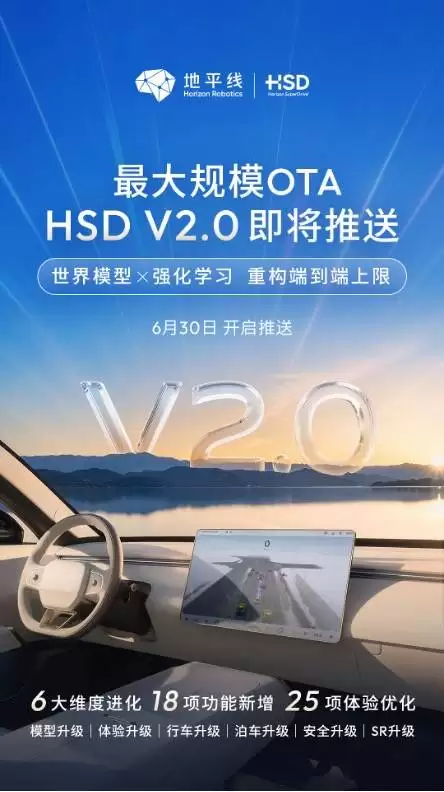
地平线HSDV2.0将端到端强化学习与世界模型深度整合,实现智驾从被动响应到主动预判的跨越。扩展OCC技术至AEB、AES等场景,统一底座模型精准识别各类障碍物。环境响应时延较行业均值快34%,77%用户主动选择该系统,智驾里程占比近50%,系统具备自主进化能力。
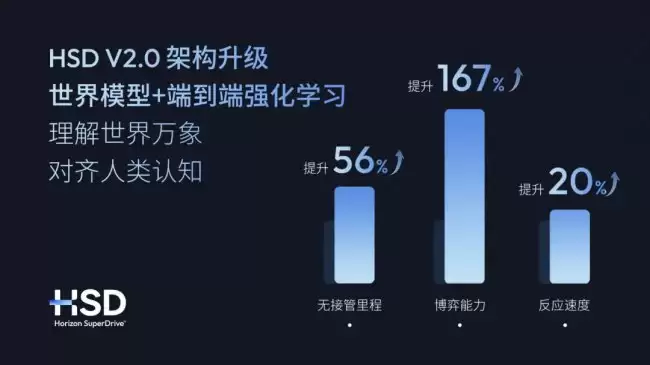
奇瑞iCARV27推送地平线HSDV2.0OTA升级,新增点对点智驾、全场景主动避险及高效泊车功能,征程6P芯片效率提升,支持AI定制SR皮肤。数据显示,77%用户选择HSD版本,智驾使用率达85.14%。
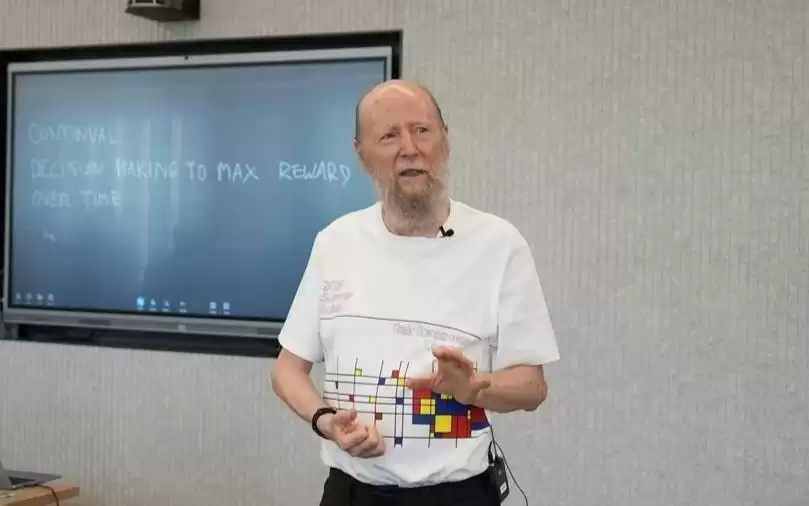
2024年图灵奖得主萨顿预测,2030年出现人类水平通用人工智能的概率为25%,届时仅需约1000美元即可获得人脑级算力。他呼吁回归智能本质研究,强调强化学习需通过实时交互实现长期收益最大化,而非依赖静态数据。
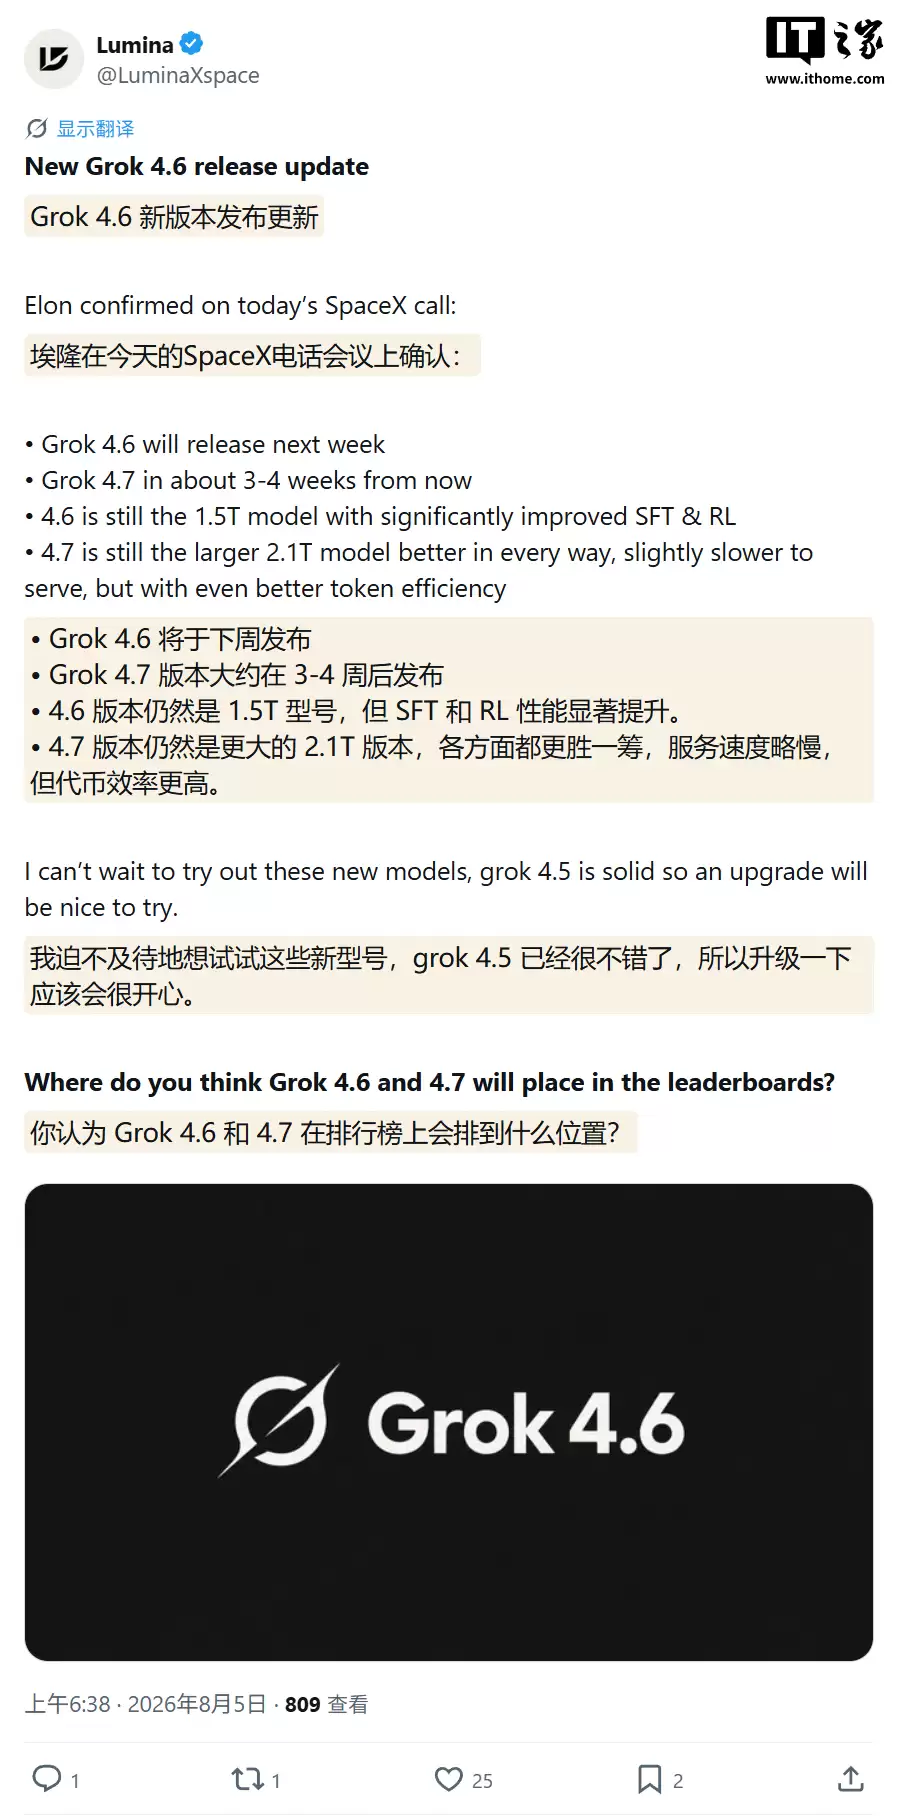
马斯克在SpaceX财报电话会上宣布,下周将发布Grok4.6模型,总参数量1.5万亿,重点优化监督微调与强化学习;同时预告未来3-4周推出Grok4.7模型,参数规模2.1万亿,综合性能更优。
CMake已成为现代C++工程基础设施,官方完善了学习资源,提供从入门到精通的系统化路径。Kitware提供培训和高级支持,针对构建系统迁移、优化及企业流程规范。学习资料应分层,结合工具使用、工程规范与CI流程,以发挥CMake价值。
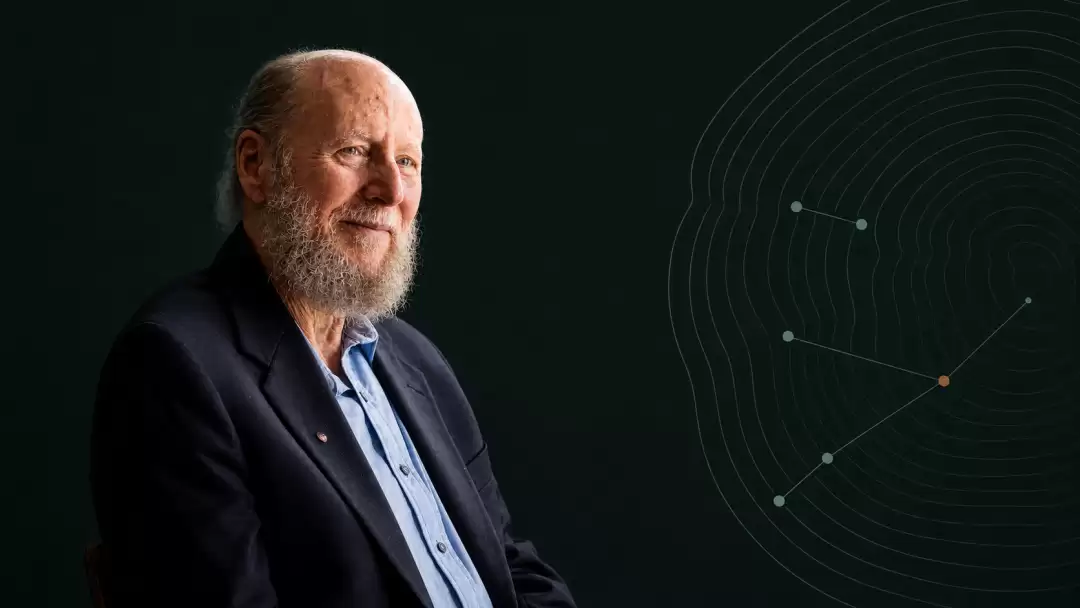
强化学习之父RichardSutton宣布创立OakLab,旨在打造能从自身经验持续学习、实时进化的AI系统,挑战当前大语言模型范式。他认为LLM依赖人类数据而非经验,真正的智能需通过试错产生新发现。OaK架构基于选项与知识,但面临灾难性遗忘等技术瓶颈。
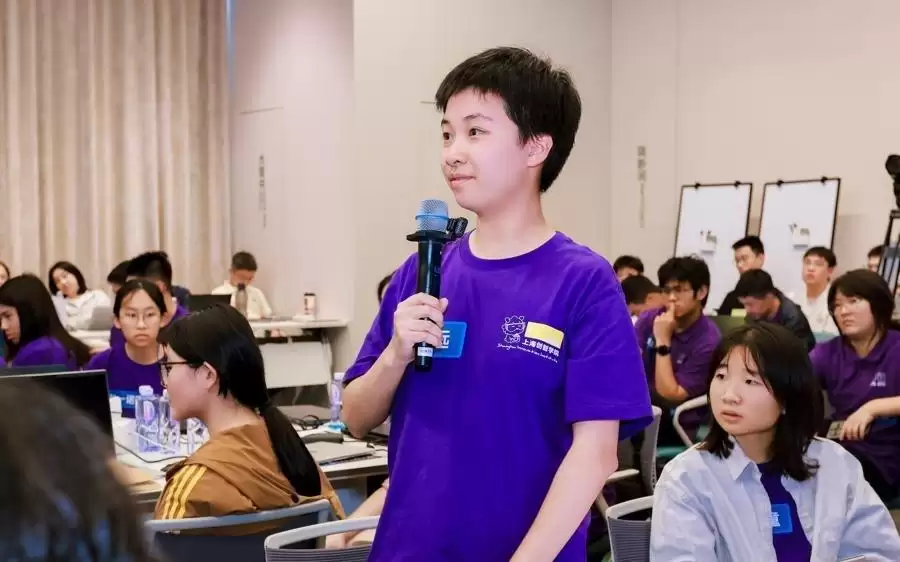
先说个有意思的场景:7月23日下午2点,上海创智学院102多功能厅外,63位少年早已坐得笔直,眼神里满是期待和兴奋。当一位穿着花衬衫的熟悉身影出现在门口时,掌声毫无预兆地炸开了。 来的是理查德·萨顿——“强化学习之父”,2024年图灵奖得主。刚刚结束2026年世界人工智能大会的紧张日程,他把半小时的
新京报贝壳财经讯 6月15日,均普智能放了个大招——旗下宁波具身智能机器人创新中心、博登智能和上海交通大学MINT实验室联手,正式开源了全球首个面向真实机器人强化学习(RW-RL)的大规模数据集RW-RL-Dataset首批数据。这事儿在圈内引起了不小的关注。 这个数据集打破了传统机器人数据只记录“





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



