

离线强化学习新范式!京东科技&清华提出解耦式学习算法
离线强化学习算法(OfflineRL)是当前强化学习最火的子方向之一。离线强化学习不与环境交互,旨在从以往记录的数据中学习目标策略。在面临数据收集昂贵或危险等问题,但是可能存在大量数据领域(例如,机器人、工业控制、自动驾驶),离线强化学习对比到在线强化学习(OnlineRL)尤其具有吸引力。在利用贝尔曼策略评估算子进行策略评估时,根据X的不同可以把当前的离线强化学习算法分为RL-based(x=π)和Imitation-based(x=μ),其中π为目标策略,μ为行为策略(注:目标
离线强化学习算法 (Offline RL) 是当前强化学习最火的子方向之一。离线强化学习不与环境交互,旨在从以往记录的数据中学习目标策略。在面临数据收集昂贵或危险等问题,但是可能存在大量数据领域(例如,机器人、工业控制、自动驾驶),离线强化学习对比到在线强化学习(Online RL)尤其具有吸引力。
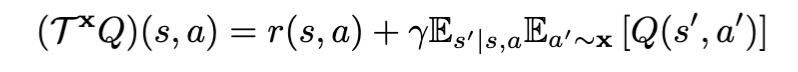
在利用贝尔曼策略评估算子进行策略评估时,根据 X 的不同可以把当前的离线强化学习算法分为 RL-based (x=π)和 Imitation-based (x=μ), 其中π为目标策略,μ为行为策略 (注:目标策略:进行学习更新的策略;行为策略:离线数据中的策略)。当前,不管是 RL-based 还是 Imitation-based, 都有各自优势以及劣势:
1.RL-based 优势:可以进行数据外的泛化,最后达到学习到超越行为策略的目标策略。劣势:需要在策略评估中准确的价值估计(更多的行为正则化)和策略提升(更少的行为正则化)之间进行权衡。在策略评估过程中,如果选取了数据分布外的动作,无法准确估计动作价值函数(action-state value),最后导致的目标策略学习失败。
2.Imitation-based 优势:因为在策略评估的过程中都是数据分布内的动作,既可以带来训练的稳定性,又避免了数据分布外的策略评估,可以学习到接近行为策略库中最好的策略。劣势:因为都是采取数据分布内的动作,所以很难超越原数据中存在的行为策略。
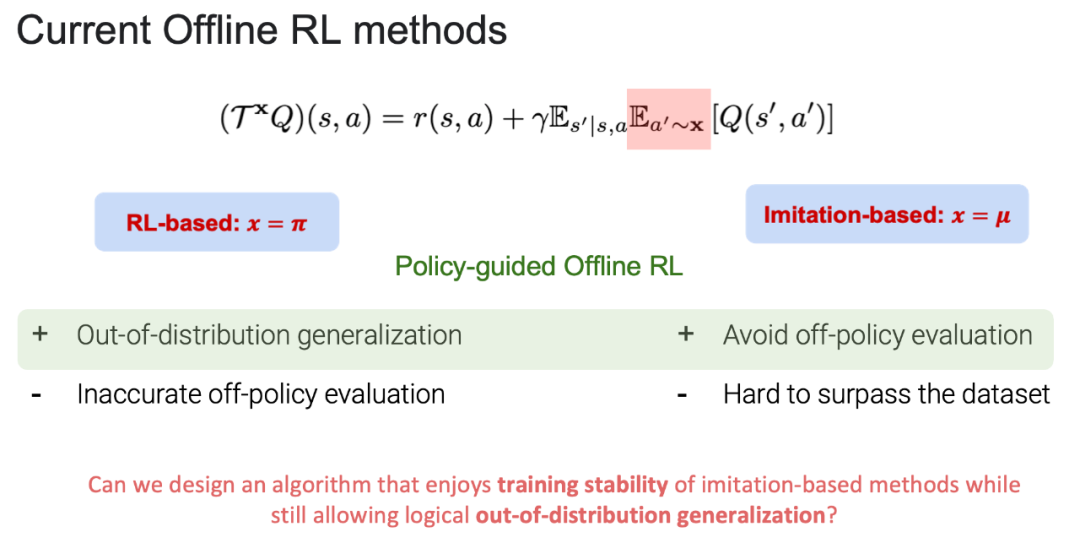
POR 基于此,既能避免策略评估过程中的权衡,也能拥有数据外泛化的能力。该工作已被 NeurIPS 2022 接收,并被邀请进行口头汇报(oral presentation)论文和代码均已开源。
- 论文:https://arxiv.org/abs/2210.08323
- 代码:https://github.com/ryanxhr/POR
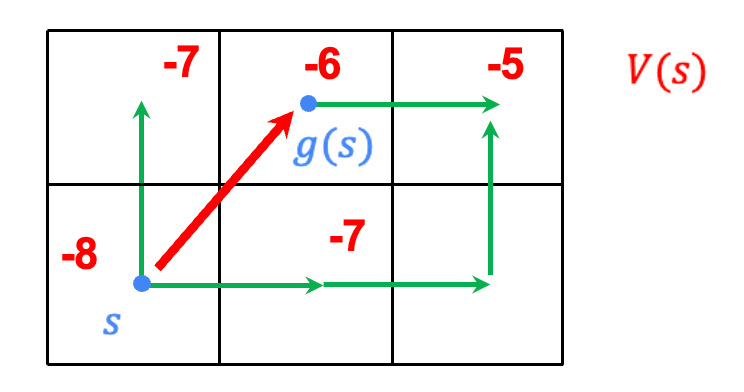
state-stitching vs. action-stitching
- 任务:走格子,终点在右上角,起点在右下角。找到最短从起点到终点的路径。
- 规则:智能体可以在任何一个格子选择它周围的八个格子,走到终点给与奖励 1,其他所有的行为奖励都是 0。
- 数据:绿色的行走路径是已有的路径数据。
之前的 imitation-based 算法都是使用 action-stitching: 拼凑数据中可用的轨迹以达到目标策略的学习。如视频中蓝色的轨迹,是在 action-stitching 下能够学习到的最好轨迹,但是在数据外无法进行有效的泛化,从而学习到超越数据中行为策略的目标策略。但是,POR 通过解耦式的学习范式,能够让目标策略进行有效的泛化,从而超越行为策略的表现。
如何实现 state-stitching?
Policy-guided Offline RL (POR)的学习过程分为三步,这三步是分别解耦的,互不影响。值得注意的是,POR 全程都是基于 imitation-based 的学习,也就是样本内的学习(in-sample learning),不会对数据分布外的动作进行价值评估。
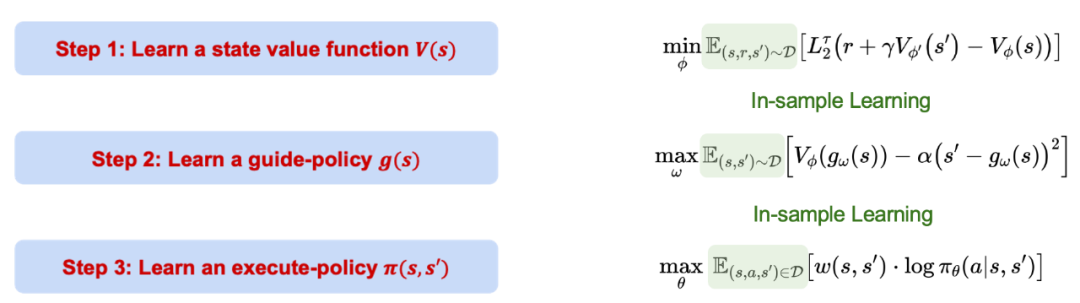
1. 利用分位数回归学习价值函数的置信上界。
2. 利用已经学习到的价值函数学习指导策略,该指导策略可以在给定当前的状态下,生成到样本内的下一步最优的状态位置(s')。后面一项作为约束项保证生成的状态满足 MDP 条件。
3. 利用数据中所有的样本进行学习一个执行策略,该执行策略在给定当前状态(s)和下一步的状态 (s') 之后,能够采取正确的动作从当前状态(s)移动到下一步状态(s')。
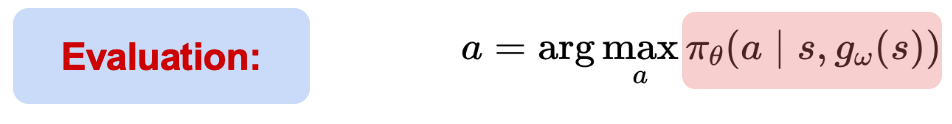
在测试过程,根据当前状态信息(s),先通过指导策略给出下一步的最优状态(s')。
给定(s, s'),执行策略能够进行动作选取和执行。虽然 POR 的整个学习过程都是样本内的学习,但是可以利用神经网络的泛化性能进行数据外的泛化学习,最后实现 state-stitching。
实验
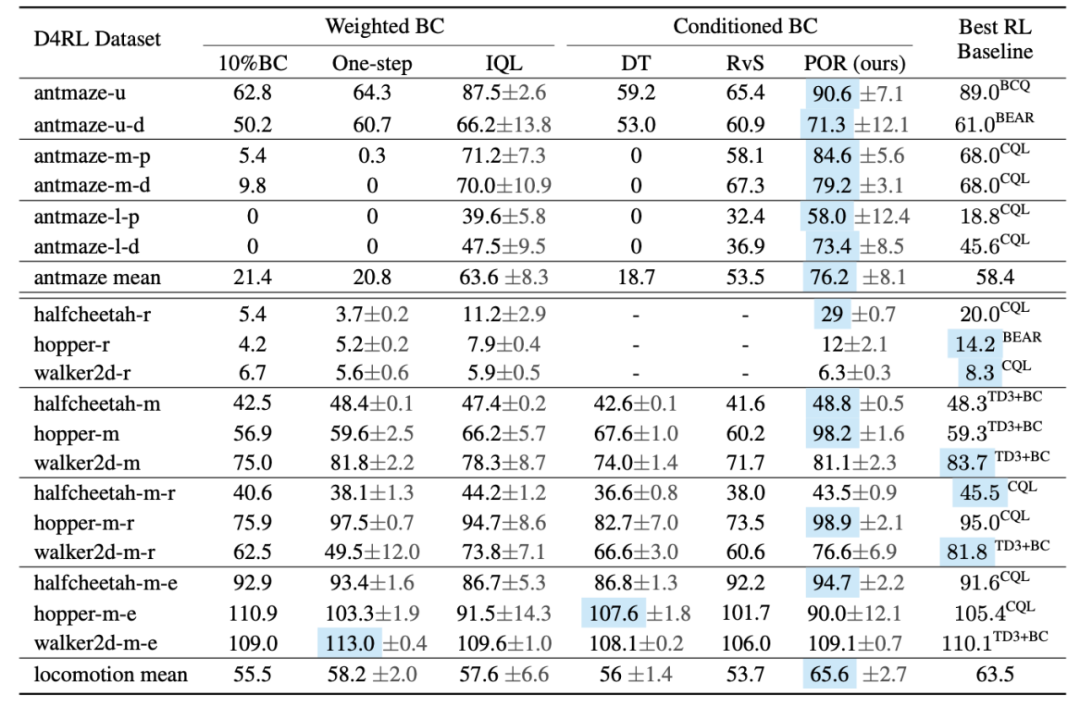
作者对比了 POR 和其他算法在 D4RL Benchmark 上的表现。从表格来上看,POR 在次优数据上的表现非常亮眼,在具有更大难度 Antmaze 任务上的表现均取得最优的算法性能。
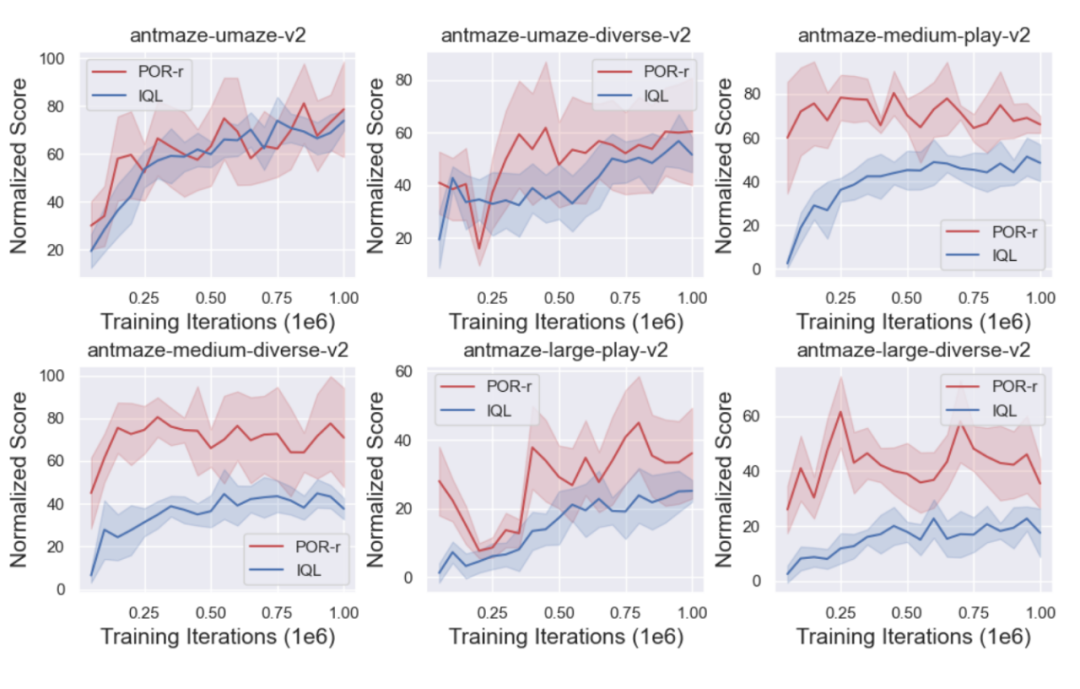
同时,作者对比了 POR(state-stitching) 和 IQL(action-stitching)的训练曲线,以表现 state-stitching 的优势。
解耦有哪些额外的好处
1. 重新学习指导策略以实现算法的性能提高。
真实的世界中往往存在⼤量的次优甚⾄随机的数据集 (D_o),如果直接引入到正在学习的原始数据集 (D_e) 上可能会导致学到⼀个较差的策略,但是对于解耦式学习算法来讲,针对到不同的组件,学习不同的数据集来提升表现。在学习价值函数的时候往往是越多的数据集越好,因为可以把价值函数可以学得更准确;相反,策略的学习是不希望引入 (D_o)。
作者对比了三个不同的算法在不同训练场景下的表现:
1. Main : 在原始数据集上 (D_e) 进行学习,不引入额外次优数据集。
2. More:把原始数据集 (D_e) 和新数据集(D_o)进行混合,作为新的数据集进行学习。
3. Mix: 对于解耦的算法,对于不同的学习部分,可以用不同的数据集进行学习,所以只有 POR 可以有 Mix 的学习范式。
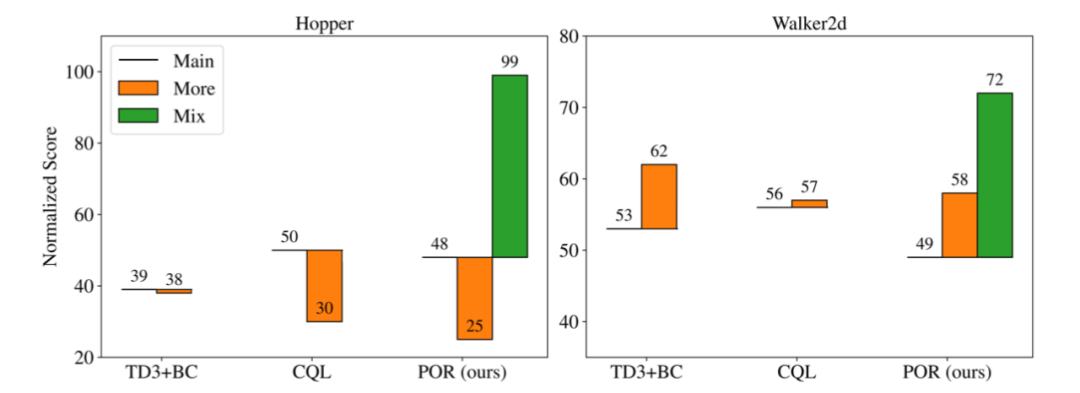
从上图可以看到,当加入新的次优数据一起训练过后(More),可能会导致比原来的只用原始数据集(Main)表现更好或者更差,但是针对到可以解耦的训练形式,用以 (D_o+D_e) 重新学习指导策略,作者实验说明了更多的数据可以增强指导策略的择优性和泛化能力,同时保持行为策略不变,从而实现了执行策略的提升。
4. 当面对新任务的时候,因为执行策略是和任务无关的,只需要重新学习指导策略。
为此,作者提出了三个任务分别是 (a): four-room: 要求 agent 从绿色方块到红色方块。(b) 除了完成任务(a) 之外,要求 agent 不能触碰河流。(c)除了完成任务(a),(b)之外,要求 agent 必须获得钥匙才算完成任务。
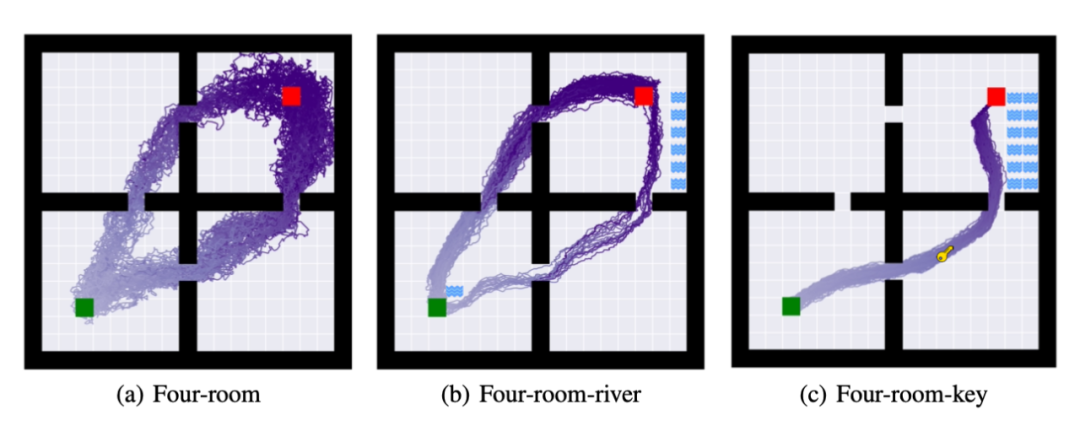
上图,是完成策略学习之后,对策略进行 50 次的 rollout 的轨迹,在任务 (b) 和任务 (c) 作者沿用任务 (a) 的执行策略,只重新学习了指导策略。从上图可以看出,解耦的学习方式可以在使用尽可能少的计算资源之下,完成任务的迁移。
针对编程示例任务中缺乏过程监督的问题,提出PRM-PBE框架,通过反馈引导构建推理树生成过程监督数据,训练过程奖励模型评估中间推理步骤,并采用三阶段课程学习与PPO优化。在多个基准上,以DeepSeek-Coder-V2为基础模型,Pass@1提升至56.61%,显著优于现有方法。
6月29日,地平线正式推出了全场景辅助驾驶系统HSD V2.0版本。这不仅是HSD发布以来最大规模的OTA升级,更是一次从底层能力到用户体验的全方位进化——横跨6大维度,带来18项新增功能和25项体验优化。核心能力总结起来就八个字:“任意点到点,全维防碰撞”。可以说,这为一段式端到端系统持续进化,树
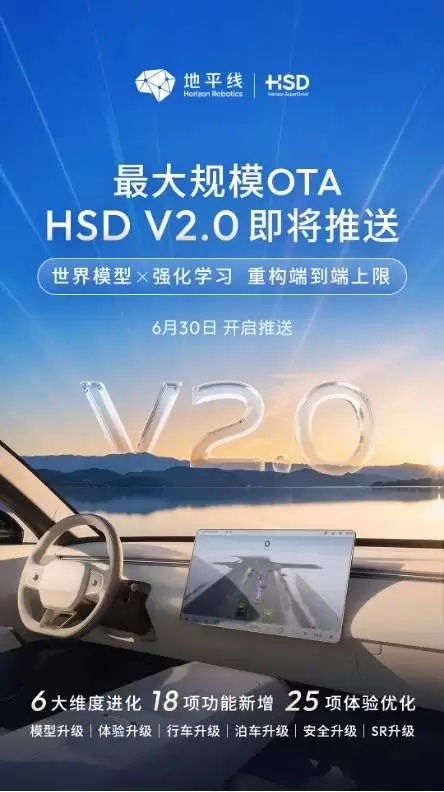
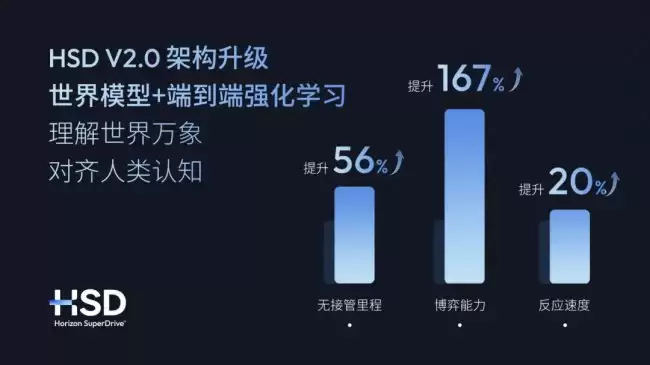
地平线HSDV2.0将端到端强化学习与世界模型深度整合,实现智驾从被动响应到主动预判的跨越。扩展OCC技术至AEB、AES等场景,统一底座模型精准识别各类障碍物。环境响应时延较行业均值快34%,77%用户主动选择该系统,智驾里程占比近50%,系统具备自主进化能力。
奇瑞iCARV27推送地平线HSDV2.0OTA升级,新增点对点智驾、全场景主动避险及高效泊车功能,征程6P芯片效率提升,支持AI定制SR皮肤。数据显示,77%用户选择HSD版本,智驾使用率达85.14%。
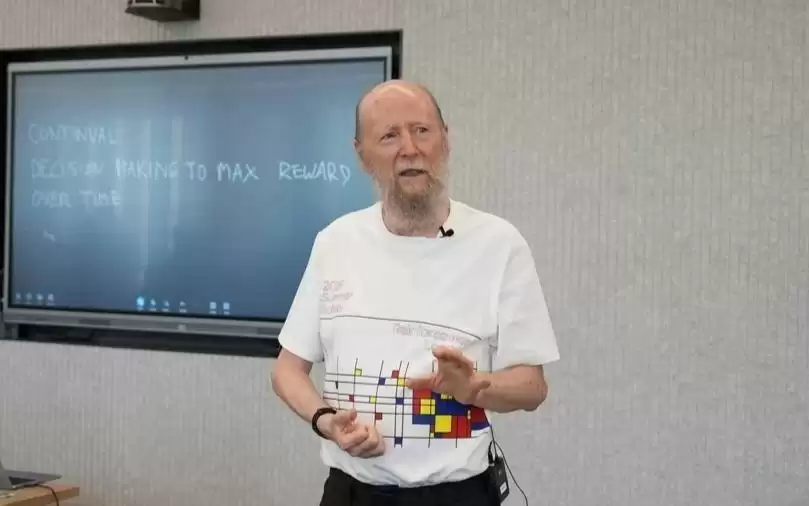
2024年图灵奖得主萨顿预测,2030年出现人类水平通用人工智能的概率为25%,届时仅需约1000美元即可获得人脑级算力。他呼吁回归智能本质研究,强调强化学习需通过实时交互实现长期收益最大化,而非依赖静态数据。

马斯克在SpaceX财报电话会上宣布,下周将发布Grok4.6模型,总参数量1.5万亿,重点优化监督微调与强化学习;同时预告未来3-4周推出Grok4.7模型,参数规模2.1万亿,综合性能更优。

CMake已成为现代C++工程基础设施,官方完善了学习资源,提供从入门到精通的系统化路径。Kitware提供培训和高级支持,针对构建系统迁移、优化及企业流程规范。学习资料应分层,结合工具使用、工程规范与CI流程,以发挥CMake价值。

强化学习之父RichardSutton宣布创立OakLab,旨在打造能从自身经验持续学习、实时进化的AI系统,挑战当前大语言模型范式。他认为LLM依赖人类数据而非经验,真正的智能需通过试错产生新发现。OaK架构基于选项与知识,但面临灾难性遗忘等技术瓶颈。

先说个有意思的场景:7月23日下午2点,上海创智学院102多功能厅外,63位少年早已坐得笔直,眼神里满是期待和兴奋。当一位穿着花衬衫的熟悉身影出现在门口时,掌声毫无预兆地炸开了。 来的是理查德·萨顿——“强化学习之父”,2024年图灵奖得主。刚刚结束2026年世界人工智能大会的紧张日程,他把半小时的
如今,电子手表越来越受到人们的青睐,因为它不仅外观时尚,功能也非常强大,尤其在健康监测方面表现出色。小米手环凭借出色的性价比和实用的功能,成为众多用户的首选。而想要更好地使用小米手环,搭配“小米运动健康”这款APP是必不可少的,建议大家尽快下载使用。如何通过小米运动健康同步微信步数:进入微信-“我”-“设置”-“设备”-选择“手环”,点击右上角“…”开启“同步运动数据至微信运动”若在设置中没有看到“设备”选项,请按以下步骤操作:打开小米运动健康APP-“我的”-“三方数据管理”-“微信运动”设置如果发现微






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
