

火车头采集器深度设置技巧
一、通过分页与多级网址获取设置深度,明确层级规则;二、利用网址过滤排除深层链接,防止采集无关页面;三、通过自定义脚本编程控制采集行为,实现精准深度限制。
一、通过分页与多级网址获取设置深度,明确层级规则;二、利用网址过滤排除深层链接,防止采集无关页面;三、通过自定义脚本编程控制采集行为,实现精准深度限制。
如果您希望在使用火车头采集器时精确控制数据抓取的范围,避免采集到无关的深层页面,则需要对采集深度进行限制。以下是实现层级控制的具体操作方法:
一、通过分页与多级网址获取设置深度
此方法适用于需要采集列表页下的文章页等固定层级结构的网站。通过明确指定网址匹配规则和层级关系,可以有效控制采集的深度。
1、在火车头采集器中创建新任务后,进入“高级模式”下的“多级网址获取”设置界面。
2、添加第一级网址规则,通常为网站的栏目列表页,例如:http://www.example.com/news/list_\d+.html,并设置该级别为“第1层”。
3、点击“添加子规则”,配置第二级网址规则,用于匹配文章详情页链接,例如:http://www.example.com/news/\d+.html,并将其设置为“第2层”。
4、若需采集更多层级(如评论页),可继续添加子规则,并递增层级编号;若仅需采集到文章页,则不再添加后续层级。
5、确保在“内容采集”部分只针对最后一层(如第2层)的页面编写标题、正文等字段的采集规则。
二、利用网址过滤功能排除深层链接
当目标网站的URL具有一定规律时,可通过过滤特定模式的网址来间接实现深度限制,防止采集器进入不希望抓取的深层目录。
1、在任务设置的“网址获取选项”或“网址过滤”区域找到相关设置入口。
2、选择“反向匹配”或“排除包含以下内容的网址”功能。
3、根据网站结构分析深层页面的URL特征,例如深层路径可能包含/subdir/或特定ID段,将这些特征词加入排除列表。
4、对于以数字ID表示层级的网站,可使用正则表达式限定ID范围,如排除ID大于五位数的链接,以规避深层归档页面。
5、保存过滤规则并进行测试,确保只有符合深度要求的网址被成功捕获。
三、在自定义脚本中编程控制采集行为
对于复杂的动态网站或AJAX加载内容,标准的层级设置可能无法满足需求,此时可通过编写自定义脚本来精确控制采集深度。
1、在任务的“高级设置”中启用“自定义JS脚本”或“插件扩展”功能。
2、编写JavaScript代码,在页面加载后判断当前URL所属的层级,可通过分析URL路径的斜杠数量或特定参数确定。
3、当检测到当前页面深度超过预设值(如超过2层)时,使用脚本指令中断本次采集流程,例如返回空数据或跳过该链接。
4、对于需要动态请求的场景,可在发送AJAX请求前插入深度判断逻辑,仅允许符合条件的请求发出。
5、调试并运行脚本,验证其能否准确阻止超出深度限制的页面被抓取。
首先在LocoySpider中设置导出格式为JSON,进入数据导出选项卡并选择JSON格式;接着配置字段映射,为每个采集字段指定如"title"、"url"等JSON键名;然后可选启用数组包装和对象嵌套,勾选“将每条记录封装为JSON对象”并开启“导出为JSON数组”功能;最后点击“导出数据”按钮,选择保存路径并将文件保存为.json格式,完成结构化输出。
可通过Wine兼容层在Linux运行火车头采集器:先安装Wine,下载Windows版安装包,使用wine命令安装并运行程序;可结合nohup后台运行,或通过Docker容器部署集成Wine环境的镜像,在容器内操作;为实现自动化,可编写Shell脚本调用Wine加载采集项目,并用cron定时执行,输出日志至文件便于监控。
通过火车头采集器创建自定义采集规则模板可高效提取结构化数据,具体流程包括:一、新建项目并配置目标网站基本信息;二、设置列表页抓取规则,定位条目链接与分页逻辑;三、定义详情页字段抽取规则,映射标题、时间、内容等字段并启用资源下载;四、针对动态内容使用高级脚本模式编写自定义采集逻辑,规避反爬机制;五、测试采集结果后导出为.lsb模板文件以便复用。
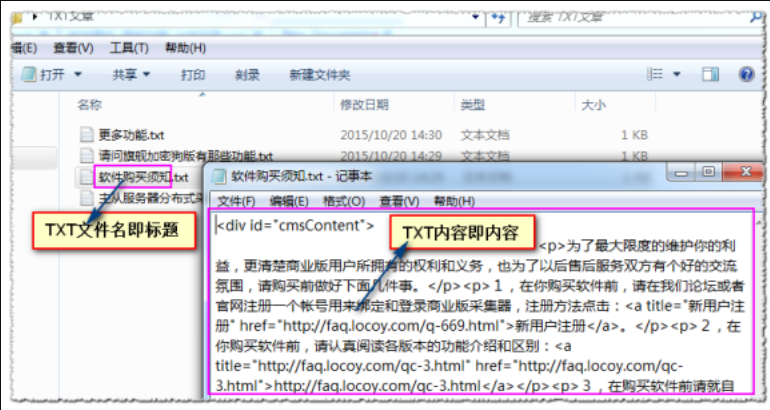
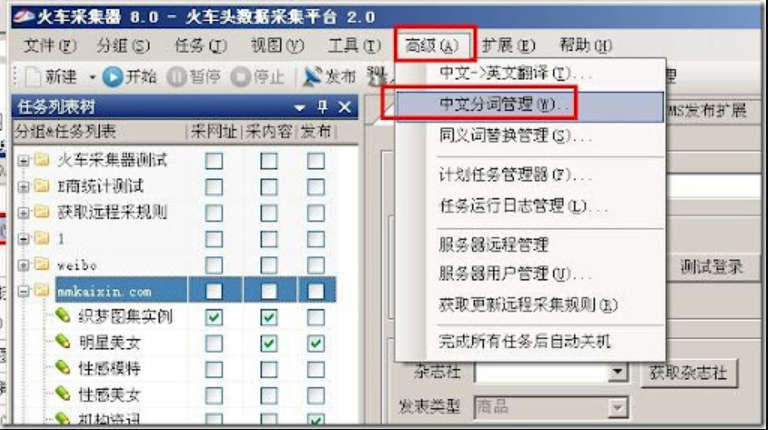
首先配置MySQL连接并创建数据库,然后设计包含适当数据类型和索引的表结构,接着在LocoySpider中将采集字段映射到MySQL列,最后启动导出任务并监控日志确保数据完整写入。
启用多线程采集可提升火车头采集器效率,需在发布或采集设置中开启多线程并合理配置线程数(建议5-20),根据硬件性能调整至8-12或15-20;设置请求间隔500-1000毫秒、超时时间10-15秒及重试2-3次以增强稳定性;结合代理IP池并启用自动切换功能避免IP封禁;优化数据库写入,采用本地存储与批量提交(如每100条)减少I/O开销,关闭冗余日志降低磁盘压力。
首先检查视频链接是否通过正则或XPath准确提取,再根据网站类型选择静态解析、动态加载模拟、插件辅助或手动构造路径的方式获取真实URL,最终配置下载规则实现采集。
答案:为解决LocoySpider导出CSV格式混乱问题,应正确设置分隔符。一、使用内置导出功能时选择“CSV格式(逗号分隔)”,默认以英文逗号分隔字段;二、自定义分隔符可在项目设置中启用“文本文件(可设置分隔符)”,指定分号或竖线等符号,并用双引号包围文本;三、通过数据库中转,将数据导入SQLite或MySQL后,用Navicat等工具导出为标准CSV;四、若Excel显示异常,需用记事本另存为UTF-8或ANSI编码,并在Excel中通过“从文本导入”手动指定分隔符完成解析。
遇到验证码阻挡时,可通过集成打码平台API、本地OCR识别、深度学习模型或浏览器插件实现自动处理。一、使用若快、云打码等平台API,配置AppID、AppKey及验证码类型,提取图片并提交识别结果填入表单。二、对简单验证码采用TesseractOCR本地识别,需预处理图像并调用pytesseract解析文字。三、针对复杂验证码训练CNN或CRNN模型,部署为本地服务后由LocoySpider调用完成高精度识别。四、启用人工干预模式,程序暂停等待用户输入验证码后再继续执行,适用于低频或备用方案。
使用LocoySpider可高效批量采集新闻内容。首先配置“采集网址”规则,通过批量多页模式生成列表页分页链接并提取详情页URL;接着用前后截取法提取标题和正文,设置HTML标签起止符并排除冗余标签;对于JS动态内容,切换为正则表达式模式,编写如'title':\s'(1)'等规则精准捕获数据,并通过【测试该页】验证;最后针对分页新闻启用【多页内容合并】,提取“下一页”链接并设置拼接顺序与去重规则,确保文章完整性。'↩





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



