

怎样在Python中实现数据的增量同步到数据库_基于时间戳对比算法
时间戳增量同步易因时区混用和字段类型不一致出错。应统一使用UTC时间,通过原子化状态管理保存同步点,并采用兜底机制应对时钟漂移与批量更新。查询时需锁定时间窗口、稳定排序,必要时引入辅助序列比对,以防止数据遗漏或重复。
时间戳增量同步易出错主因是时区混用与字段类型不一致;应统一用UTC时间、原子化状态管理、加兜底机制防时钟漂移和批量更新导致漏同步。
为什么用时间戳做增量同步容易出错
时间戳这个工具,乍一看简单直接,但真正用起来,最容易掉进去的坑就是时区问题。具体来说,是timezone-aware(时区感知)和timezone-naive(时区不感知)对象的混用。举个例子,你在Python里用datetime.now(),拿到的是本地时区的时间对象,但像PostgreSQL这类数据库,默认存储的是UTC时间。两边一比对,数据要么漏了,要么就被重复写进去。
另一个更隐蔽的陷阱,是数据库字段类型的不一致。TIMESTAMP WITHOUT TIME ZONE 和 TIMESTAMP WITH TIME ZONE,别看名字就差几个单词,底层处理逻辑天差地别。即便数值看起来一模一样,数据库管理系统也可能在背后进行静默的类型转换,导致比较结果出人意料。
那具体该怎么避坑呢?这里有几个经过实践检验的建议:
- 统一源头:生成同步起始时间时,别用
datetime.now(),改用datetime.utcnow().replace(tzinfo=timezone.utc),从一开始就锁定UTC时区。 - 强制解析:从数据库查询时间字段时,明确指定用UTC时区来解析。比如在使用SQLAlchemy时,可以加上
type_=postgresql.TIMESTAMP(timezone=True)这样的参数。 - 动态锚点:首次同步前,先执行一次
SELECT MAX(updated_at) FROM table来获取真实的最新时间戳。千万别想当然地硬编码一个“1970-01-01”作为起点,历史数据量可能远超你的想象。
如何写一个安全的增量查询SQL模板
增量查询的核心,远不止是“查找大于某个时间点”的数据那么简单。真正的关键在于:查询大于等于上一次同步的最大时间戳,并且要排除掉已经处理过的记录ID,以防重复。如果不这么做,一旦遇到并发写入或者服务器时钟回拨,丢数据几乎是必然的。
这里有一个结合了PostgreSQL和SQLAlchemy的实用模板:
SELECT id, data, updated_at FROM my_table WHERE updated_at >= %(last_sync_time)s AND updated_at < %(current_sync_time)s ORDER BY updated_at, idLIMIT 1000
使用这个模板时,有几个细节必须盯紧:
- 时间窗口要锁死:
%(current_sync_time)s必须是本次同步操作开始的那个瞬间,而不是整个脚本启动的时间。务必在每次查询前,用datetime.now(timezone.utc)实时获取。 - 排序要稳定:
ORDER BY updated_at, id这个组合拳很重要。单靠updated_at排序,如果同一毫秒有多条记录更新,分页时顺序就可能乱套。 - 精度可以更高:如果业务条件允许,强烈建议把上次同步的最后一条记录的ID也记录下来。这样,下次查询条件就可以升级为
WHERE (updated_at, id) > (%(last_time)s, %(last_id)s),精准度直接拉满。
Python里怎么可靠保存和读取上次同步时间
千万别把last_sync_time这类关键状态信息随便写进本地文件。一旦遇到多实例部署、容器重启或者网络存储延迟,状态错乱会让你查都没地方查。可靠的做法,是必须把状态持久化到数据库,或者使用专门的外部协调服务。
一个被广泛采用的推荐方案是:单独建一张sync_state表。这张表至少需要包含table_name(表名)、last_sync_time(上次同步时间)和一个会自动更新的updated_at字段。
CREATE TABLE sync_state ( table_name TEXT PRIMARY KEY, last_sync_time TIMESTAMP WITH TIME ZONE NOT NULL, updated_at TIMESTAMP WITH TIME ZONE DEFAULT NOW());
而读写这张表的逻辑,原子性是生命线:
- 读操作:直接使用
SELECT last_sync_time FROM sync_state WHERE table_name = 'my_table'。 - 写操作(这是关键):务必使用类似
INSERT INTO sync_state ... ON CONFLICT (table_name) DO UPDATE SET ...这样的UPSERT语句。一次操作完成插入或更新,避免竞态条件。 - 绝对要避免:先
SELECT查出来,再根据结果决定INSERT或UPDATE。在并发环境下,这很可能覆盖掉其他进程刚刚写入的新值。
遇到时钟漂移或批量更新怎么办
现实世界从来不会完全按照代码的假设运行。服务器时钟可能不准,ETL任务可能卡住,上游系统也可能为了修复数据而批量刷写updated_at字段。这些情况都会导致时间戳“倒流”或“跳变”,让基于时间的增量同步漏掉数据。
应对这类问题,最高效的策略不是去强行校准所有时钟(这往往不现实),而是在系统设计层面增加兜底机制:
- 设置偏差告警:每次同步完成后,记录下本次实际扫描到的
MAX(updated_at),并与同步开始时的current_sync_time进行比对。如果两者差值超过一个合理的阈值(比如5分钟),就触发告警,由人工介入核查。 - 引入辅助序列:对于数据一致性要求极高的场景,可以额外维护一个单调递增的
version或sequence_id字段。判断逻辑可以升级为:“先比较时间戳,时间戳相同则比较版本号”。 - 准备降级方案:如果发现某条数据的
updated_at竟然比上次记录的last_sync_time还要小,不要简单地跳过。这时候应该启动一个降级逻辑,比如通过MD5校验关键字段,进行更彻底的全量比对,确保数据不丢失。
说到底,增量同步的难点,从来不是写出那句正确的WHERE updated_at > last_time。真正的挑战在于,当现实世界不按常理出牌时,你能否想清楚:哪条数据绝对不能丢,哪条数据又绝对不能重复。想明白了这一点,解决方案自然就清晰了。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
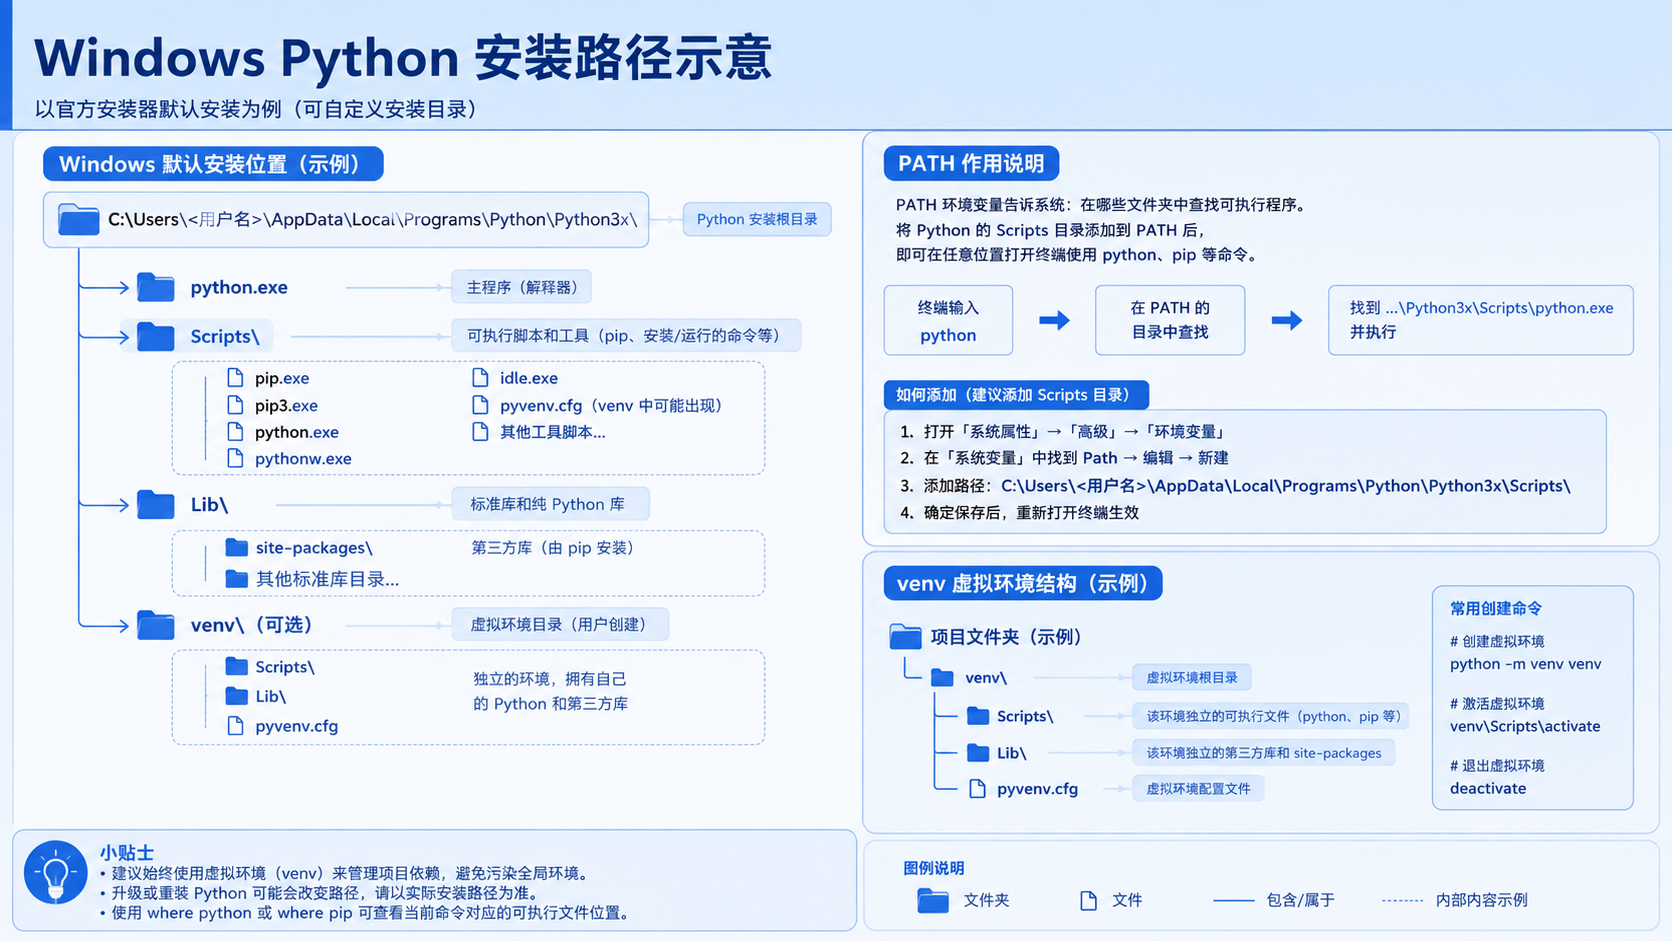
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
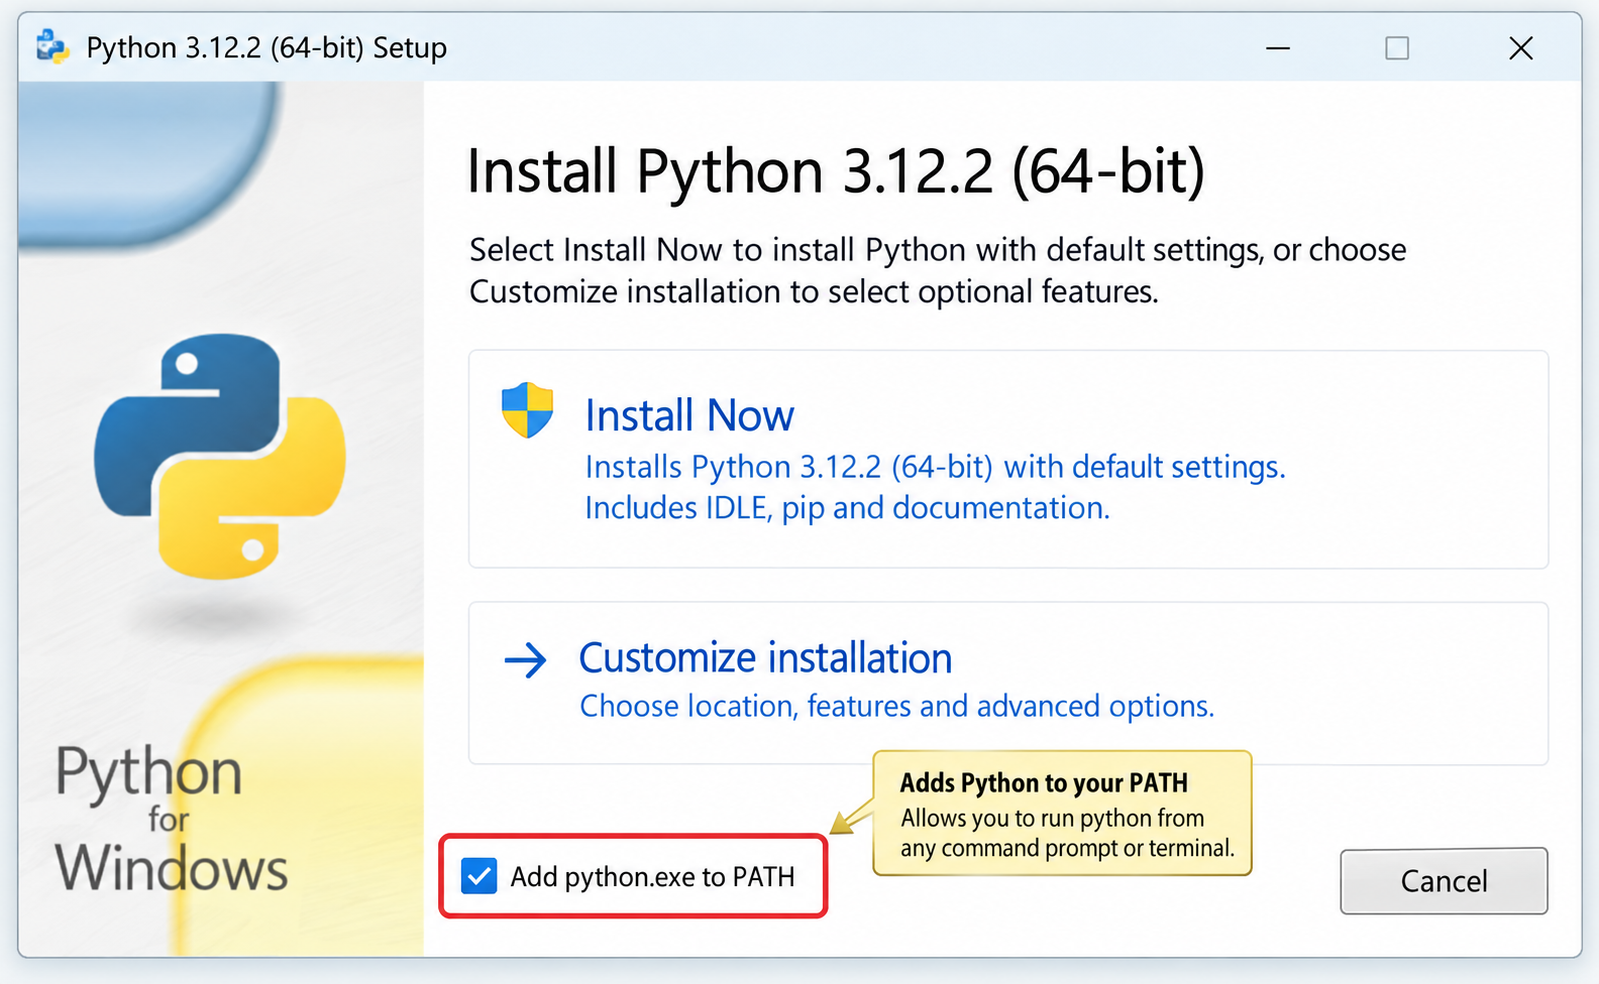
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
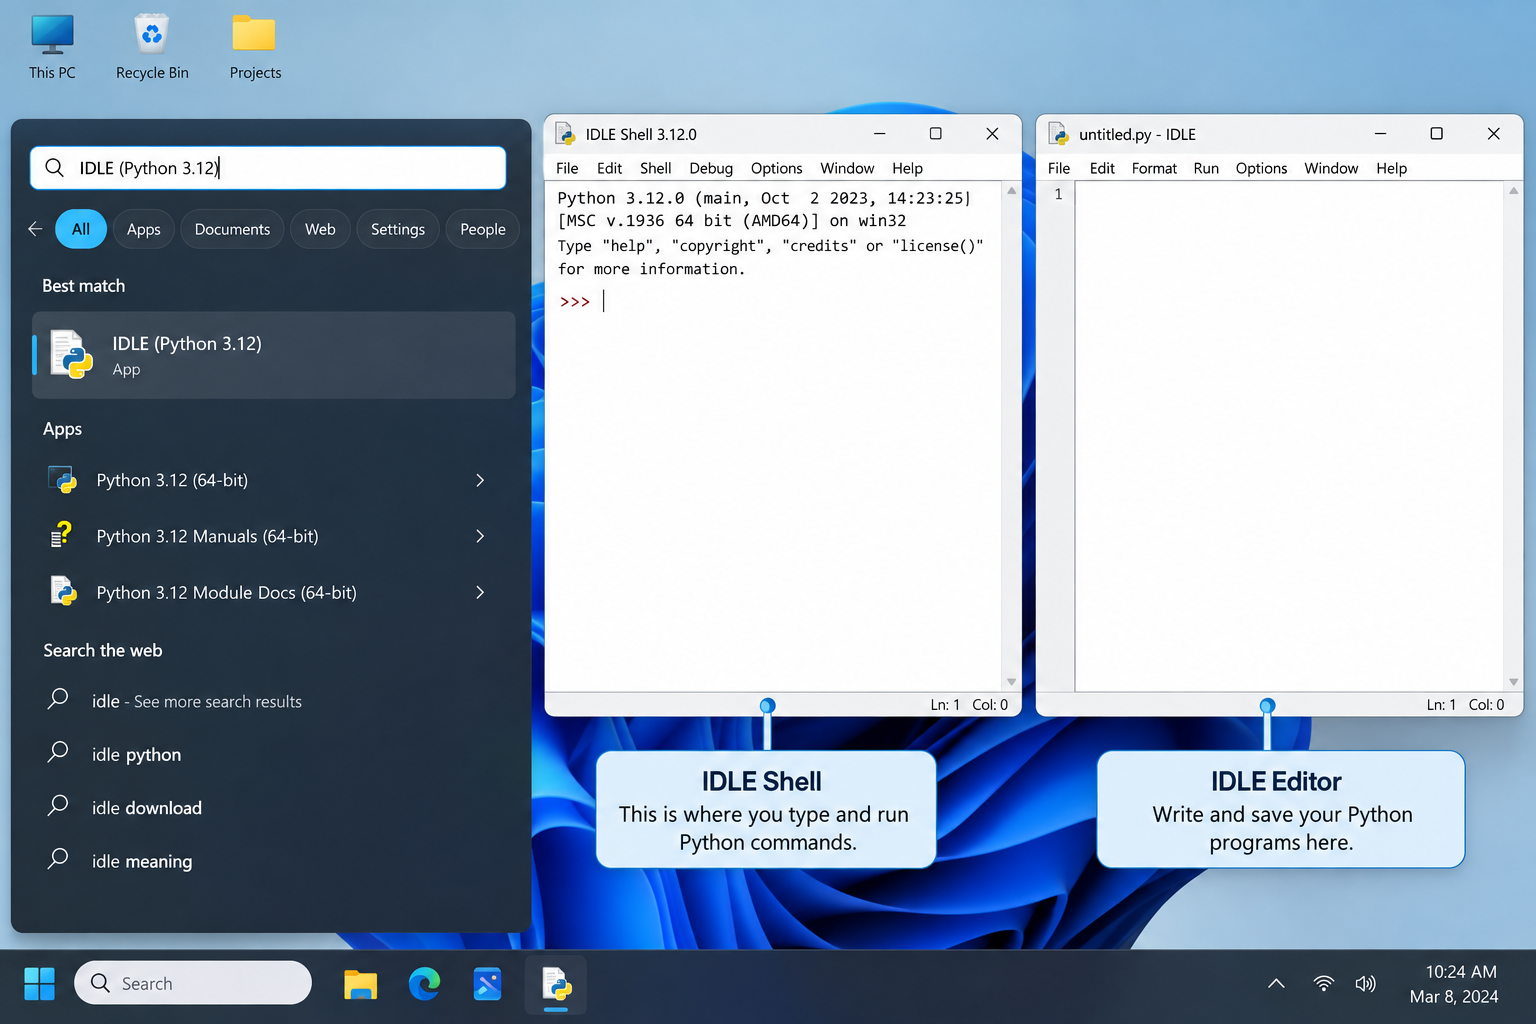
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
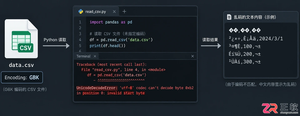
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
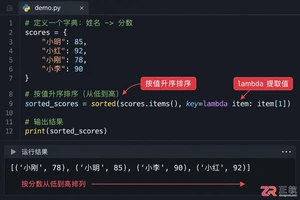
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
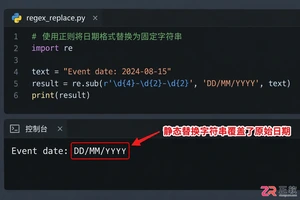
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
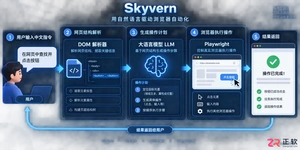
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。