

第 5 篇:Agent 记不住事?补上 Memory + RAG 检索
为解决Agent因大语言模型无状态特性导致的“健忘”问题,构建了分层记忆系统。短期记忆通过JSON文件存储当前会话历史,保障会话连贯性;长期记忆借助ChromaDB向量库存储所有会话摘要,并通过RAG检索机制实现跨会话回忆。结合知识库导入与加权检索,系统能有效利用历史信息提升回答准确性。
前言
前端领域总在讨论“被AI替代”的焦虑,与其被动担忧,不如主动出击,深入AI应用开发的核心——Agent。实践下来发现,Agent的核心竞争力并非高深的算法,而是扎实的工程能力:如何设计架构、串联服务,并将大语言模型的能力真正落地为产品。这恰恰是工程师们最擅长的领域。
这个系列旨在记录从零搭建一个多Agent系统的完整过程,聚焦于技术知识与设计思路的探讨,具体的代码实现则交给AI来完成。如果你也希望从应用层切入AI领域,希望这个系列能为你提供一条清晰的路径。
通过阅读本篇,你将掌握:
- Agent为何“健忘”,以及记忆系统应如何分层设计;
- 短期记忆的实现:使用JSON文件持久化每个会话的对话历史;
- 长期记忆的构建:利用ChromaDB进行向量存储与关键词检索,使Agent具备跨会话的“回忆”能力。
背景与动机
在上一篇文章中,我们将Agent搬进了浏览器,拥有了对话界面和流式输出能力。但多试几轮就会发现一个明显的短板:一旦开启新的会话,Agent就把之前的一切忘得一干二净。
例如,你告诉它“我叫小明,喜欢吃火锅”,下一轮问“我喜欢吃什么?”,它只会一脸茫然。
这并非程序缺陷,而是大语言模型(LLM)的固有特性——无状态。每次调用LLM都相当于一次全新的对话,它不会自动记住上下文。所谓的“记忆”,完全依赖于我们将历史消息作为上下文(Context)塞进提示词(Prompt)里。
那么问题来了:塞多少合适?全部塞进去会迅速触及模型的Token限制(主流模型通常在4K到128K之间),而且历史越长,LLM的注意力就越容易被无关信息分散,导致回答质量下降。
因此,我们需要引入分层记忆策略:近期对话完整保留,久远信息则按相关性进行检索。
核心概念
两种记忆的分工
| 短期记忆 | 长期记忆 | |
|---|---|---|
| 存什么 | 当前会话的完整对话历史 | 所有会话的对话摘要与知识库内容 |
| 怎么存 | JSON文件(按session_id隔离) | ChromaDB向量数据库 |
| 怎么取 | 全量加载,拼接到messages中 | 根据当前问题做相似度检索,取最相关的top_k条 |
| 生命周期 | 会话内有效 | 永久保留 |
| 类比 | 工作记忆(你正在聊的话题) | 长期记忆(你记得去年聊过的事) |
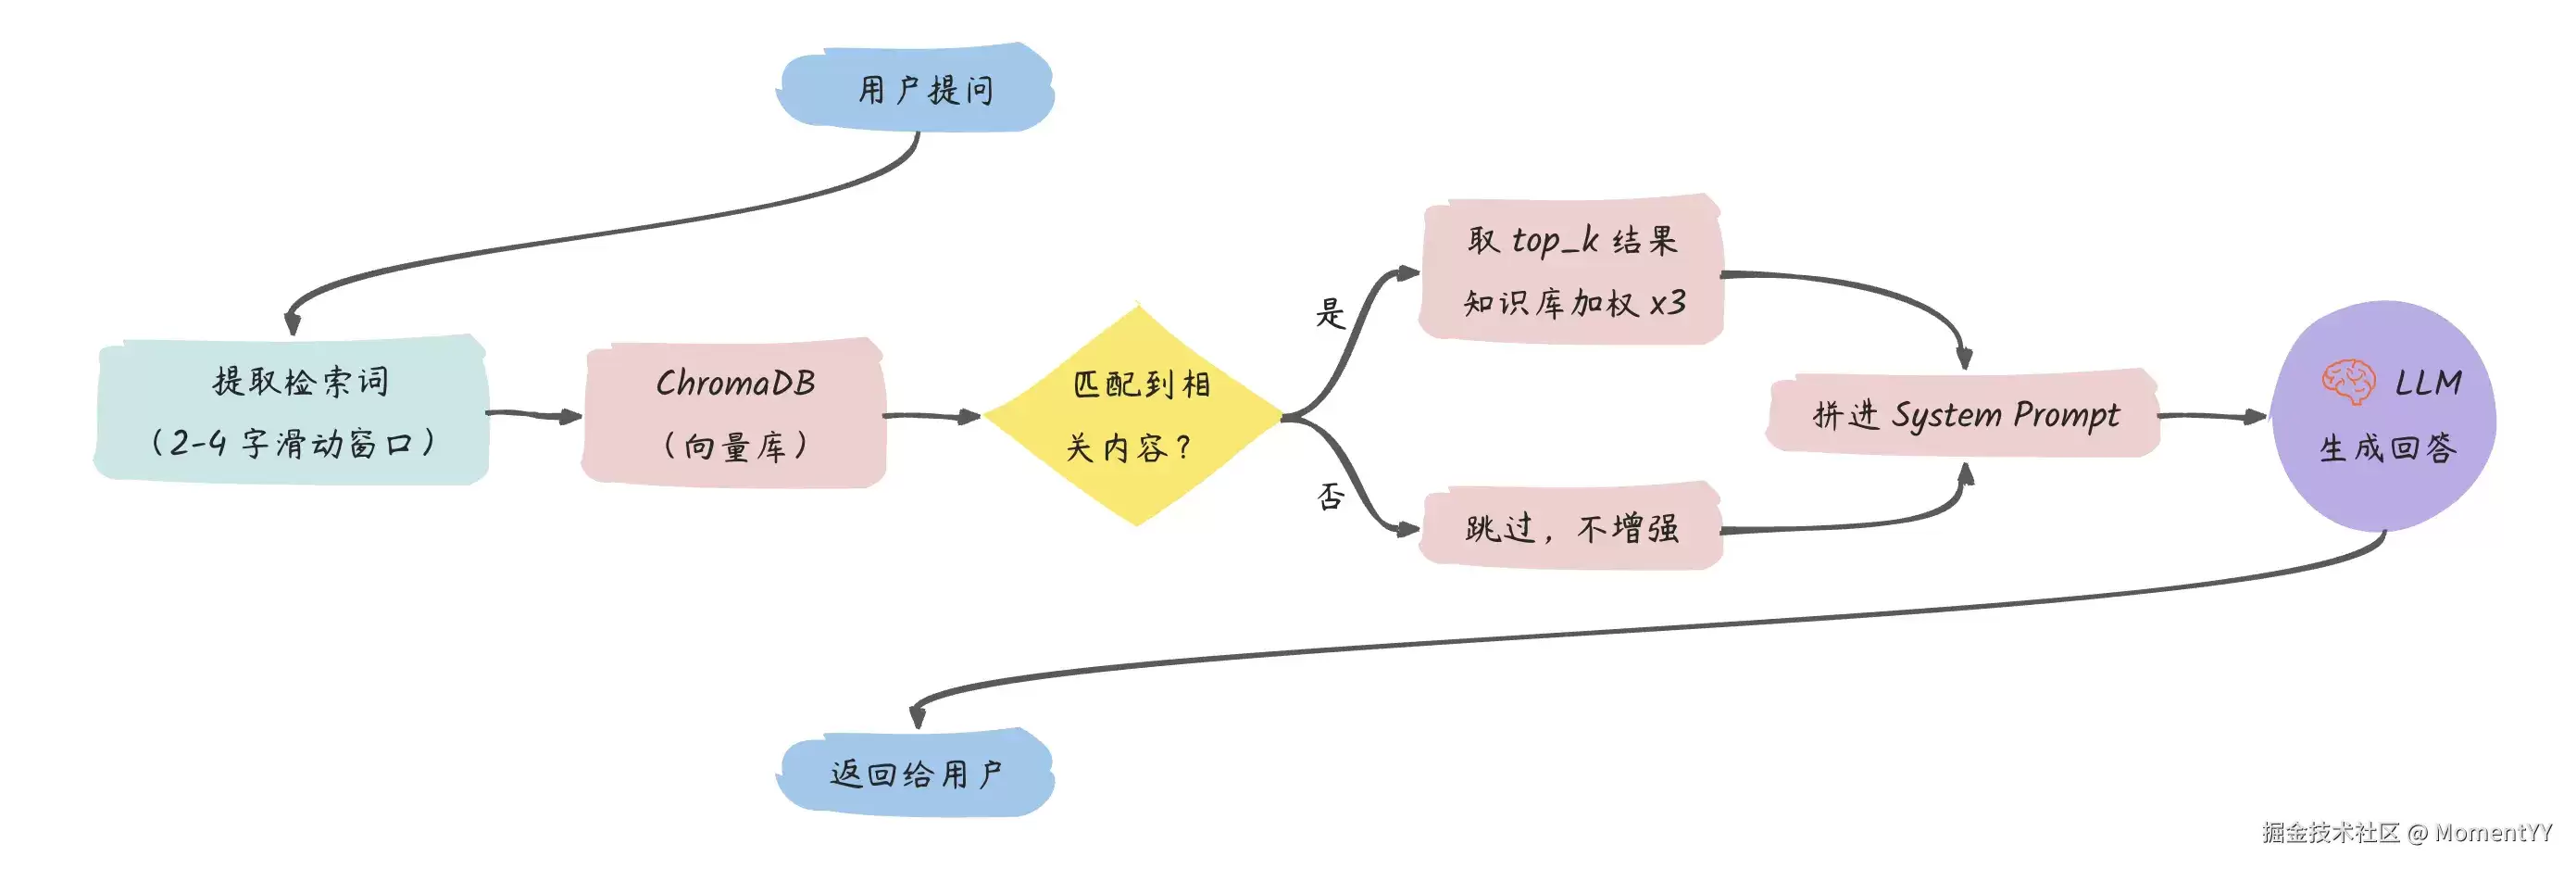
RAG 是什么?
- 检索(Retrieval):从知识库中找到与当前问题最相关的内容;
- 增强(Augmented):将检索到的内容作为上下文,注入到Prompt中;
- 生成(Generation):LLM基于增强后的Prompt生成最终回答。简单来说,就是先查资料,再回答问题。
整体数据流
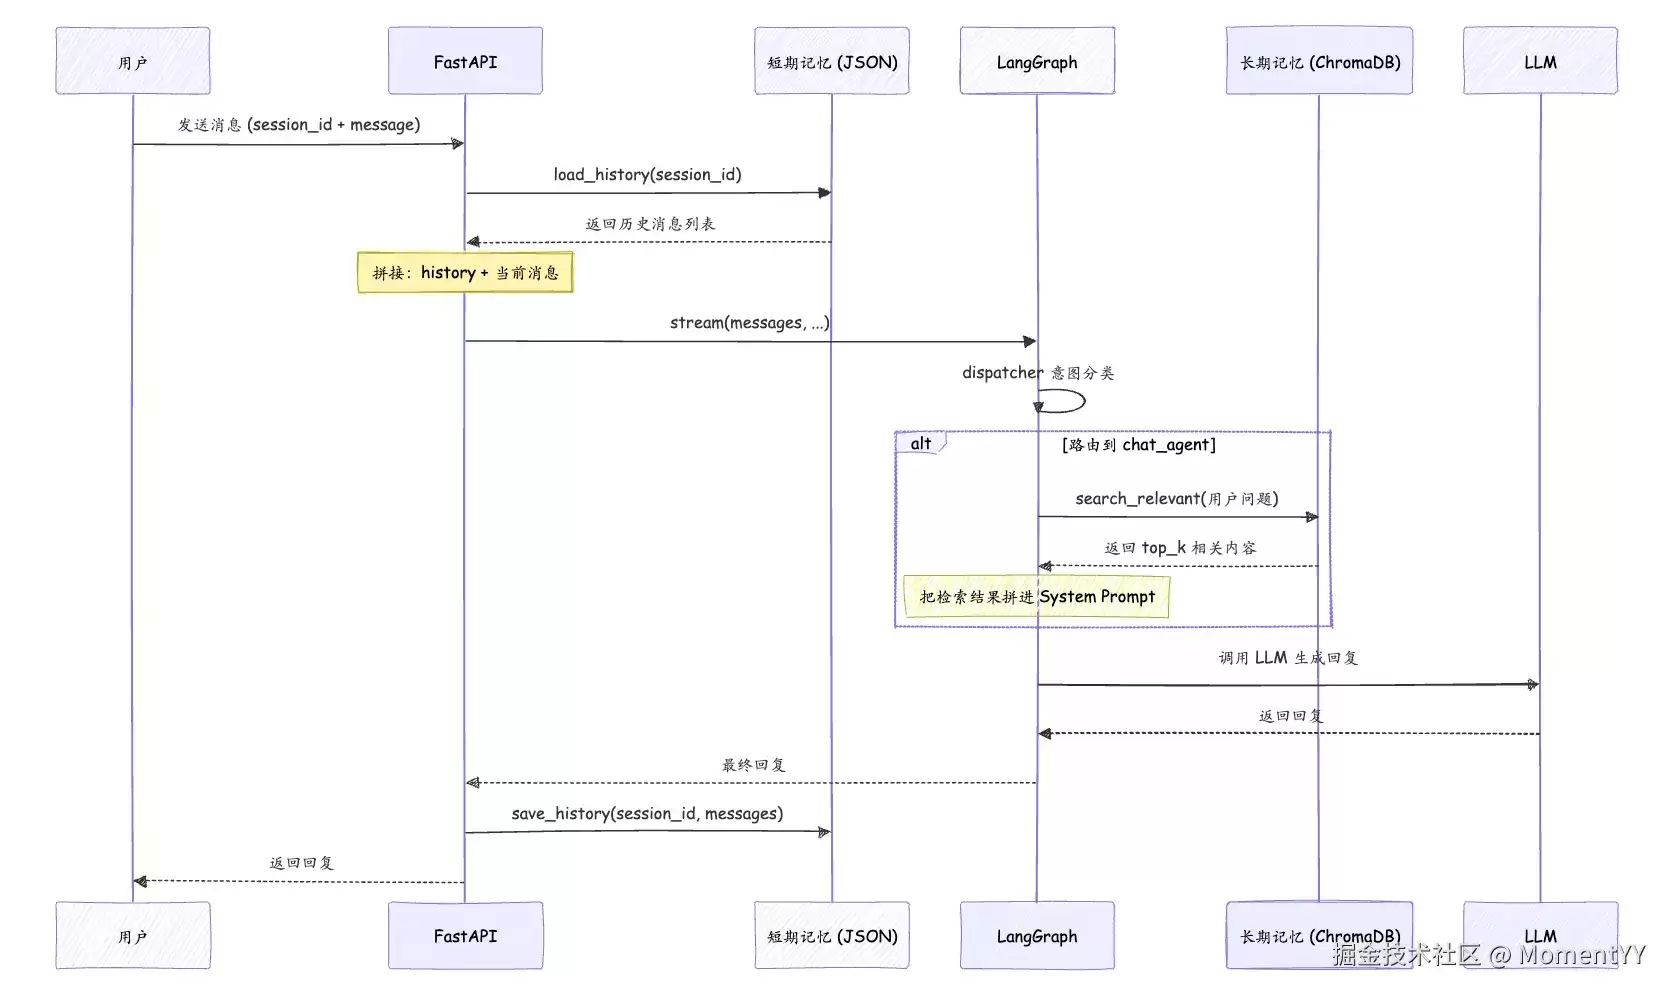
将短期记忆与长期记忆结合后,每次请求的完整流程如下图所示:
动手实现
Step 1:短期记忆(JSON 文件存 session)
最直接的方案是:为每个session_id创建一个对应的JSON文件,用于存储序列化后的LangChain消息列表。
"""
对话历史管理
每个 session_id 对应一个 JSON 文件
生产级会用 Redis / PostgreSQL,但学习阶段 JSON 文件最直观
"""
import os, json
from langchain_core.messages import HumanMessage, AIMessage, ToolMessageMEMORY_DIR = "data/memory"def load_history(session_id: str) -> list:
    """加载某个 session 的对话历史"""
    file_path = _get_session_file(session_id)
    if not os.path.exists(file_path):
        return []
    with open(file_path, "r", encoding="utf-8") as f:
        data_list = json.load(f)
    return [_deserialize_message(d) for d in data_list]def sa ve_history(session_id: str, messages: list):
    """保存对话历史(覆盖写入)"""
    file_path = _get_session_file(session_id)
    data_list = [_serialize_message(msg) for msg in messages]
    with open(file_path, "w", encoding="utf-8") as f:
        json.dump(data_list, f, ensure_ascii=False, indent=2)
序列化的关键在于将LangChain的消息对象(如HumanMessage, AIMessage)转换为包含type和content的字典,加载时再还原回来。
在API层的使用方式如下:
# 每次请求前:加载历史 → 拼到 state 里
history = load_history(session_id)
all_messages = history + [HumanMessage(content=request.message)]# Agent 执行完后:追加新消息 → 保存
history.append(HumanMessage(content=request.message))
history.append(AIMessage(content=reply))
sa ve_history(session_id, history)
这样一来,同一个会话内的对话就能保持连贯——Agent知道你上一句说了什么,可以结合上下文给出更准确的回答。
Step 2:长期记忆(ChromaDB 向量库)
短期记忆解决了“本次会话内的连贯性”,但跨会话就失效了。长期记忆通过向量数据库来解决:将每轮对话存储为向量,下次提问时按相似度进行检索。
"""
向量记忆存储(RAG 长期记忆)
使用 ChromaDB 存储对话历史的向量表示
"""
import time
import chromadb
from pathlib import PathCHROMA_PATH = Path("data/chroma")
_client = chromadb.PersistentClient(path=str(CHROMA_PATH))
_collection = _client.get_or_create_collection(
    name="conversations",
    metadata={"hnsw:space": "cosine"},  # 余弦相似度
)def sa ve_conversation(session_id: str, user_message: str, ai_reply: str):
    """保存一轮对话到向量库"""
    doc = f"用户:{user_message}n助手:{ai_reply}"
    doc_id = f"{session_id}_{int(time.time() * 1000)}"
    _collection.add(
        documents=[doc],
        metadatas=[{"session_id": session_id, "timestamp": str(int(time.time()))}],
        ids=[doc_id],
    )
ChromaDB会自动使用其内置的embedding模型将文本转换为向量存储。查询时,同样先将查询语句转换为向量,再进行余弦相似度匹配。
Step 3:检索——中文场景的坑
理论上,检索应依赖向量相似度匹配。但实际测试中发现一个问题:ChromaDB默认的Embedding模型(all-MiniLM-L6-v2)对中文的支持非常有限。
例如,存储了“北京今天晴天 25°C”,查询“北京天气”可能检索不到——因为英文模型对中文语义的理解能力较弱。
解决方案主要有两条路径:
- 更换中文Embedding模型(如text2vec-chinese、bge-base-zh),但这需要额外下载模型,增加部署成本;
- 关键词检索兜底:使用滑动窗口提取2-4字的n-gram,进行字面匹配。
这里我们采用关键词检索作为兜底方案,在学习阶段足够使用,且不依赖额外模型:
def search_relevant(query: str, top_k: int = 3) -> list[str]:
    """根据当前问题检索相关内容(关键词匹配兜底)"""
    if _collection.count() == 0:
        return []    results_with_score = []
    all_data = _collection.get(include=["documents", "metadatas"])    query_terms = _extract_terms(query)  # 提取检索词
    for doc, meta in zip(all_data["documents"], all_data["metadatas"]):
        score = 0
        for term in query_terms:
            if term in doc.lower():
                score += len(term)
        if score > 0:
            # 知识库内容加权(优先级更高)
            if meta and meta.get("session_id") == "knowledge":
                score *= 3
            results_with_score.append((score, doc))    results_with_score.sort(key=lambda x: x[0], reverse=True)
    return [doc for _, doc in results_with_score[:top_k]]def _extract_terms(text: str) -> list[str]:
    """从文本中提取检索词(2-4字滑动窗口 + 英文单词)"""
    clean = ''.join(c for c in text if c.isalnum() or c in '的了吗呢是')
    terms = set()
    for size in [2, 3, 4]:
        for i in range(len(clean) - size + 1):
            term = clean[i:i+size]
            if term not in ('的了', '了吗', '吗呢', '是的'):
                terms.add(term)
    # 英文单词也加入
    import re
    for w in re.findall(r'[a-zA-Z]+', text):
        if len(w) >= 2:
            terms.add(w.lower())
    return list(terms)
这个方案虽不完美,但在中文场景下比默认的向量检索要可靠得多。后续若需提升效果,只需更换为中文Embedding模型即可,检索接口无需改动。
Step 4:把 RAG 接入 chat_agent
让chat_agent在回答之前,先用当前问题去向量库检索相关内容,如果找到就拼接到System Prompt中:
def chat_agent_node(state):
    """聊天 Agent:检索相关历史 + 调 LLM 回答"""
    # 取最后一条用户消息
    last_user_msg = ""
    for msg in reversed(state["messages"]):
        if hasattr(msg, "type") and msg.type == "human":
            last_user_msg = msg.content
            break    # RAG 检索
    prompt = CHAT_PROMPT
    if last_user_msg:
        relevant = search_relevant(last_user_msg, top_k=3)
        if relevant:
            memory_context = "nn".join(relevant)
            prompt += f"nn【重要】以下是相关的参考资料和历史对话,请优先基于这些内容回答:nn{memory_context}"    messages = [SystemMessage(content=prompt)] + list(state["messages"])
    response = invoke_llm(messages)
    return {"messages": [response]}
逻辑很清晰:有相关内容就塞进去增强上下文,没有就正常回答。LLM会自动判断检索到的内容是否有用。
Step 5:知识库导入
除了自动存储的对话历史,我们还可以主动向向量库中灌入知识。例如,将公司文档、产品说明书等内容喂给Agent,它就能回答相关领域的问题。
导入时使用session_id="knowledge"作为标识,并在检索时对知识库内容进行加权(例如权重×3),使其优先返回:
# 导入知识
sa ve_conversation(
    session_id="knowledge",
    user_message="项目用了哪些技术栈?",
    ai_reply="项目前端用 Vue3 + TypeScript,后端用 FastAPI + LangGraph,向量库用 ChromaDB..."
)# 检索时知识库内容权重更高
if meta.get("session_id") == "knowledge":
    score *= 3
当用户提问中包含相关关键词时,就会触发RAG检索,匹配到的信息被用来丰富上下文,再交由LLM进行分析总结——这正是RAG的魅力所在。
Step 6:验证效果
使用curl命令快速验证效果:
# 第一轮:告诉 Agent 信息
curl -X POST /api/chat -d '{"message": "我叫小明,最喜欢吃火锅", "session_id": "test-1"}'
# → "好的小明,记住了!火锅确实好吃。"# 第二轮:同一个 session,Agent 记得
curl -X POST /api/chat -d '{"message": "我喜欢吃什么?", "session_id": "test-1"}'
# → "你之前说最喜欢吃火锅!"# 第三轮:换一个 session,短期记忆失效,但长期记忆能检索到
curl -X POST /api/chat -d '{"message": "小明喜欢吃什么?", "session_id": "test-2"}'
# → "根据之前的对话记录,小明最喜欢吃火锅。"
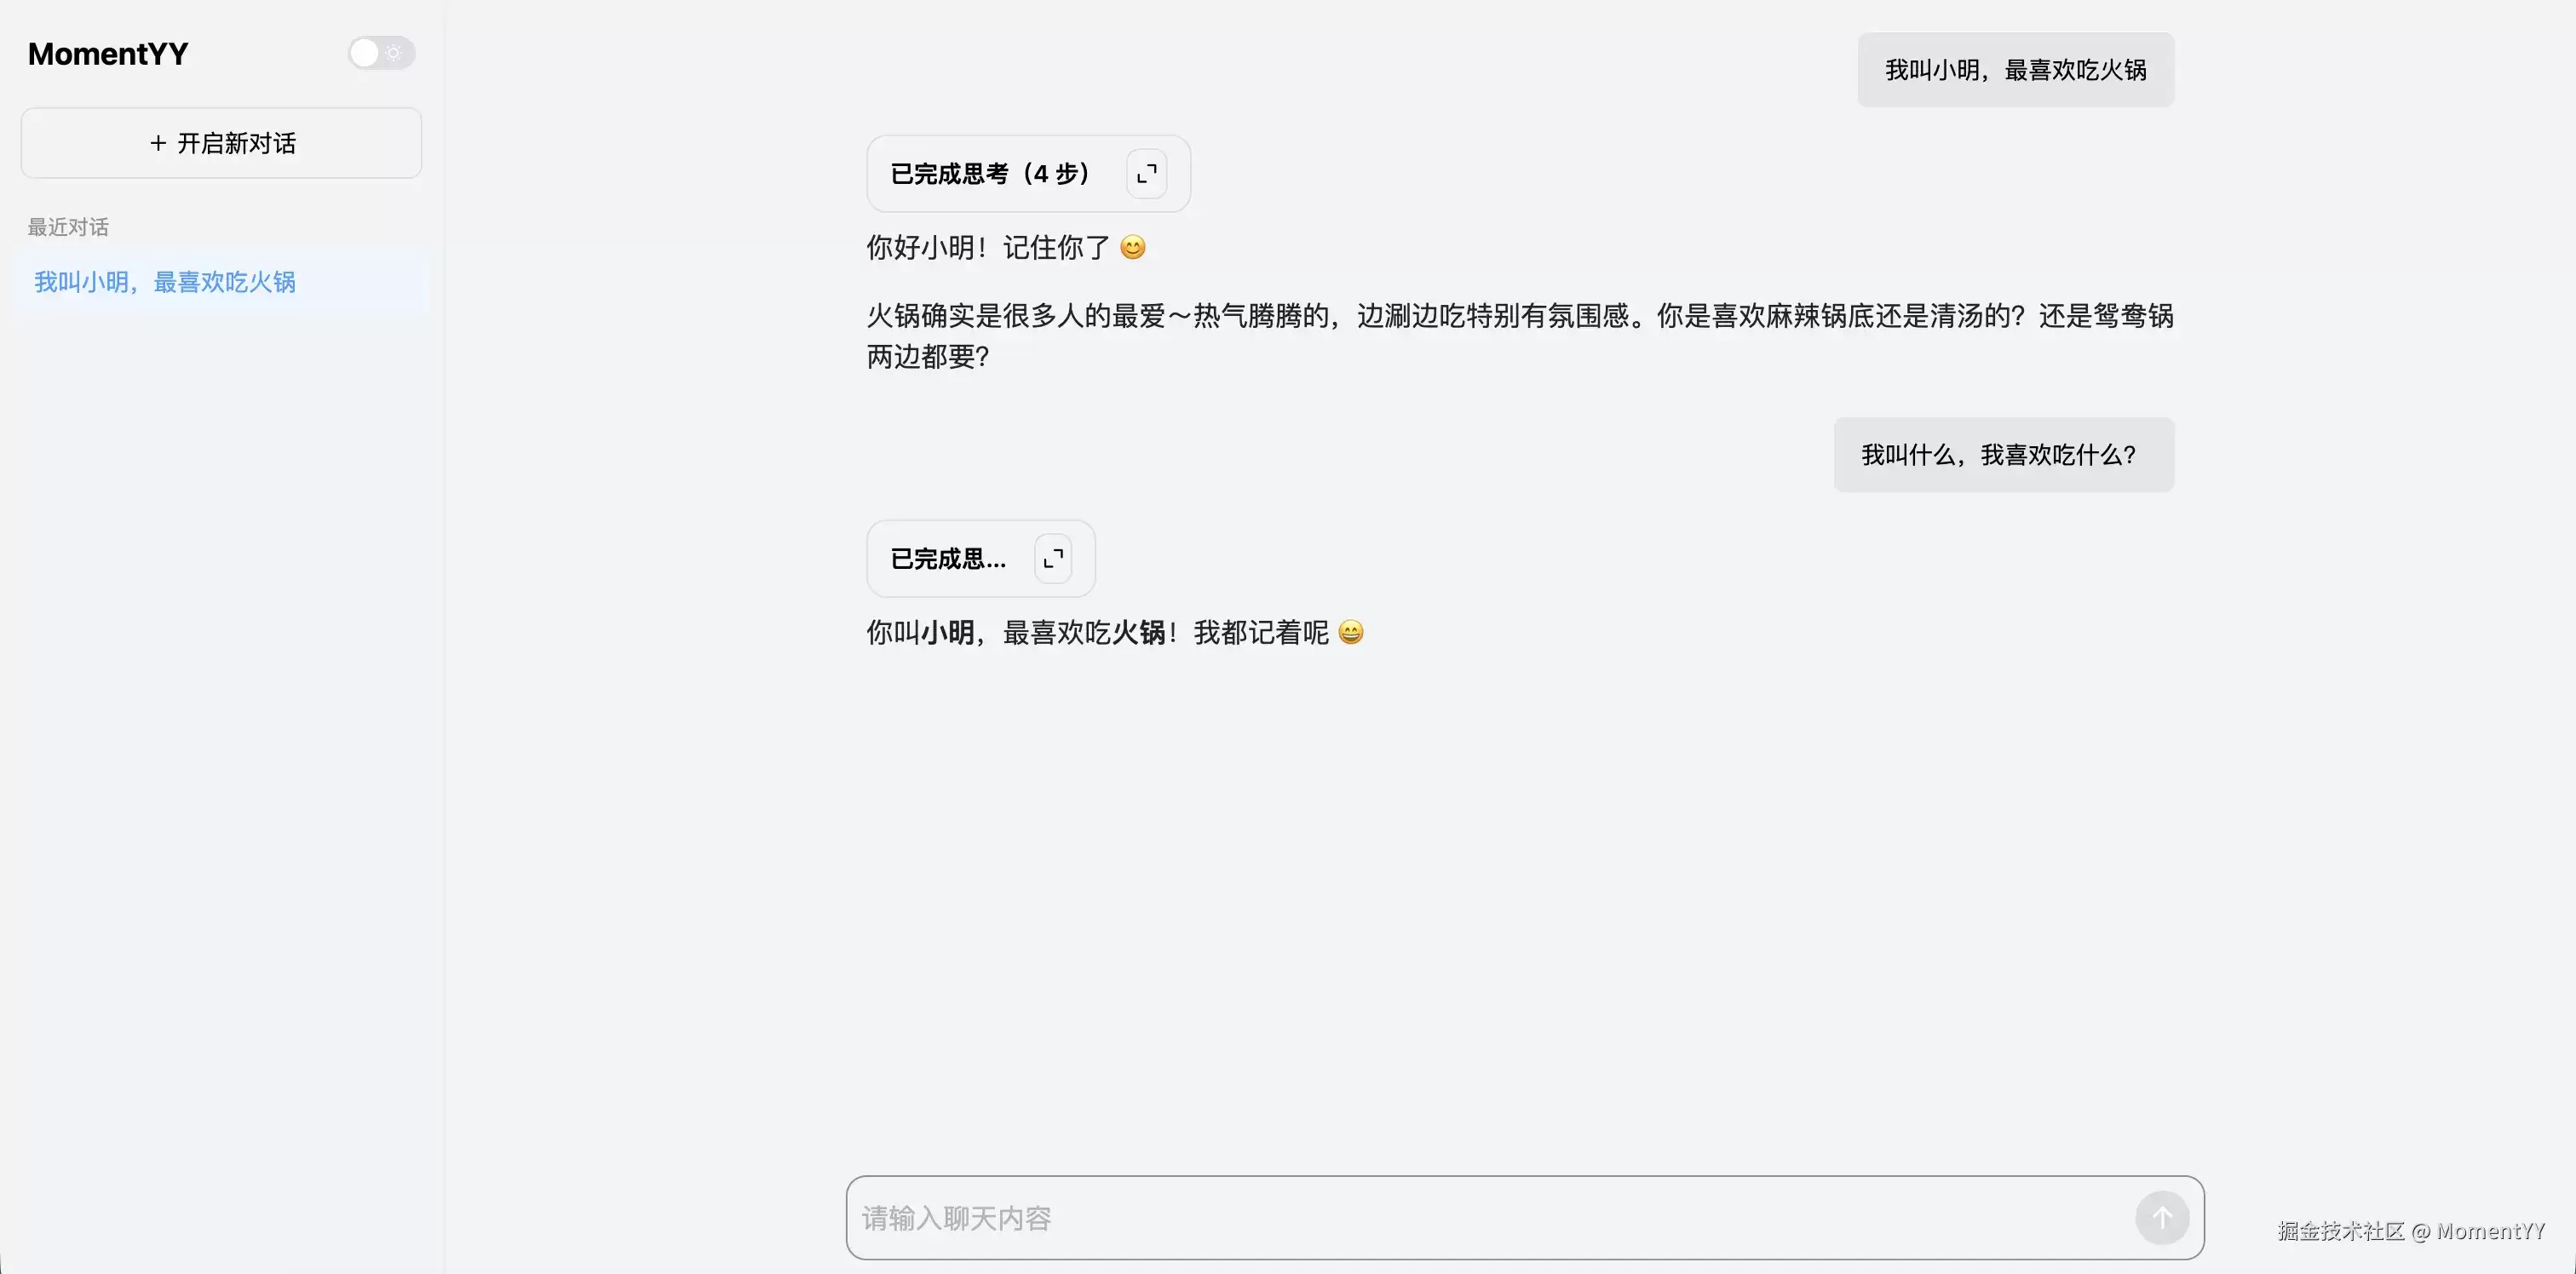
在Web界面上的运行效果如下:
刨根问底
| 序号 | 问题 |
|---|---|
| 1️⃣ | Q:为什么不直接把所有历史都塞进 Prompt? |
| A:主要受限于Token长度和噪声干扰。假设每轮对话消耗200个token,50轮对话就是10K token,再加上系统提示词和工具描述,很容易超出模型限制。更重要的是,大量无关历史会分散LLM的注意力,反而导致回答质量下降。 | |
| 2️⃣ | Q:ChromaDB 默认 embedding 对中文效果怎么样? |
| A:效果不佳。默认使用的all-MiniLM-L6-v2是英文模型,对中文语义的理解能力很弱。生产环境建议更换为bge-base-zh或text2vec-chinese等中文模型。本文采用关键词检索作为兜底方案,在学习阶段足够使用。 | |
| 3️⃣ | Q:短期记忆为什么用 JSON 不用 Redis? |
| A:学习阶段追求的是直观和可调试性——直接打开文件就能查看完整的对话历史,便于排查问题。生产环境当然需要替换为Redis或数据库,以支持过期策略、并发控制和更好的持久化。 |
本篇小结
- LLM本身是无状态的,其“记忆”能力完全依赖工程手段实现;
- 短期记忆(JSON文件)解决了会话内的连贯性问题,长期记忆(ChromaDB)则实现了跨会话的信息检索;
- RAG的本质是“先检索资料,再生成回答”,核心在于将检索结果注入Prompt;
- 中文Embedding是一个常见的坑,关键词检索是一种务实且有效的兜底方案。
写在最后
记忆能力是Agent从“工具”蜕变为“助手”的关键一步。一个能记住你偏好的Agent,与一个每次都需要重新自我介绍的Agent,其用户体验的差距是巨大的。
然而,记忆也带来了新的挑战:存储什么内容?存储多久?何时应该遗忘?这些都是工程上需要持续优化的点。目前我们实现的方案已经可用,但距离“好用”还有距离——例如对话摘要压缩、记忆淘汰策略、多用户隔离等高级特性,后续有机会再展开探讨,感兴趣的朋友也可以自行深入研究。
本系列的核心目标,在于理解Agent的核心构建过程与设计思路。真正的企业级产品,会在这些技术点上提供更加完善和成熟的解决方案。
下一篇预告:目前Agent虽然有了记忆,但其能力仍被我们手写的几个工具所限制。下一篇将是本系列的完结篇,我们将探讨MCP(Model Context Protocol),让Agent能够调用整个开放的工具生态,并回顾整个系列所构建的全景架构。

详解如何在 Windows 电脑上通过 Microsoft Store 安装 Codex 桌面应用,包括启动登录、切换 Codex 模式、关联本地代码项目及终端环境配置的界面操作指引。

本文详解如何在Windows环境中使用PowerShell生成SSH密钥对,配置ssh-agent自动加载私钥,并将公钥安全添加至GitHub账户,最后通过git remote set-url切换为SSH地址,解决每次操作需输入账号密码的问题。

深入解析backdrop与background在网页开发及视觉设计中的区别。通过CSS代码示例,展示如何正确使用background设置元素背景,以及利用backdrop-filter创建弹窗遮罩模糊效果,避免概念混用。

详解 Windsurf IDE 在 Windows 系统的下载来源、安装步骤及首次启动界面。指导用户如何导入编辑器设置、打开项目文件夹及使用终端与 AI 功能,适合初次接触该工具的开发者阅读。

新手入门 ServBay 本地开发环境,详解安装包下载、Dashboard 状态监控、Packages 组件安装、Services 服务控制及 Websites 项目配置。掌握 .servbay.config 版本管理与日志排查技巧,快速搭建稳定的 PHP、Node.js 等多语言开发环境。

详解 CodeKit 在 macOS 下的安装步骤、项目导入方法、Sass与JavaScript编译设置及浏览器自动刷新功能,助您快速搭建高效的前端开发环境。

详解Windows环境下安装OpenAI Codex CLI的步骤,包括WSL环境检查、Node.js/npm配置、npm全局安装命令及首次启动验证,适合开发者快速上手。

学习如何配置 NativeRest REST API 客户端。涵盖 Windows/macOS/Linux 安装后的工作区创建、环境变量管理、请求编辑及响应查看步骤,帮助开发者快速完成基础环境搭建与连通性测试。

深入解析CSS中设置透明度的核心属性opacity,剖析子元素继承、事件穿透、层叠上下文等关键注意事项,并提供与rgba、hsla的实用选型对比。





WPS Office是一款面向macOS用户的综合办公套件,将文字处理、电子表格、演示文稿、PDF工具、模板与云协作整合在同一应用中。它兼容常见Microsoft Office格式,支持Intel及Apple芯片Mac,基础功能可免费使用,

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

AutoCAD 是 Autodesk 推出的专业计算机辅助设计软件,Windows 版支持精确二维绘图、三维实体与曲面建模、图纸标注、布局发布和任务自动化,并包含多套行业专业化工具组合,适用于建筑、机械、电气、工程建设及制造设计人员。
SketchUp Pro 是面向建筑、室内、景观、施工和产品设计等专业场景的三维建模工具,提供桌面建模、LayOut 二维文档、模型资源库、扩展程序及云端协作能力。其操作逻辑直观,适合从概念推敲、空间规划到图纸表达和方案汇报的完整工作流程。
AutoCAD LT 是 Autodesk 推出的专业二维 CAD 软件,适合建筑师、工程师、施工人员和设计师完成精确绘图、标注及文档编制。它支持 DWG 工作流、智能块、图形比较、计数、表格和 AutoLISP 自动化,