

Java爬虫应用实践:分享关键技术和经验的学习成果
Java爬虫实战:学以致用的关键技术和经验分享导语:随着互联网的快速发展,爬虫技术成为了信息获取和数据分析的重要工具。本文将介绍Java爬虫的关键技术和经验分享,并提供具体的代码示例,帮助读者更好地掌握和应用爬虫技术。一、爬虫的基本概念和原理爬虫是一种能够自动获取网络数据并进行分析的程序,它通过模拟人的浏览行为,访问网页并解析其中的数据。其基本原理是发送HT
Java爬虫实战:学以致用的关键技术和经验分享
导语:随着互联网的快速发展,爬虫技术成为了信息获取和数据分析的重要工具。本文将介绍Java爬虫的关键技术和经验分享,并提供具体的代码示例,帮助读者更好地掌握和应用爬虫技术。
一、爬虫的基本概念和原理
爬虫是一种能够自动获取网络数据并进行分析的程序,它通过模拟人的浏览行为,访问网页并解析其中的数据。其基本原理是发送HTTP请求,获取服务器返回的HTML数据,然后使用解析器提取出所需的信息。
二、爬虫的关键技术和经验分享
- HTTP请求和响应
爬虫首先需要发送HTTP请求,获取网页的HTML数据。使用Java可以通过HttpURLConnection或者HttpClient等工具类来发送GET或POST请求,并获取服务器返回的响应数据。以下是一个使用HttpURLConnection发送GET请求的示例:
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.HttpURLConnection;
import java.net.URL;

public class Spider {
    public static void main(String[] args) throws IOException {
        String url = "https://www.example.com";
        HttpURLConnection connection = (HttpURLConnection) new URL(url).openConnection();
        connection.setRequestMethod("GET");
        connection.setConnectTimeout(5000);
        connection.setReadTimeout(5000);

        BufferedReader reader = new BufferedReader(new InputStreamReader(connection.getInputStream()));
        String line;
        StringBuilder response = new StringBuilder();
        while ((line = reader.readLine()) != null) {
            response.append(line);
        }

        reader.close();
        connection.disconnect();

        System.out.println(response.toString());
    }
}- HTML解析器
HTML解析器用于解析网页HTML数据,提取出所需的信息。Java中常用的HTML解析库有jsoup、HtmlUnit等。以下是一个使用jsoup解析HTML数据的示例:
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;

public class Spider {
    public static void main(String[] args) throws IOException {
        String url = "https://www.example.com";
        Document document = Jsoup.connect(url).get();

        Elements elements = document.select(".class-name");
        for (Element element : elements) {
            String content = element.text();
            System.out.println(content);
        }
    }
}- 数据存储
爬虫获取的数据通常需要进行存储和分析。在Java中,可以使用数据库(如MySQL、MongoDB等)、文件(如Excel、CSV等)或者内存(如List、Map等)等方式进行数据存储。以下是一个将数据存储到MySQL数据库的示例:
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class Spider {
    public static void main(String[] args) throws SQLException {
        Connection connection = DriverManager.getConnection("jdbc:mysql://localhost:3306/database", "username", "password");
        PreparedStatement statement = connection.prepareStatement("INSERT INTO table_name (column1, column2) VALUES (?, ?)");

        // 假设从网页中获取到的数据存储在dataList中
        for (Data data : dataList) {
            statement.setString(1, data.getField1());
            statement.setString(2, data.getField2());
            statement.executeUpdate();
        }

        statement.close();
        connection.close();
    }
}
三、总结
通过学习并应用爬虫技术,我们可以方便地获取互联网上的各种数据,并进行进一步的分析和应用。本文介绍了Java爬虫的关键技术和经验分享,包括HTTP请求和响应、HTML解析器以及数据存储等方面的知识。希望读者通过阅读本文,能够更好地掌握和应用爬虫技术,实现自己的需求。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
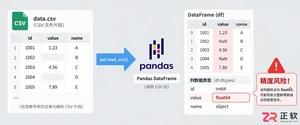
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
详细介绍在Visual Studio Code中安装Chinese (Simplified)语言包的方法,包括通过扩展市场搜索、安装及自动重启切换至简体中文界面的完整步骤,帮助开发者快速将编辑器本地化。
针对Cursor安装包默认锁定C盘且无路径选择界面的问题,提供通过手动移动文件并创建目录联结(Symbolic Link)的解决方案,实现将软件安装在其他磁盘分区。
详解Windows系统下Rust语言的安装步骤,重点解析rustup工具链管理机制,解决环境变量配置错误及MSVC链接器缺失问题,提供可复制的命令验证方法与常见报错的因果排查思路。
详解VS Code中Chat插件的安装与核心配置步骤,重点解决API连接失败、响应慢等常见问题,通过优化上下文设置提升代码生成质量,适合希望集成AI辅助工具的开发者阅读。
本教程通过实战案例详解UniApp开发流程,包括项目初始化、页面结构解析、数据绑定与事件处理,帮助初学者快速上手跨平台应用开发。
详细讲解2026年最新版Android Studio的下载与安装步骤,涵盖JDK环境检查、组件选择及初始配置,助您顺利开启安卓应用开发之旅。



Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


赤友清理大师是一款为 Mac 设计的智能清理优化工具,可精准扫描垃圾、大文件、重复文件等,释放磁盘空间。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。

Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。