

MiniMax发布新模型M3:前沿编程能力,1M上下文和原生多模态的“三合一”模型
MiniMax发布新一代模型M3,采用自研稀疏注意力架构MSA,同时具备前沿编程能力、1M超长上下文和原生多模态,是国内首个集齐这三项核心能力的大模型,且完全开源。百万级上下文下单token计算量仅为上一代约1/20,推理效率大幅提升。
6月1日,AI圈又迎来一则重磅消息——国产大模型公司MiniMax正式发布了新一代通用模型 MiniMax M3。坦白说,这款模型从技术架构到能力组合,都颇具看点。
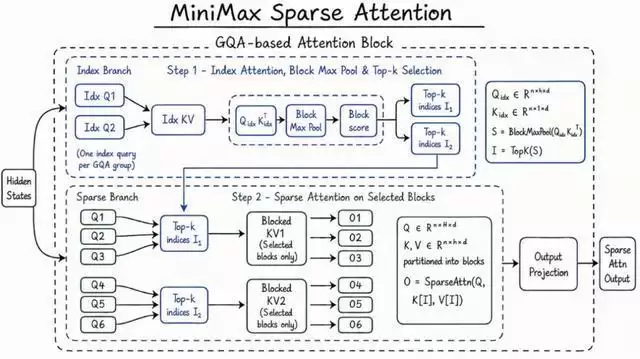
M3最大的亮点,在于它采用了一套全新的自研稀疏注意力架构,名为MiniMax Sparse Attention(MSA)。这套架构带来的直接好处是:在编程能力、智能体能力、超长上下文处理,以及原生多模态支持等多个关键方向上,都实现了代际级别的跨越。换句话说,这不仅是常规的版本迭代,更是一次底层能力的整体跃升。
从官方披露的信息来看,M3是国内首个同时具备“前沿Coding能力、1M超长上下文、原生多模态”这三项核心能力的大模型。更重要的是,它也是目前全球范围内,唯一一个把这套完整能力组合完全开源的选项。开源意味着什么?意味着开发者可以直接拿它去做更垂直的落地应用,这对整个技术生态的推动力不可小觑。
关于性能,MiniMax给出的数据也很提气:在100万级上下文规模下,M3单token的计算量仅为上一代模型的约1/20。推理效率的大幅提升,意味着在实际部署中,成本和响应速度都会有质的改善。
先按成品版式选择比例和面积档,已有精确尺寸则指定宽高。本文说明H3-Image的4K画幅、参考图编辑、批量结果检查及费用和许可边界。
近日,人工智能公司MiniMax向员工、高管及合作商授予116.88万股A类普通股股票,认购价为零元,总价值约6亿港元。该批股份归属周期长达13个月至6年,且无任何业绩考核指标,仅需满足在职时间要求即可全额归属。
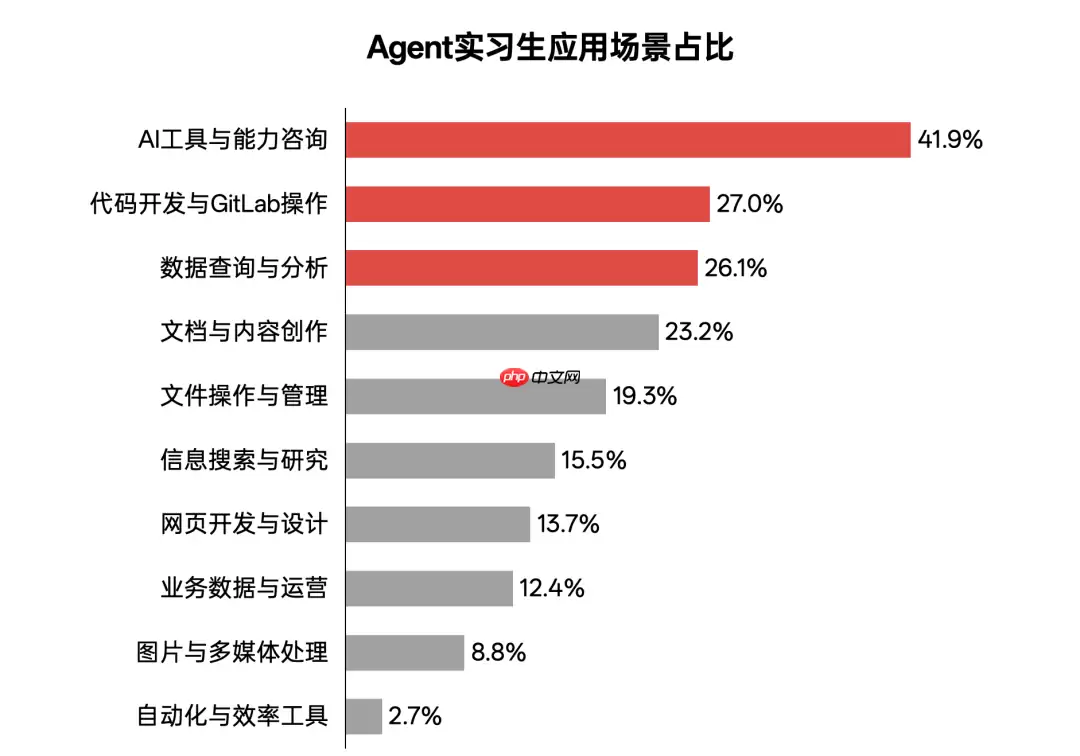
MiniMax发布AI原生工作空间,包含本地智能工作台与可定制专家智能体。其Agent实习生已嵌入核心流程,覆盖率达99%以上,在运维、销售、研发等岗位释放效能,显著提升交付效率。
港股7月迎来史上最大规模解禁潮,MiniMax与极智嘉同日面临解禁。阿里巴巴、米哈游继续押注MiniMax,看好其通用人工智能上限;祥峰投资、鸿为资本坚定看好极智嘉,因其已实现盈利且具身智能落地路径清晰。解禁仅是时间节点,两家企业分别走向AGI与产业落地两条路径。
MiniMax创始人兼CEO闫俊杰近日发布内部信,郑重承诺在实现通用人工智能前不再领取任何薪酬,并拿出其个人名下4%的股份激励团队,另1%特设立专项基金支持开源社区,以此表达对长期发展方向的坚定信心和决心。
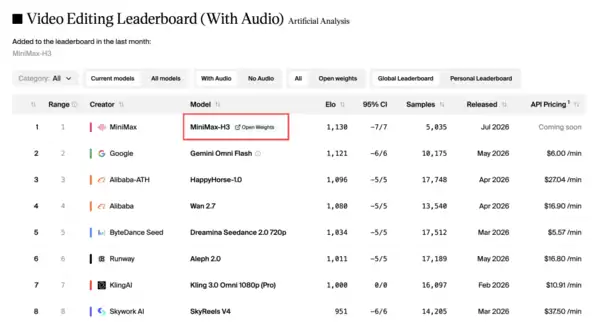
MiniMax推出新一代视频生成模型H3,可完成画面生成、字幕设计、动态特效、镜头节奏及声音匹配等后期任务,从素材工具升级为智能助手。PixPix首发接入该能力,助力内容创作者和电商商家,推动视频创作进入全流程智能化时代。
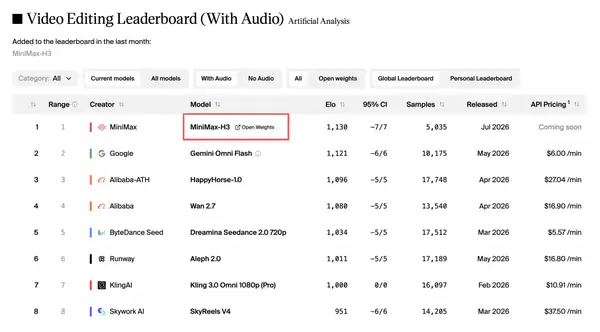
MiniMaxH3视频模型实现图片参考、素材融合、声音生成、字幕设计与镜头控制等多环节整合,推动AI视频进入商业生产流程。PixPix首发接入,助力电商应用,改变内容生产方式,使视频创作不再局限于专业团队。
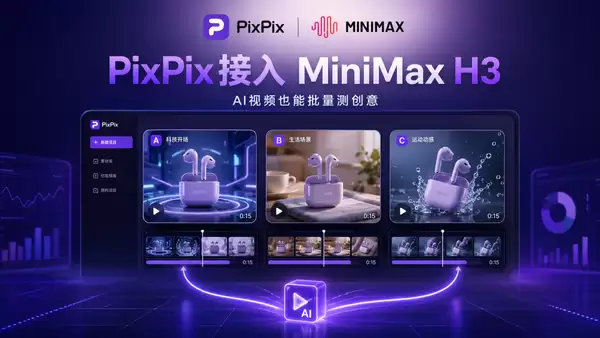
MiniMaxH3发布,定位轻量级全模态视频模型,支持多模态理解与原生音画生成。PixPix行业首发接入,将模型能力引入电商工作流,助力商品展示、广告素材等场景,实现从商品素材到营销视频的生成。
上市半年的MiniMax市值从超4000亿港元跌至不足1000亿,缩水超3000亿。股份解禁、稀缺性减弱及多模态叙事遇冷是主因。公司正从模型厂商向AI平台型转型,但C端用户下滑、盈利亏损等挑战仍存。
稀宇科技这边,今天正式发布了一个新物种——MiniMax H3全模态生成模型。 简单来说,它最大的特点就是能同时处理文本、图像、视频、声音这四种模态的信息,并且把理解、生成、编辑一口气全包了。听起来是不是有点像“全能型选手”?更厉害的是,它输出的音视频还支持原生双声道,最高能直接生成15秒的2K分辨





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



