

Python在Ubuntu中的机器学习应用如何实现
在Ubuntu系统上实现Python机器学习应用,需先安装Python3及NumPy、Pandas、Scikit-learn等库,可选创建虚拟环境隔离依赖。编写K近邻分类脚本处理鸢尾花数据集,完成数据标准化与模型训练后运行。还可使用JupyterNotebook交互编程,或通过Flask部署模型为API接口。
想在Ubuntu系统上跑Python机器学习项目?其实流程并不复杂,只要一步步把环境搭对、把脚本写好,就能让模型跑起来。下面就从最基础的准备开始,带你完整走一遍。
1. 安装Python和必要的库
首先确保系统上已经装了Python。Ubuntu通常预装的是Python 2.x,但机器学习项目一般建议用Python 3.x——版本差异带来的兼容性问题,能省则省。打开终端,先跑一遍系统更新和安装命令:
sudo apt updatesudo apt install python3 python3-pip装好之后,接下来就是机器学习常用的那几个库。NumPy做数值计算,Pandas处理数据,Scikit-learn提供经典算法,TensorFlow或PyTorch跑深度学习。直接一键安装:
pip3 install numpy pandas scikit-learn tensorflow pytorch torchvision torchaudio注意,如果网络慢或者版本冲突,可以用国内的镜像源(比如清华、阿里云),安装速度会快不少。
2. 创建虚拟环境(可选)
不同项目依赖的库版本可能打架,最稳妥的办法就是为每个项目单独建一个虚拟环境。操作很简单:
sudo apt install python3-venvpython3 -m venv myenvsource myenv/bin/activate激活之后,终端前面会出现环境名提示,后面安装的库都只在这个环境里生效,互不干扰。
3. 编写Python脚本
新建一个文件,比如 machine_learning_example.py,把训练模型的代码写进去。下面是一个完整的例子——用经典的鸢尾花数据集,通过K近邻算法做分类:
import numpy as npfrom sklearn.datasets import load_irisfrom sklearn.model_selection import train_test_splitfrom sklearn.preprocessing import StandardScalerfrom sklearn.neighbors import KNeighborsClassifierfrom sklearn.metrics import accuracy_score

# 加载数据集
iris = load_iris()
X, y = iris.data, iris.target

# 划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 数据标准化
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)

# 训练模型
knn = KNeighborsClassifier(n_neighbors=3)
knn.fit(X_train, y_train)

# 预测
y_pred = knn.predict(X_test)

# 评估模型
accuracy = accuracy_score(y_test, y_pred)
print(f"Accuracy: {accuracy:.2f}")
这段代码里做了数据标准化处理——很多机器学习算法对特征尺度敏感,这一步不能省。随机种子设置成42,方便大家复现同样的结果。
4. 运行Python脚本
在终端里直接执行:
python3 machine_learning_example.py如果一切正常,会输出类似 Accuracy: 1.00 的结果(准确率接近100%)。这个例子比较基础,但流程完整,从数据加载到模型评估一步到位。
5. 使用Jupyter Notebook(可选)
如果你更喜欢交互式的编程体验,Jupyter Notebook是个好选择。安装和启动只需要两条命令:
pip3 install notebookjupyter notebook浏览器会自动打开一个工作台,在里面新建一个Python笔记本,把上面的代码一段段敲进去执行,每一步的输出都实时可见,调试和探索数据非常方便。
6. 部署模型(可选)
模型训练好了,怎么让别人也用上?最简单的办法是用Flask搭一个轻量级的API接口。安装Flask:
pip3 install flask然后写一个简单的应用,加载之前保存好的模型文件(比如 model.pkl),接收POST请求并返回预测结果:
from flask import Flask, request, jsonify
import joblib

app = Flask(__name__)

# 加载训练好的模型
model = joblib.load('model.pkl')

@app.route('/predict', methods=['POST'])
def predict():
    data = request.get_json(force=True)
    prediction = model.predict([data['features']])
    return jsonify({'prediction': list(prediction)})

if __name__ == '__main__':
app.run(port=5000, debug=True)启动服务器:
python3 app.py现在,只要向 http://localhost:5000/predict 发送一个包含特征数据的POST请求,就能收到模型的预测结果。当然,如果是生产环境,Flask的debug模式要关掉,再加上日志、限流等保护措施。
以上就是在Ubuntu上实现Python机器学习应用的完整流程。从环境搭建、脚本编写到模型部署,每一步都有对应的工具和最佳实践。根据项目实际需求,你可以灵活选择不同的库和框架,构建出真正能落地的机器学习系统。
遇到Git合并冲突别慌张,本文详解冲突产生的原因及标准处理流程,涵盖查看冲突文件、理解标记含义、手动修改代码及完成合并提交的完整步骤,助你高效解决协作开发中的代码冲突问题。
深入对比Java中获取当前时间戳的两种主流方式:System.currentTimeMillis与java.time.Instant。分析二者的精度差异、API设计、时钟回拨影响与实际选型建议。
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
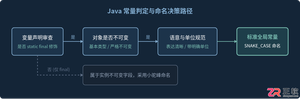
深入解析Java常量命名标准、大写下划线语义规则,剖析接口常量反模式的危害与本质原因,并提供枚举、不可实例化常量工具类等工业级最佳替代方案。
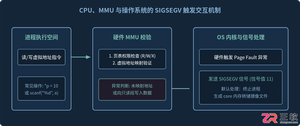
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
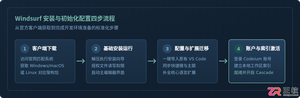
本文提供全面的Windsurf开发工具安装与使用详细教程,覆盖客户端下载安装、环境配置与VS Code插件迁移、Cascade核心协作中枢使用技巧、Chat与Write双模式实战及高效开发规范。

全面盘点Flutter主流状态管理框架,深度解析Provider、Riverpod、Bloc与GetX的核心机制、优缺点及适用场景,提供系统化的状态管理选型指南。
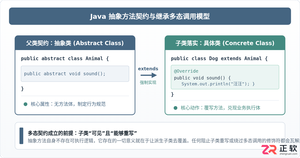
深入剖析Java中抽象方法为何严禁使用private和static修饰符。从面向对象契约规范、方法继承重写、JVM动态绑定(invokevirtual)与静态解析(invokestatic)等底层机制展开详细推导,结合编译报错示例与全景对比,彻底理清修饰符限制背后的设计逻辑。
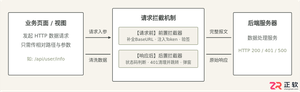
详细讲解uni-app中网络请求拦截的配置方法与实现路径,包含uni.addInterceptor原生API拦截与Promise二次封装方案、Token注入、全局错误处理及踩坑提醒。




IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


