

如何在Python中使用Pandas读取HDF5格式的高性能大型数据集?
读取HDF5时,先用h5py探明结构避免键名错误。pd.read_hdf()仅支持PyTables格式,需写入时指定format='table'和data_columns。非Pandas数据可用h5py切片读取转换。写入推荐format='table'、data_columns及blosc压缩以提升后续读取效率。
先说说各位在使用Pandas读取HDF5文件时,最让人头疼的两个问题:要么是内存直接爆掉,要么是收到一个莫名其妙的`KeyError: 'No object named … in the file'`。
问题出在HDF5文件的结构上。它不是一个“一张表对应一个文件”的简单玩意儿,而是一个像文件系统一样的容器,里头可以存放多个数据集(就是代码里的`key`)。而且,它默认不会告诉你里面到底有哪些东西。你直接调用`pd.read_hdf('data.h5')`,Pandas会尝试去读取一个叫`'/df'`或`'table'`的默认键。但现实是,很多生产环境下的HDF5文件,根本不会按这个约定来命名。
这时候,正确的做法是先摸清文件结构,用`h5py`来探路:
import h5py
with h5py.File('data.h5', 'r') as f:
    print(list(f.keys()))  # 看看顶层有哪些group
    # 如果还有嵌套,比如 '/processed/2023Q1/sales',就需要写上完整路径
另外,还有两个常见坑需要留意:
pd.read_hdf()只能读取它自己用pd.to_hdf()写进去的Table或Fixed格式。如果这个HDF5是用h5py、MATLAB 或者别的什么工具生成的原始数据集,那它就没辙了。- 键名里如果带着斜杠(比如
'/raw/feature_matrix'),引用时一定要加引号,并且开头的那个/不能省略。 - 一个容易忽略的安全点:处理大文件时,务必用
mode='r'(只读模式),不小心用了'a'模式,可能会触发一些意想不到的写入操作,甚至把文件锁死。
如何用 pd.read_hdf() 高效读取子集,避免全量加载
HDF5 支持按行过滤和按列选取,但这有个前提:只对一种格式生效——format='table'(也就是 PyTables 格式)。如果当初写入时用的是 format='fixed',那这些参数就全白费了,Pandas还是会老老实实把整个文件砸进内存里。
读取时,有几个关键参数组合值得记住:
where:传入查询条件,比如"date > '2023-01-01' & category == 'A'"。但要注意,前提是这些列在写入时已经被索引了(通过data_columns=['date', 'category']指定)。columns:指定你真正需要的列名列表,比如['user_id', 'event_time'],这能显著减少内存占用,属于“精准打击”。start/stop:按行号切片读取。对于没有索引的大宽表,这个方法比where更快,但它没法做条件过滤。iterator=True+chunksize=10000:返回一个HDFStore迭代器。如果你要处理的数据流非常大,这个组合能帮你实现流式处理,一点一点消化。
举个例子,带条件加列筛选,清爽又高效:
df = pd.read_hdf(
    'data.h5',
    key='/sales/table',
    where="region == 'CN' and revenue > 1000",
    columns=['order_id', 'revenue', 'ts'],
)
用 h5py 手动读取原始 dataset 后转为 DataFrame 的适用场景
当你的HDF5文件是科学计算常用的格式(比如直接存了NumPy数组),或者是由非Pandas工具生成的,那么pd.read_hdf()就会彻底失效。这时候,必须请出底层的 h5py 来亲自操刀。
典型的操作流程是这样:
- 用
f[key]拿到数据集对象,再调用[...]触发读取。特别提醒:[...]会一次性把数据全量加载到内存,如果文件很大,务必小心。 - 数据太大怎么办?用
f[key][start:stop]切片读取,然后分批拼成DataFrame,这是避免OOM的常规操作。 - 列名需要手动构造:
pd.DataFrame(data, columns=col_names)。这些列名通常藏在同一个group的attrs里,或者单独有个group存放。 - 时间戳字段经常是
int64类型(纳秒级的Unix时间戳),需要手动转换:pd.to_datetime(..., unit='ns')。
看一个安全切片读取的例子:
import h5py
import numpy as np

with h5py.File('sensor.h5', 'r') as f:
    dset = f['/measurements']
    # 分块读取,避免内存爆炸
    chunk = dset[0:50000]  # shape (50000, 12)
    df = pd.DataFrame(chunk, columns=['temp', 'hum', 'vib_x', ...])
写入时就该注意的三点,决定后续读取效率
读取慢,或者功能受限,90%的锅都能甩到写入时的配置上。关键参数必须在 to_hdf() 时明确指定,不能偷懒:
format='table':这是开启查询、列选取、增量追加等高级功能的大门。而format='fixed'虽然写入快,但功能受限,后续只能全量读取。data_columns:把你未来要频繁过滤的字段(比如date,user_id)都加到这个列表里。否则,where参数就是个摆设。complib='blosc'+complevel=9:这对组合对数值型大数据的压缩效率高,解压速度也快。相比之下,zlib在Pandas HDF5里的支持表现就比较一般。
很多新手图省事,写出来往往是这样的:
# ❌ 不推荐:没指定 format 和 data_columns
df.to_hdf('out.h5', 'data')
但真正懂行的人,会这么写:
# ✅ 推荐:可过滤、可选列、高压缩
df.to_hdf(
    'out.h5',
    'data',
    format='table',
    data_columns=['timestamp', 'device_id'],
    complib='blosc',
    complevel=9
)
说到底,真正难的不是怎么读,而是先搞清楚这个HDF5文件里到底存了什么、是怎么存的。花两分钟时间,用 h5py 看一眼结构,远比你在那里反复试错 key 和 where 参数要省事得多。这,才是效率的根源。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
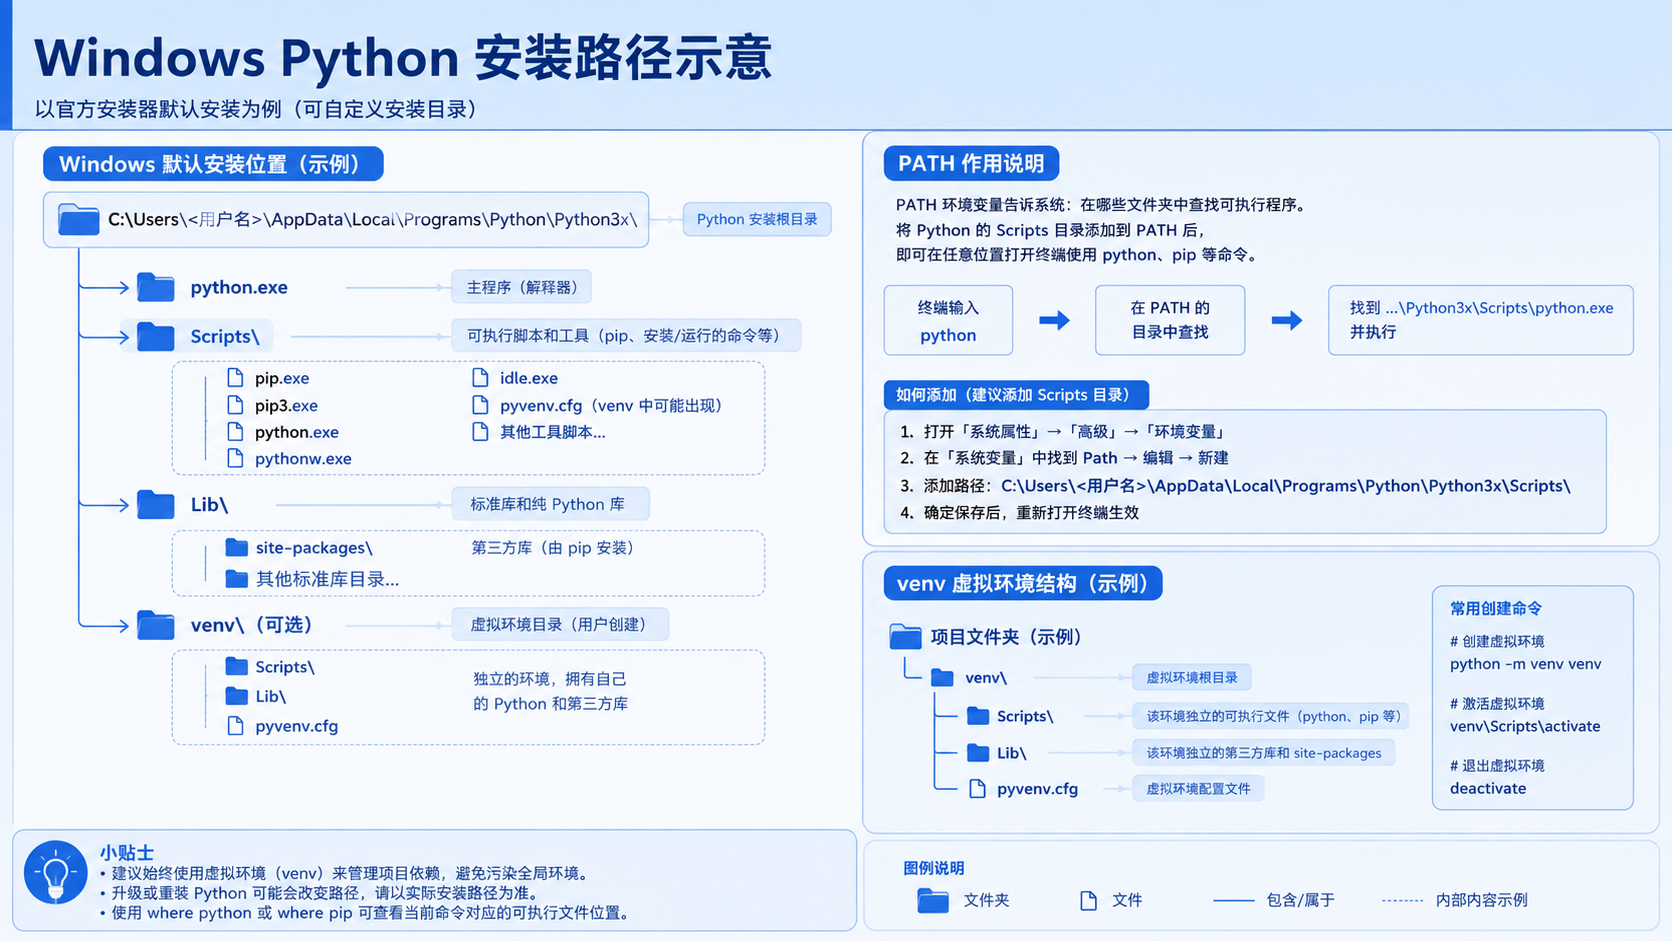
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
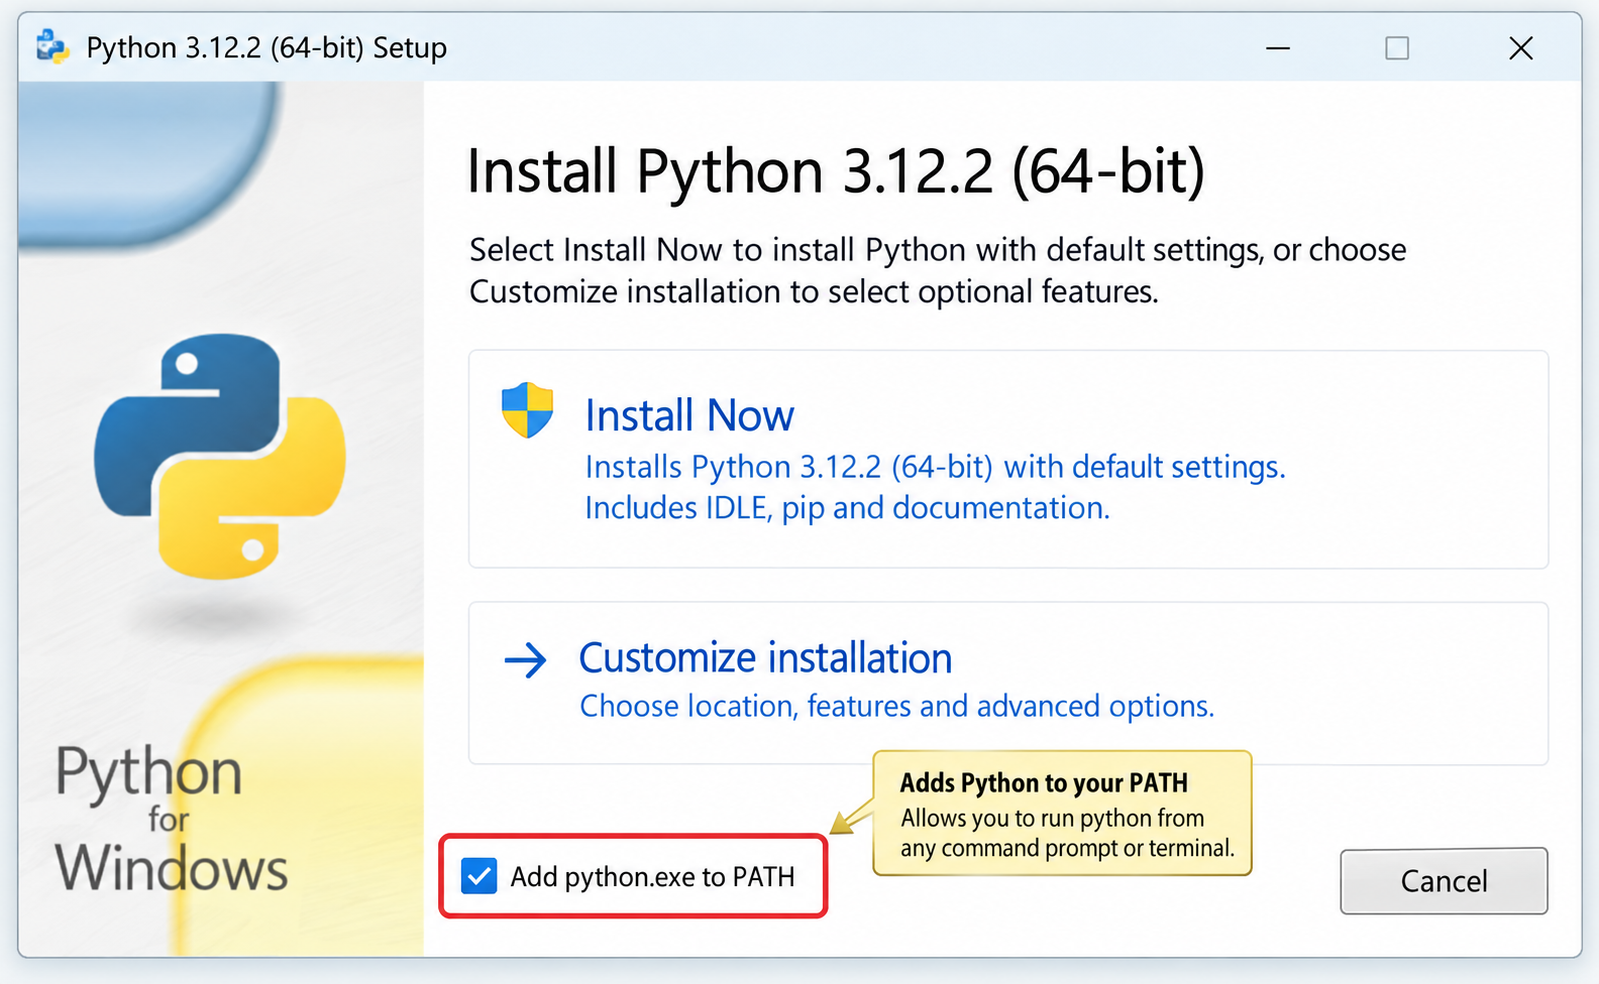
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
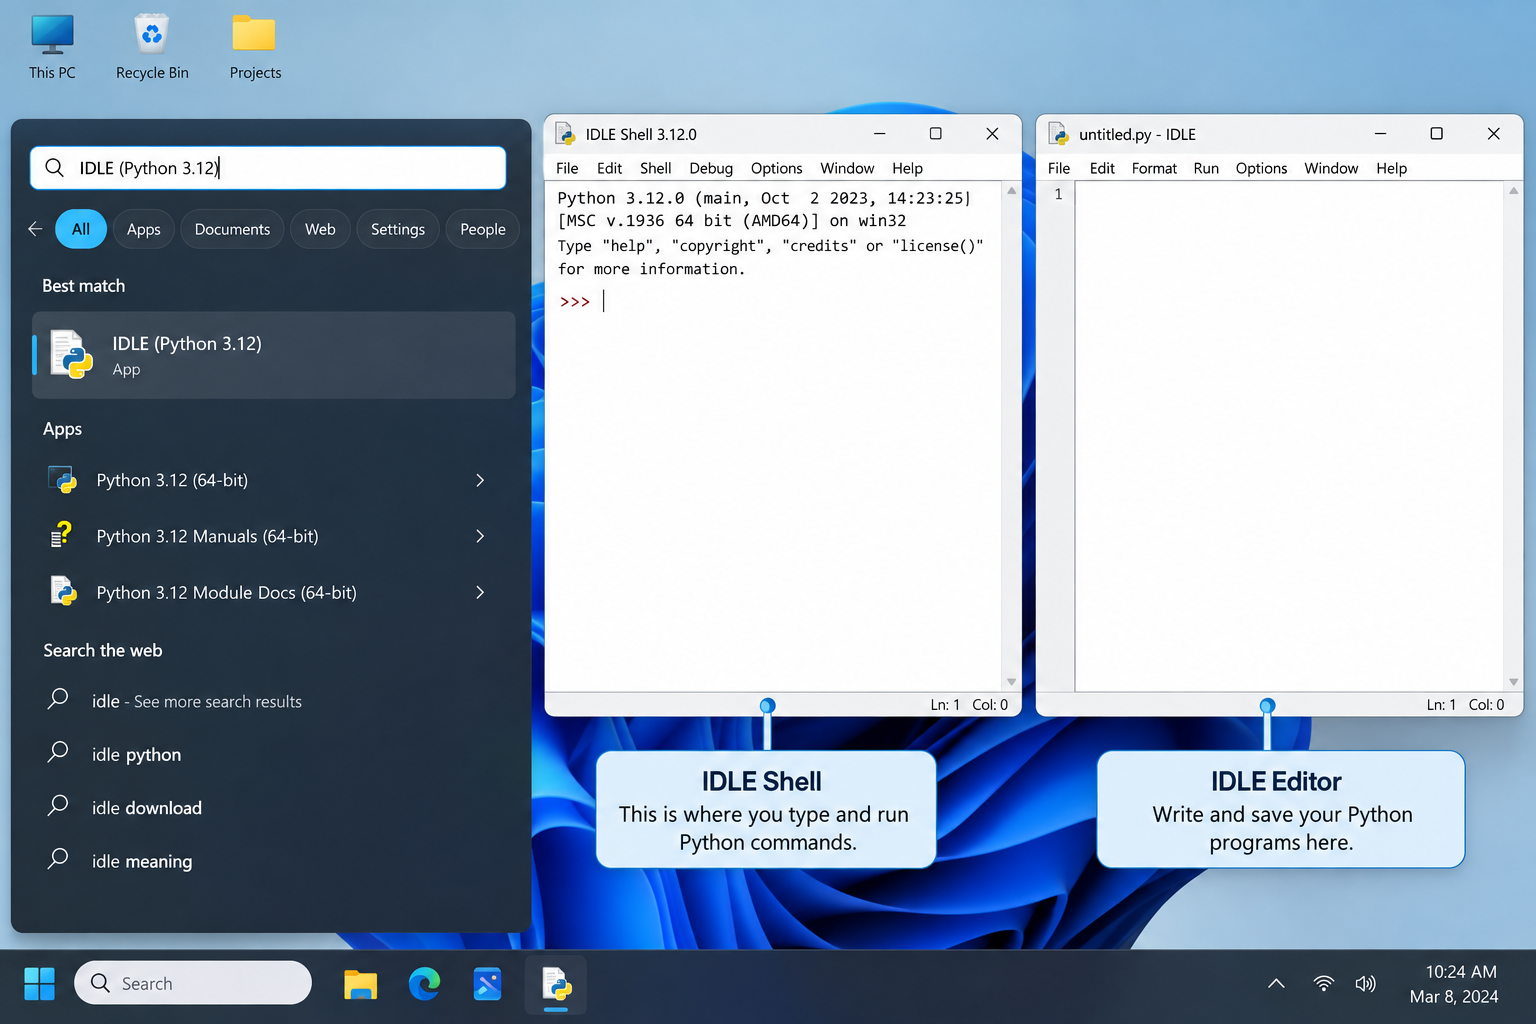
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
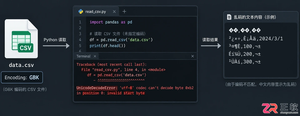
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
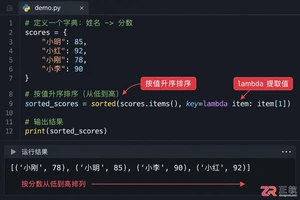
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
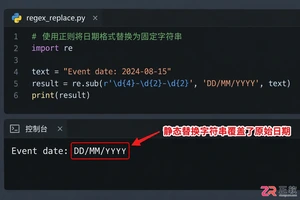
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
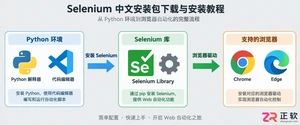
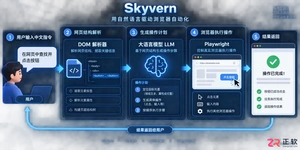
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。