

Python中PyTorch2.0编译失败如何降级回退_配置dynamic=True与后端切换策略
PyTorch2.0编译失败时,降级安装至1.13.1加CUDA11.7版本可绕过多数报错。动态模式启用动态图追踪机制,但易导致重编译和显存溢出。默认后端inductor支持CPU和GPU,要求CUDA版本不低于11.6;nvfuser后端仅支持GPU且不支持动态形状,失败时可尝试切换。
先说一个最稳妥的降级方案:安装 torch==1.13.1+cu117(或对应 CUDA 版本),可以绕过 PyTorch 2.0 的编译问题。不过,dynamic=True 虽然能启用动态图追踪,但很容易导致重编译和显存溢出;而 inductor 是默认后端,nvfuser 只支持 GPU 且不支持动态 shape。
PyTorch 2.0 编译失败时,降级安装最稳妥的版本组合
直接换回 torch==1.13.1+cu117(或对应 CUDA 版本)通常能绕过绝大多数编译报错,尤其是涉及 torch.compile 或自定义 C++/CUDA 扩展失败的情况。PyTorch 2.0 的 torch.compile 引入了大量新 IR 和后端适配逻辑,源码编译对 Ninja、CMake、CUDA Toolkit 版本非常敏感,而预编译二进制包已屏蔽大部分构建路径。
实操建议:
- 先卸载现有版本:
pip uninstall torch torchvision torchaudio - 从官方渠道下载匹配环境的 wheel,按
cu117/cu118/cpu和 Python 版本筛选,例如:torch-1.13.1+cu117-cp39-cp39-linux_x86_64.whl - 用
pip install xxx.whl安装,不要加--force-reinstall,避免残留 .so 符号冲突 - 验证:
python -c "import torch; print(torch.__version__, torch.cuda.is_a vailable())"
dynamic=True 在 torch.compile 中的真实作用与误用风险
dynamic=True 不是“自动适配张量形状”,而是启用 TorchDynamo 的动态图追踪模式,允许同一 compiled 函数处理不同 shape 的输入(如 batch size 变化),但代价是每次 shape 改变都会触发一次重新编译 —— 这在训练循环中极易导致性能骤降甚至 OOM。
常见错误现象:
- 训练时 loss 突然卡住几秒,日志出现
recompiling graph due to dynamic shape change - GPU 显存持续上涨,
nvidia-smi显示多个torch.compile生成的 CUDA kernel 占用显存 - 小批量推理反而比未 compile 更慢
使用建议:
- 仅在明确需要支持变长输入(如 NLP 中不同长度的 prompt)且能接受首次开销时启用
- 优先用
fullgraph=True+ 固定 shape 输入,让 Dynamo 生成单一封闭图 - 若必须动态,配合
mode="reduce-overhead"降低 recompile 频率,而非默认"default"
切换 torch.compile 后端:inductor 与 nvfuser 的关键差异
PyTorch 2.x 默认后端是 inductor(基于 Triton),不是 nvfuser。两者不兼容,也不能混用;切换后端需显式指定,且受硬件和 CUDA 版本限制。
参数差异与影响:
backend="inductor":支持 CPU/GPU,需 CUDA ≥ 11.6,对 Ampere+ 架构优化最好;但某些自定义算子(如带 atomicAdd 的 CUDA kernel)可能被跳过或报UnsupportedNodeErrorbackend="nvfuser":仅限 GPU,需 CUDA ≥ 11.0,旧卡(Pascal/Volta)仍可用;对融合简单循环更稳定,但不支持 dynamic shape、不支持 TorchScript 导出backend="aot_eager":纯 Python 回退,用于 debug,无加速,但可打印完整图结构
实操建议:
- 遇到
inductor编译失败(如Failed to compile generated code),先试backend="nvfuser" - 确认是否启用:
torch._dynamo.list_backends()查看当前可用后端 - 禁用某个后端(如屏蔽 nvfuser):设置环境变量
export PYTORCH_NVFUSER_DISABLE=1
编译失败日志里最该盯住的三类错误线索
别急着重装,先看报错末尾的 root cause。真正卡住编译的往往不是顶层异常,而是嵌套在 torch/_inductor/codegen 或 torch/_dynamo/output_graph.py 里的底层提示。
重点关注:
Cannot infer dtype for:说明某中间节点类型丢失,常见于未设dtype的空 tensor 创建(如torch.empty(())),补上dtype=torch.float32Unsupported op: aten.xxx.default:Dynamo 当前不支持该算子(如aten._local_scalar_dense),尝试用等价写法替代(如改用.item()前加.detach())cudaMalloc failed: out of memory:不是显存不够,而是 Inductor 编译期申请显存失败,大概率是 CUDA context 冲突,重启 Python 进程并清空/tmp/torchinductor_*
复杂点在于:同一个模型,在 A 机器上 inductor 成功、B 机器失败,可能只差一个 LD_LIBRARY_PATH 里的 cuBLAS 版本;这种环境毛刺很难复现,也最难调试。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
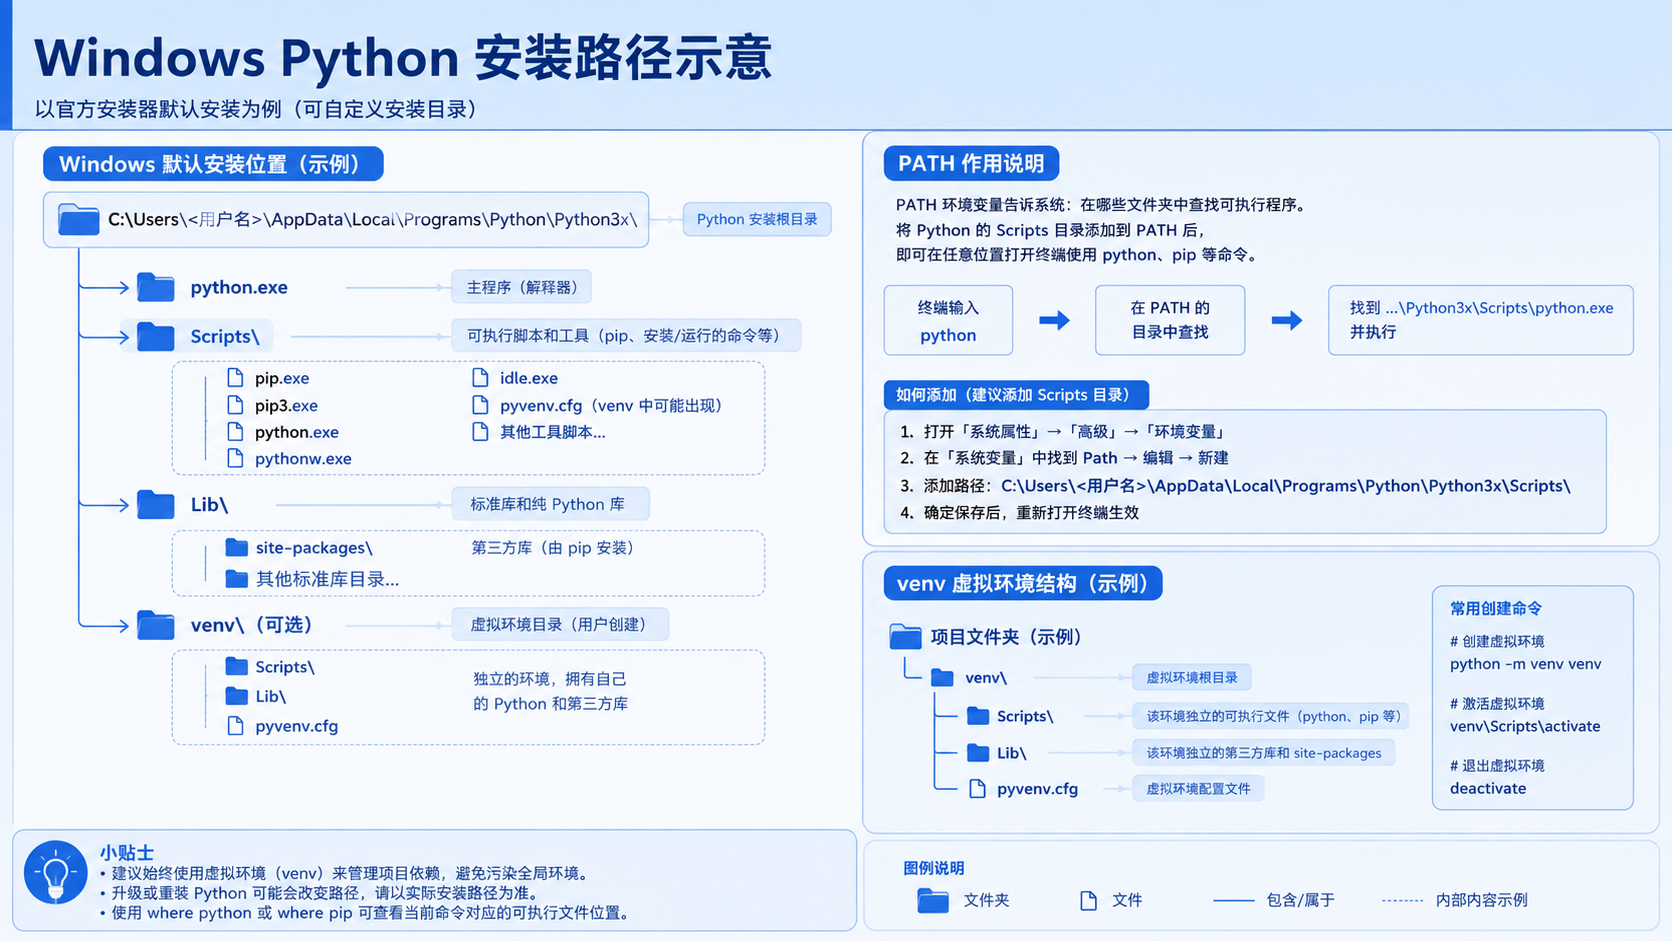
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
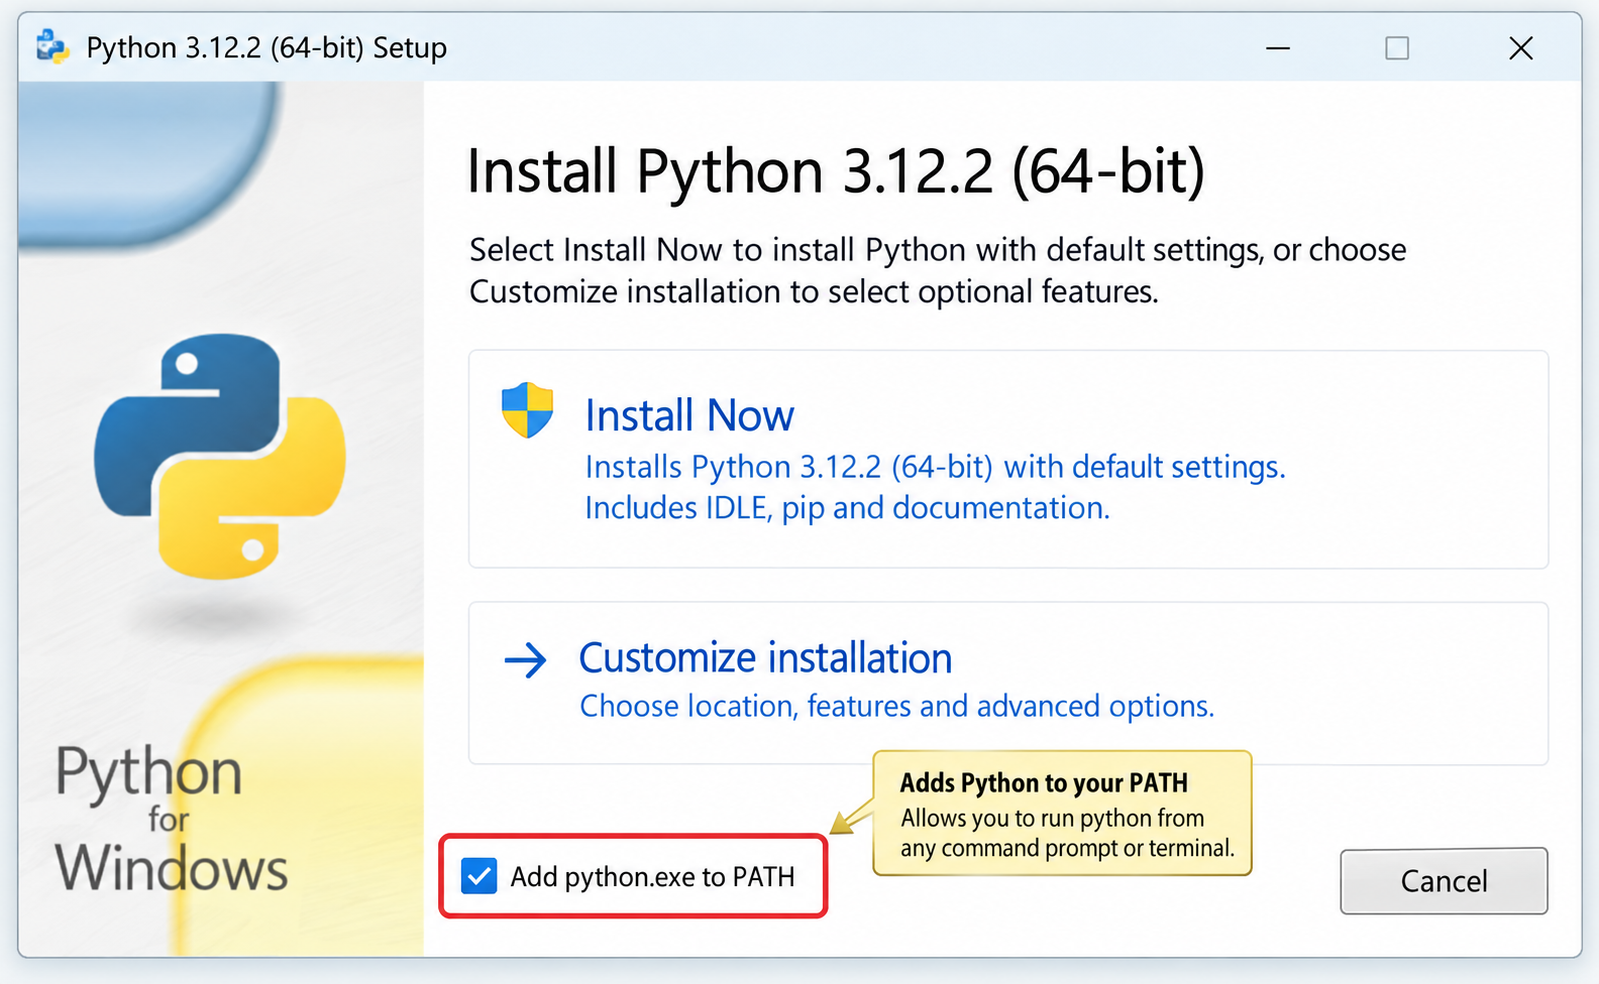
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
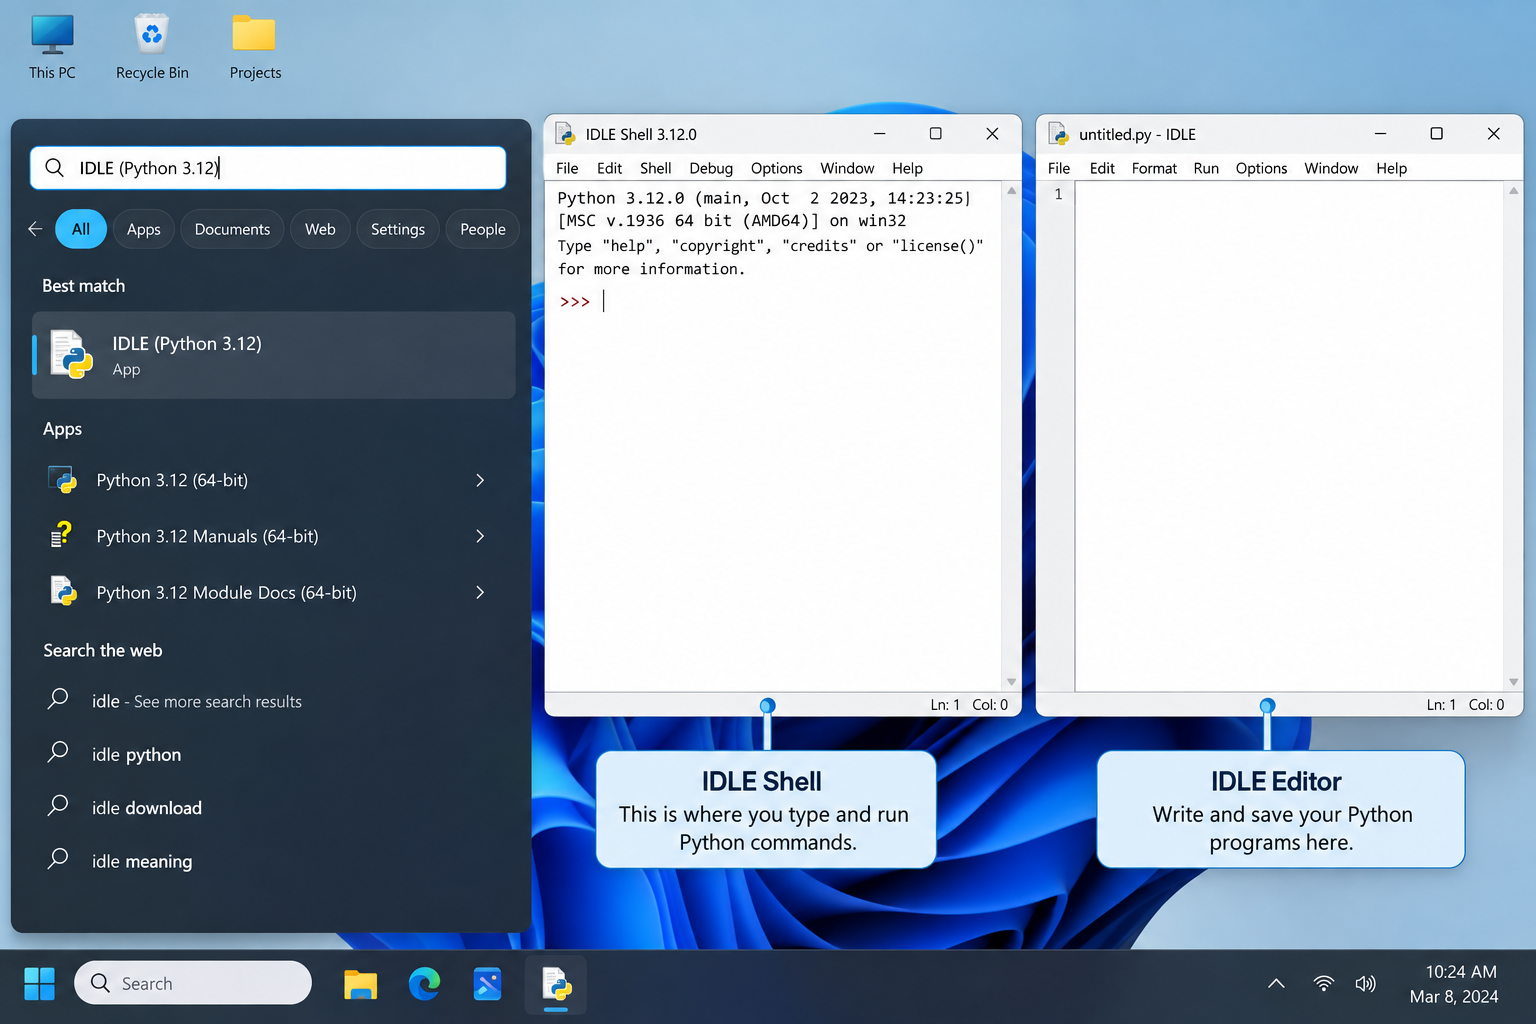
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
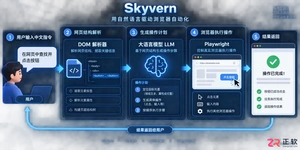
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,