

用pandas轻松读取Excel文件的方法
使用Pandas读取Excel文件的简便方法在数据分析和处理中,经常需要从Excel文件中读取数据并进行各种操作。Pandas是一个强大的Python数据分析库,它提供了一种简单方便的方法来读取Excel文件。本文将介绍如何使用Pandas来读取Excel文件,并提供具体的代码示例。在开始之前,确保已经安装了Pandas库。可以使用以下代码安装Pandas:
使用Pandas读取Excel文件的简便方法
在数据分析和处理中,经常需要从Excel文件中读取数据并进行各种操作。Pandas是一个强大的Python数据分析库,它提供了一种简单方便的方法来读取Excel文件。本文将介绍如何使用Pandas来读取Excel文件,并提供具体的代码示例。
在开始之前,确保已经安装了Pandas库。可以使用以下代码安装Pandas:
pip install pandas
接下来,我们假设有一个名为"example.xlsx"的Excel文件,其中包含了一个名为"Sheet1"的工作表。在这个工作表中,有一些数据,包括姓名、年龄和性别。我们将从这个Excel文件中读取数据。
首先,让我们导入Pandas库并读取Excel文件:
import pandas as pd

df = pd.read_excel('example.xlsx', sheet_name='Sheet1')在上面的代码中,我们使用read_excel函数来读取Excel文件。其中,example.xlsx是要读取的Excel文件的文件名,sheet_name='Sheet1'是要读取的工作表的名称。如果不指定sheet_name参数,则默认读取第一个工作表。
读取Excel文件后,Pandas将数据以DataFrame的形式存储在变量df中。DataFrame是一种二维标签数组,类似于Excel中的表格。每列的名称称为列标签,而每行的索引称为行标签。
现在,我们可以对读取到的数据进行各种操作,比如查看前几行的数据、获取某列的数据、筛选数据等。
查看前几行的数据:
print(df.head())
获取某列的数据:
name_column = df['姓名']
print(name_column)
筛选数据:
filtered_data = df[df['年龄'] > 30]
print(filtered_data)
上面的代码中,df.head()将显示DataFrame的前几行数据,默认显示前5行。df['姓名']将获取名为"姓名"的列的数据,而df[df['年龄'] > 30]将根据"年龄"列的条件筛选出符合条件的数据。
除了读取Excel文件,Pandas还提供了其他一些方法来处理Excel文件,例如写入数据到Excel文件、添加新的工作表等。下面是一些常用的方法:
将DataFrame写入Excel文件:
df.to_excel('output.xlsx', sheet_name='Sheet2', index=False)上面的代码将DataFrame写入到"output.xlsx"文件的名为"Sheet2"的工作表中,并设置
index=False以不包含行索引。添加新的工作表到现有的Excel文件:
with pd.ExcelWriter('example.xlsx', mode='a') as writer:
 df.to_excel(writer, sheet_name='Sheet2', index=False)
上面的代码使用
pd.ExcelWriter将DataFrame写入到现有的Excel文件中,并设置mode='a'以追加写入。df.to_excel()方法将DataFrame写入到"Sheet2"工作表中。
通过使用Pandas,我们可以轻松读取和处理Excel文件,并且能够进行各种操作,使数据分析和处理更加高效和便捷。以上就是使用Pandas读取Excel文件的简便方法的介绍和示例代码。希望对你有所帮助!
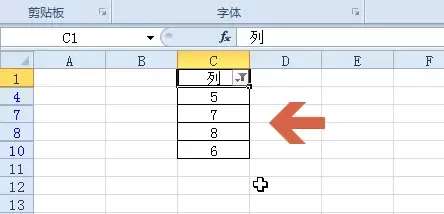
本教程演示如何在Excel中筛选大于指定数值的数据。核心步骤包括:确保数据连续、选中表头、通过“开始→排序和筛选”开启筛选,并在“数字筛选”中选择“大于”输入阈值。筛选仅隐藏不符合条件的行,不删除数据。完成后需逐行验证可见数据是否均大于阈值,并可通过取消筛选恢复全部数据。
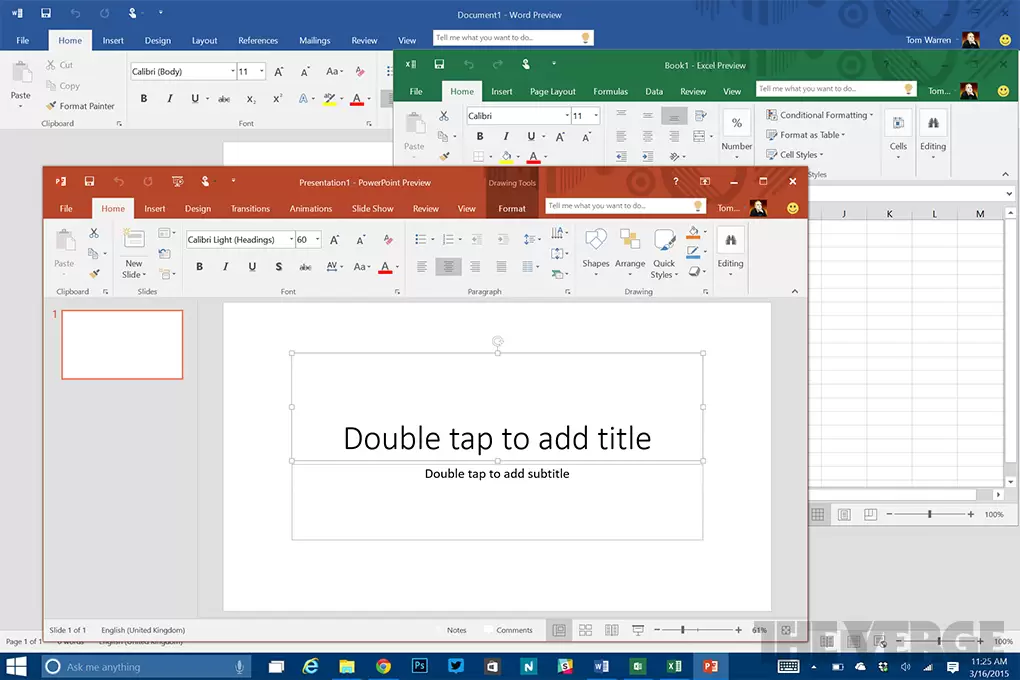
本文通过“活动报名与费用汇报”真实案例,演示如何高效协同使用Word、Excel和PPT。从建立规范的项目文件夹开始,分别完成Word内容撰写、Excel数据统计与PPT结论展示,并强调多软件间数据一致性与交付检查的重要性,帮助新手建立完整的办公任务处理逻辑。
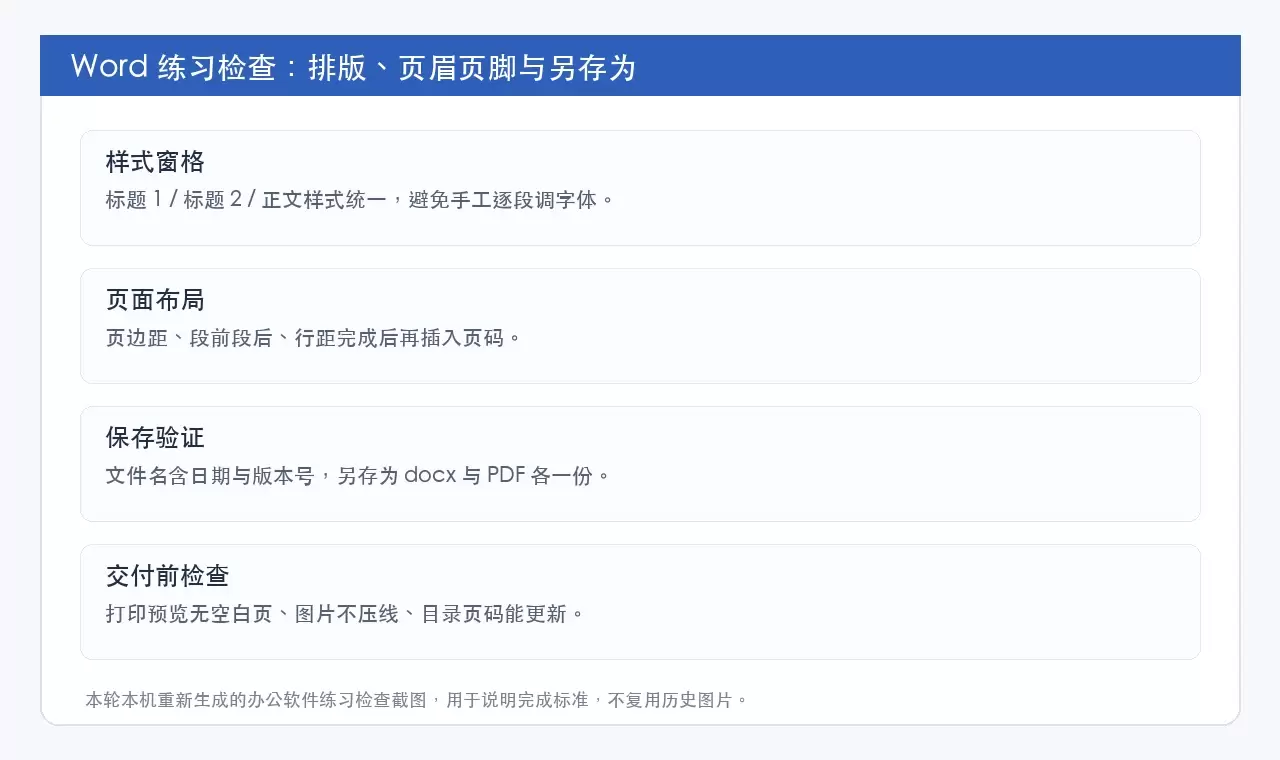
本文提供Word、Excel和PPT的零基础自学路线,强调以“可交付成果”为导向而非功能堆砌。通过分阶段练习文档排版、数据表格处理及演示文稿制作,帮助新手建立规范的文件管理、公式核对及放映检查习惯,快速掌握日常办公核心技能。
在日常工作中,台账的建立与统计几乎是绕不开的活儿——无论是考勤记录、项目跟踪,还是财务核算,一套清晰的台账就是效率的基石。而Excel,说它是实现这一目标的“利器”恐怕没人会反对。它既能帮你快速搭建表格,又能通过公式和透视表让数据自己“说话”。今天就来聊聊,怎么用Excel把台账这件事做到既省力又精
大家有没有遇到过PDF里的表格无法直接编辑的情况?这时候,将其转换为Excel再进行数据整理就会方便很多。下面,我给大家详细介绍3种完整的操作方法,每一步都配有对应的操作截图,同时还会说明普通PDF和扫描版表格在处理上的区别。 方法一:用极轻PDF转换Excel极轻PDF(pdf.cn)的PDF转E
在Mac系统中,Safari和Chrome浏览器均不支持直接将书签导出为Excel的.xlsx格式,若想实现这一操作,需借助第三方工具或手动中转。具体而言,可先利用Safari浏览器将书签导出为Bookmarks.html文件,随后再通过Excel、Numbers等软件打开并进行格式转换;或者运行P
Word表格转Excel时,建议先转为PDF固定排版,再使用PDF转Excel工具提取数据。常用在线工具包括极轻PDF、PDFCandy和CleverPDF。转换后需重点检查合并单元格、数字格式、跨页表格及空白行,确保数据准确。此外,注意保护隐私,避免上传敏感文件。
将图片表格转为Excel需先通过图片转PDF工具生成PDF,再使用PDF转Excel工具提取数据。三种方法分别依赖极轻PDF、Convertio和PDFCandy,操作核心包括上传图片、转换格式、下载结果,完成后需核对行列、数字及合并单元格。
将Word表格直接复制到Excel易导致合并单元格错位、内容换行混乱。稳妥方法是先转PDF再提取表格,可使用极轻PDF、PDFCandy等工具,转换后需仔细核对行列、合并单元格、数字格式及计算公式,确保数据准确无误。
PDF表格转Excel可通过极轻PDF、CleverPDF、PDF24等在线工具完成,上传文件后转换并下载校验。扫描版PDF需先OCR识别再转换,重点核对小数点、负号、日期及跨页表格衔接,不可直接使用转换结果。建议对关键数据人工复核,确保准确。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
