

datatable 库与其他数据分析工具对比选型
在数据分析中,Pandas适合中小型数据,提供灵活API;Datatable专为大规模数据设计,性能高;PySpark面向分布式集群,处理海量数据。选型需根据数据规模:GB级以下用Pandas,数十GB以上追求性能可选Datatable,TB级海量数据适合PySpark。
数据处理领域的多面手
在数据科学和统计分析领域,高效处理大规模数据集是日常工作的重要基石。随着数据量的爆炸式增长,传统的工具在处理速度和内存效率上常常面临挑战。因此,一系列专为高性能计算而设计的库应运而生,它们各自拥有独特的架构和优化策略,旨在解决不同场景下的数据处理瓶颈。了解这些工具的核心差异,对于开发者根据项目需求做出合理的技术选型至关重要。
核心架构与性能基准
在众多工具中,一个以C++为后端、专注于大数据处理的库因其卓越的性能而备受关注。它的设计哲学是最大化内存效率和处理速度,尤其擅长对超过内存容量的大型数据集进行快速操作。其内部采用了一种独特的列式压缩存储格式,并实现了多线程并行处理,使得在数据聚合、过滤和连接等操作上,相比传统工具有着数量级的提升。性能基准测试显示,在处理数十GB甚至更大规模的数据时,其速度优势尤为明显。
相比之下,基于Python的Pandas库以其直观的DataFrame结构和丰富的API成为了数据探索和分析的行业标准。它构建在NumPy之上,对于能够完全放入内存的中小型数据集,提供了无与伦比的灵活性和易用性。然而,当数据量超出内存时,Pandas需要借助分块处理等技巧,其原生性能会受到影响。另一个流行的工具是PySpark,作为Apache Spark的Python接口,它专为分布式计算设计,擅长在集群上处理海量数据,但其启动开销和单机模式下的性能通常不如专门优化的单机库。
语法与易用性对比
工具的语法和API设计直接影响开发者的生产力和学习成本。Pandas在这方面具有显著优势,其链式调用和类似SQL的操作方式非常符合数据工作者的思维习惯,文档和社区资源也极其丰富。这使得快速的数据清洗、转换和可视化变得轻而易举。
而像Datatable这样的库,其语法更接近于R语言的data.table包,追求的是极致的表达效率。它通过一种特殊的方括号语法,将行筛选、列选择、分组聚合等操作高度浓缩。对于熟悉其语法的用户,可以用非常简洁的代码完成复杂操作,但新手可能需要一定的学习适应期。PySpark的语法则具有明显的函数式编程和分布式计算特征,其延迟执行模型与单机工具差异较大,需要开发者具备一定的分布式系统概念。
生态系统与集成能力
一个工具的生命力很大程度上取决于其周边的生态系统。Pandas在这方面无疑是王者,它几乎与Python数据科学栈的所有成员无缝集成,包括NumPy、Matplotlib、Scikit-learn等。数据可以轻松地在这些库之间流转,形成完整的工作流。此外,Pandas拥有海量的第三方扩展和教程,任何问题几乎都能在社区找到答案。
高性能库通常更专注于核心的数据操作引擎,其生态系统相对专注。它们的主要目标是与Pandas之间进行高效的数据转换,让用户可以在需要性能瓶颈处切换使用。例如,可以从文件快速读取数据并处理,然后转换为Pandas DataFrame进行后续的深入分析或绘图。PySpark则拥有庞大的大数据生态系统支持,能够与HDFS、Hive、Kafka等大数据组件协同工作,适合已经构建在Hadoop/Spark技术栈上的企业环境。
如何根据场景进行选型
选择合适的工具没有绝对的标准,关键在于匹配项目需求。对于数据量在GB级别以下、主要在单机进行探索性分析、且需要快速迭代和可视化的场景,Pandas是最稳妥、效率最高的选择。其强大的功能和易用性足以应对绝大多数数据分析任务。
当面对的数据集规模达到数十GB或更大,且操作涉及大量的分组、聚合或连接,对性能有极致要求时,考虑使用像Datatable这样的高性能单机库是明智的。它能够节省大量的计算时间,尤其是在数据预处理和特征工程阶段。
如果数据规模是TB或PB级别,并且需要在多台机器组成的集群上进行分布式处理,那么PySpark或类似的分布式框架是必然的选择。它适合生产环境下的稳定、大规模数据处理流水线。
在实践中,混合使用多种工具正成为一种常见模式。例如,使用高性能库进行初始的数据加载和粗粒度清洗,然后转换为Pandas进行精细化的分析和建模;或者,在本地使用高性能库开发原型,然后将逻辑迁移到PySpark上进行集群部署。这种灵活的“用对的工具做对的事”的策略,往往能取得最佳的开发效率和运行性能平衡。
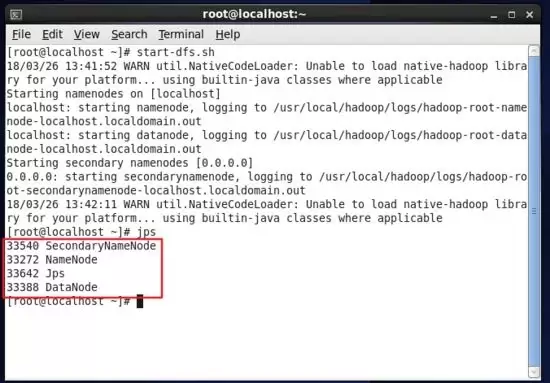
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
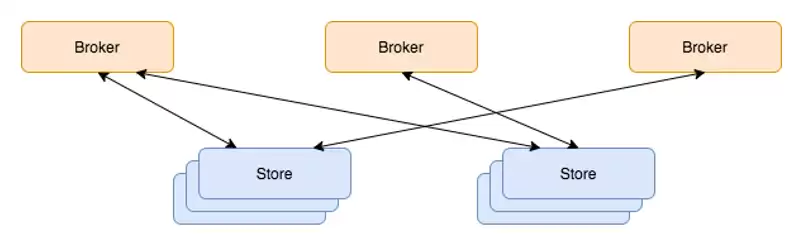
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
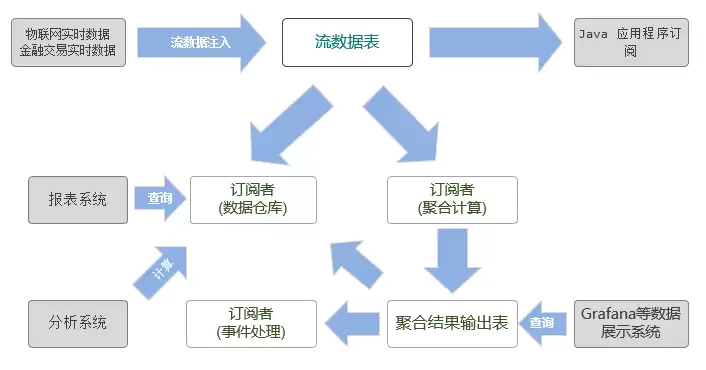
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
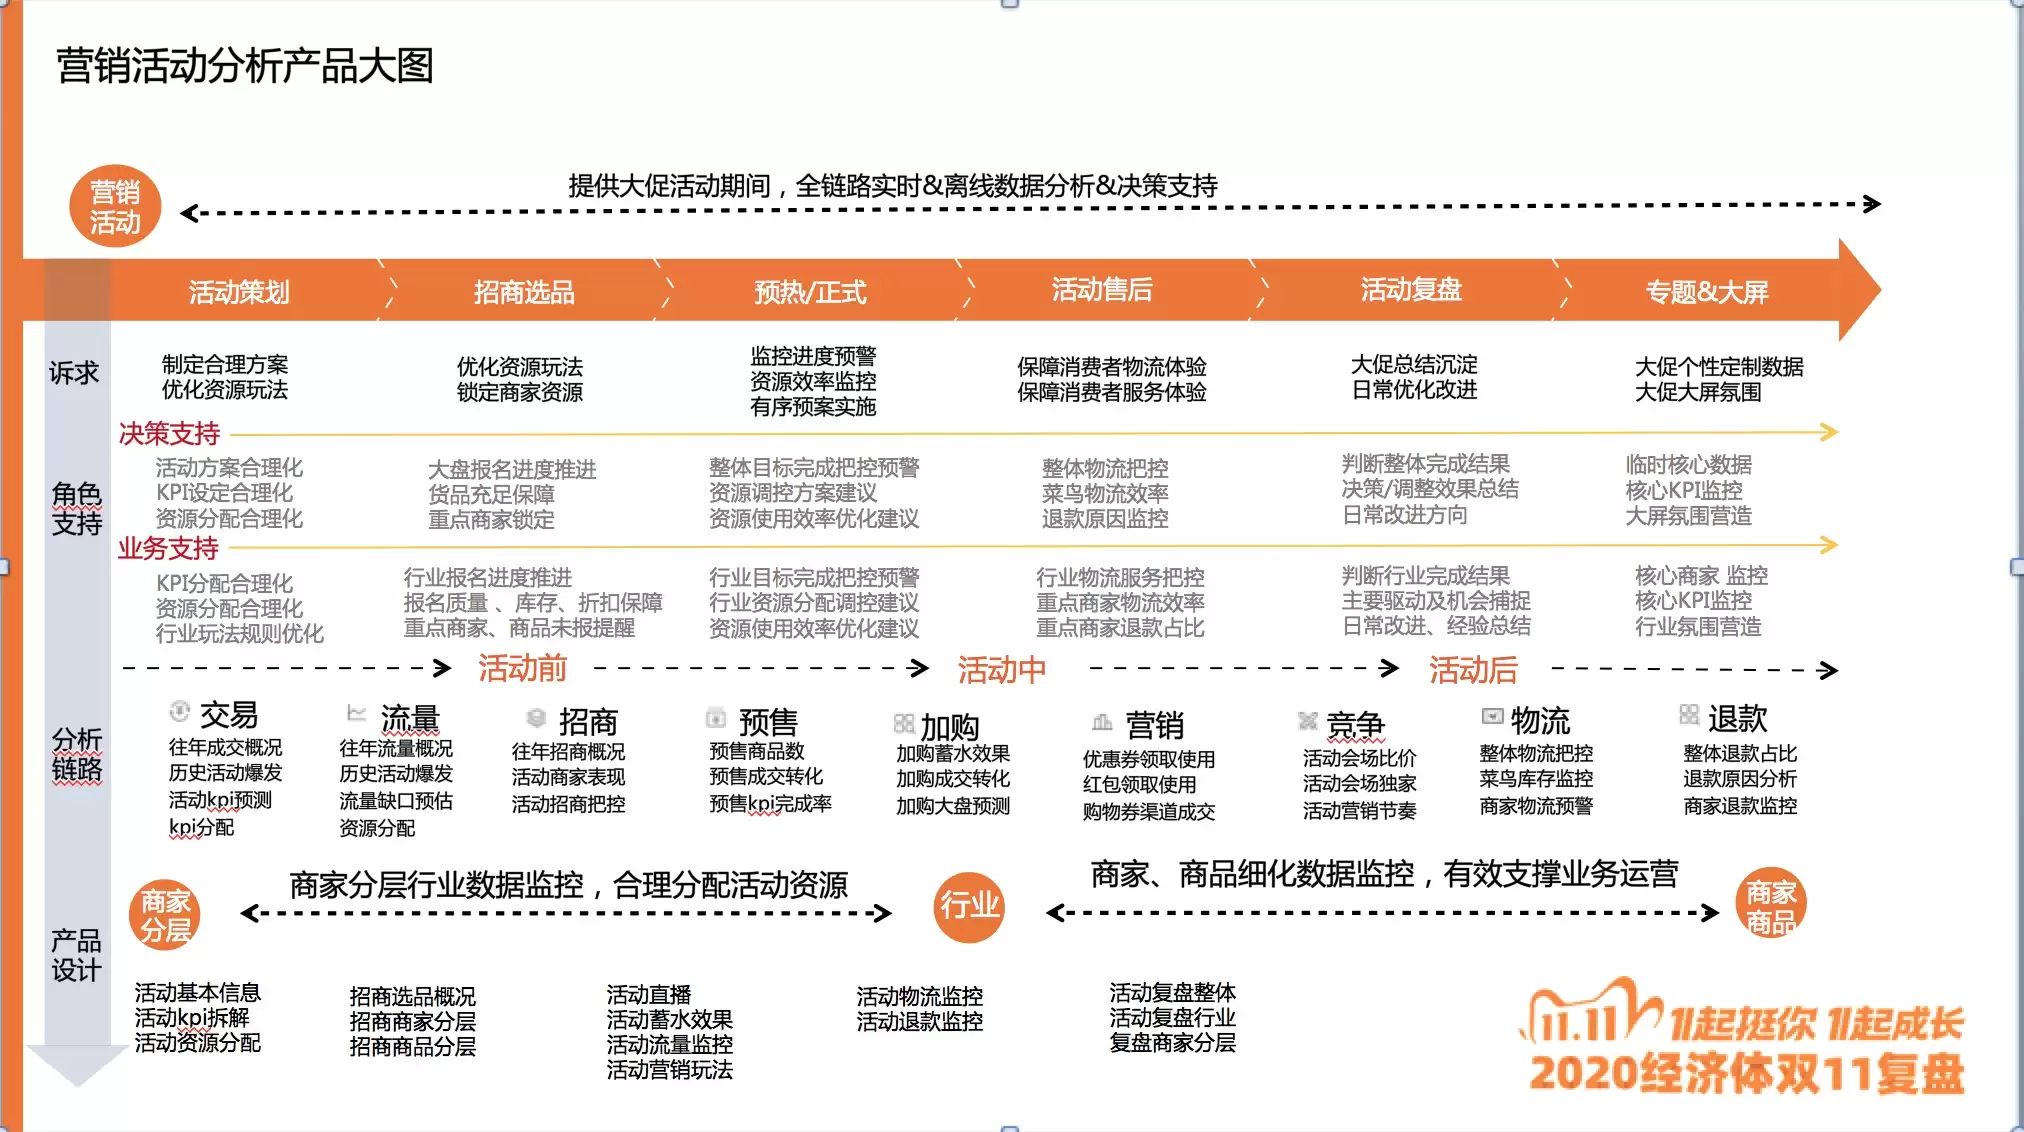
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
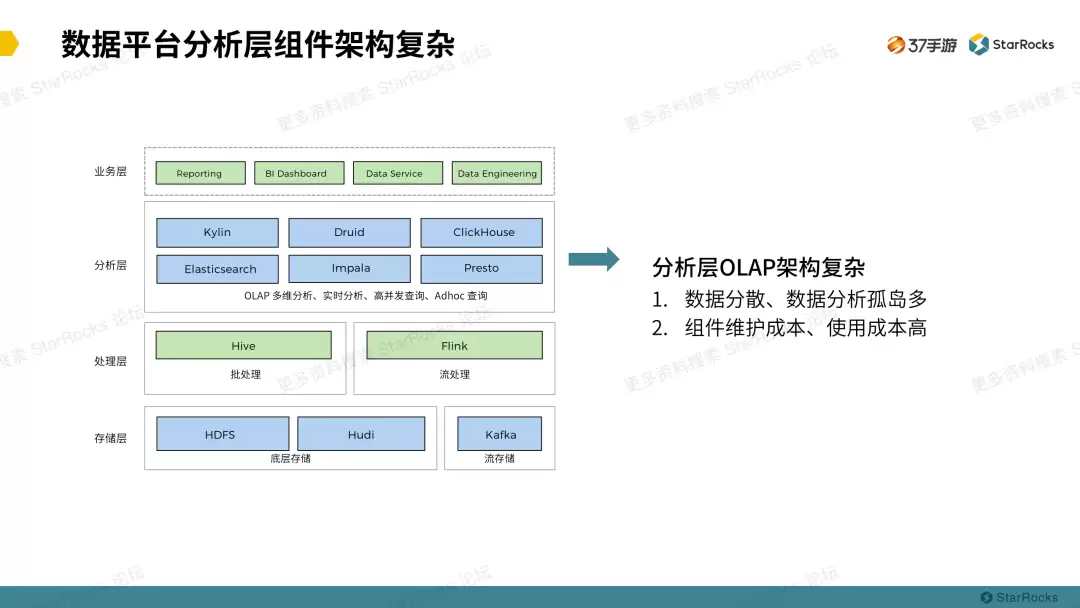
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



