

利用datatable处理大数据实战案例分析
传统工具处理千万级大数据时面临内存与速度瓶颈。Datatable作为高性能库,凭借C++底层和多线程机制,在数据读取、内存占用及分组聚合等关键操作上优势显著。它尤其适用于海量数据的初步过滤与聚合,并能与Pandas协同工作,形成高效处理流程。
大数据处理的挑战与Datatable的定位
在数据科学和工程领域,处理大规模数据集已成为常态。传统的工具如Pandas在数据量达到千万行级别时,常会遇到内存占用过高、处理速度显著下降的瓶颈。尤其是在进行复杂的数据筛选、聚合和连接操作时,性能问题尤为突出。此时,寻求一个兼顾易用性与高性能的替代方案,成为许多开发者和数据分析师的迫切需求。Datatable正是在这样的背景下,作为一个高性能、内存中的数据处理库,进入了人们的视野。
Datatable的设计哲学与Pandas有相似之处,都提供了DataFrame这样的核心数据结构,但其底层实现采用了高度优化的C++代码和多线程处理机制。这使得它在执行某些关键操作时,速度远超同类工具。它并非旨在完全取代Pandas,而是为那些需要处理远超内存容量或对处理速度有极致要求的场景,提供了一个强有力的工具。理解其定位,是有效利用它的第一步。
核心功能与性能优势解析
Datatable的核心优势体现在几个关键操作上。首先是数据读取速度,其内置的Fread解析器能够极其高效地读取大型CSV文件,速度通常比Pandas的read_csv快数倍甚至数十倍。这对于需要频繁加载原始数据的流水线至关重要。其次,在内存使用上,Datatable采用了更紧凑的数据存储格式,相同数据集占用的内存往往更少,这意味着可以在单机上处理更庞大的数据。
在数据操作方面,Datatable的语法虽然有自己的风格,但非常强大。它支持类似SQL的i查询语法,能够快速进行条件筛选、分组聚合、列操作和表连接。其分组聚合操作,特别是在处理具有大量分组键的数据时,性能表现尤为卓越。此外,Datatable支持多线程并行计算,能够自动利用多核CPU资源,将计算任务并行化,从而进一步提升处理速度。
实战案例:电商用户行为日志分析
假设我们需要分析一个电商平台数月的用户点击流日志,原始数据为多个压缩的CSV文件,总行数超过十亿。使用传统工具直接加载几乎不可能。此时,可以借助Datatable进行初步的数据缩减和特征工程。
第一步是分块读取与过滤。我们可以利用Datatable快速读取每个文件,并立即应用过滤条件,例如只保留特定事件类型(如购买、加入购物车)或特定时间段的记录。由于读取和过滤速度极快,可以迅速将数据量降低到可管理的规模。第二步,进行关键聚合。例如,我们需要计算每个用户在过去30天的购买总金额、访问次数和最后访问日期。使用Datatable的分组聚合功能,可以在几分钟内完成对海量日志的滚动窗口计算,生成一个用户级别的特征表。
这个特征表的数据量(用户数)远小于原始日志(行为记录数),此时可以将其转换为Pandas DataFrame或直接保存,供后续的机器学习模型训练使用。这个案例清晰地展示了如何将Datatable用作数据预处理和特征提取的“高性能过滤器”,与下游分析工具形成有效配合。
与Pandas的协同工作流
在实际项目中,完全抛弃Pandas生态并不现实。更佳的策略是建立一种协同工作流。通常的模式是“Datatable用于重型ETL,Pandas用于精细分析”。具体而言,在数据流水线的上游,当需要处理原始、庞大、结构相对简单的数据时,使用Datatable进行加载、清洗、筛选和初步聚合。一旦数据被缩减到百万行乃至更小的规模,便可以将其转换为Pandas DataFrame。
转换过程非常简单,Datatable提供了to_pandas()方法,可以无缝转换。之后,可以利用Pandas丰富的API、成熟的生态系统(如Scikit-learn、Matplotlib)以及更直观的语法进行深入的数据探索、复杂的转换、可视化和建模。这种混合模式既发挥了Datatable的性能长处,又保留了Pandas的灵活性和易用性,是处理大数据问题的实用架构。
注意事项与最佳实践
尽管Datatable性能强大,但在采用时也需注意一些事项。其语法与Pandas有所不同,需要一定的学习成本。例如,它的行筛选和列操作采用了独特的frame[i, j]范式,习惯了Pandas链式调用的用户需要适应。社区规模和第三方库集成度目前仍不如Pandas,遇到复杂问题时,可获取的资源相对有限。
因此,建议在以下场景优先考虑使用Datatable:需要快速读取巨型CSV文件;需要对海量数据进行高效的分组、聚合或连接操作;工作流中存在明显的内存瓶颈。在引入时,可以先从数据管道中最耗时的部分开始试点,用其替换原有的Pandas代码,并对比性能提升。同时,确保团队对基本语法有了解,并建立好与Pandas数据转换的标准接口。通过有选择地应用,Datatable能够成为大数据处理工具箱中一把锋利而高效的尖刀。
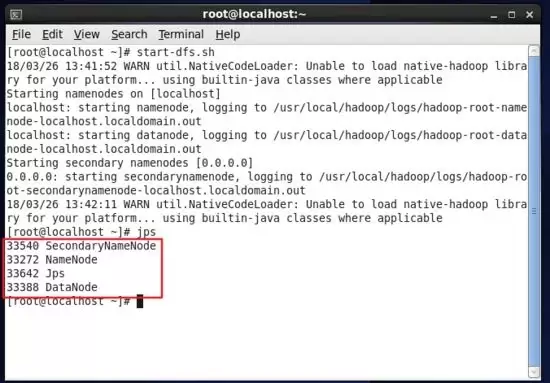
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
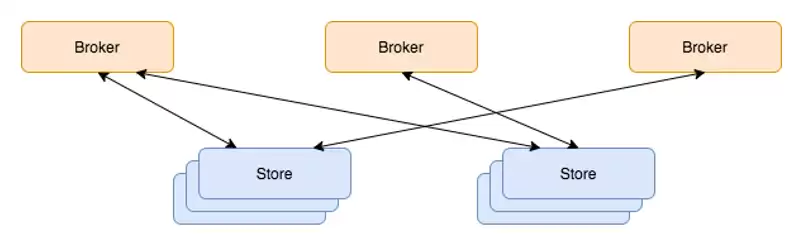
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
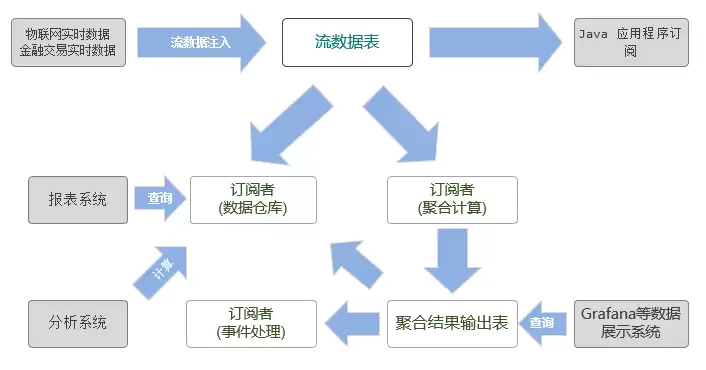
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
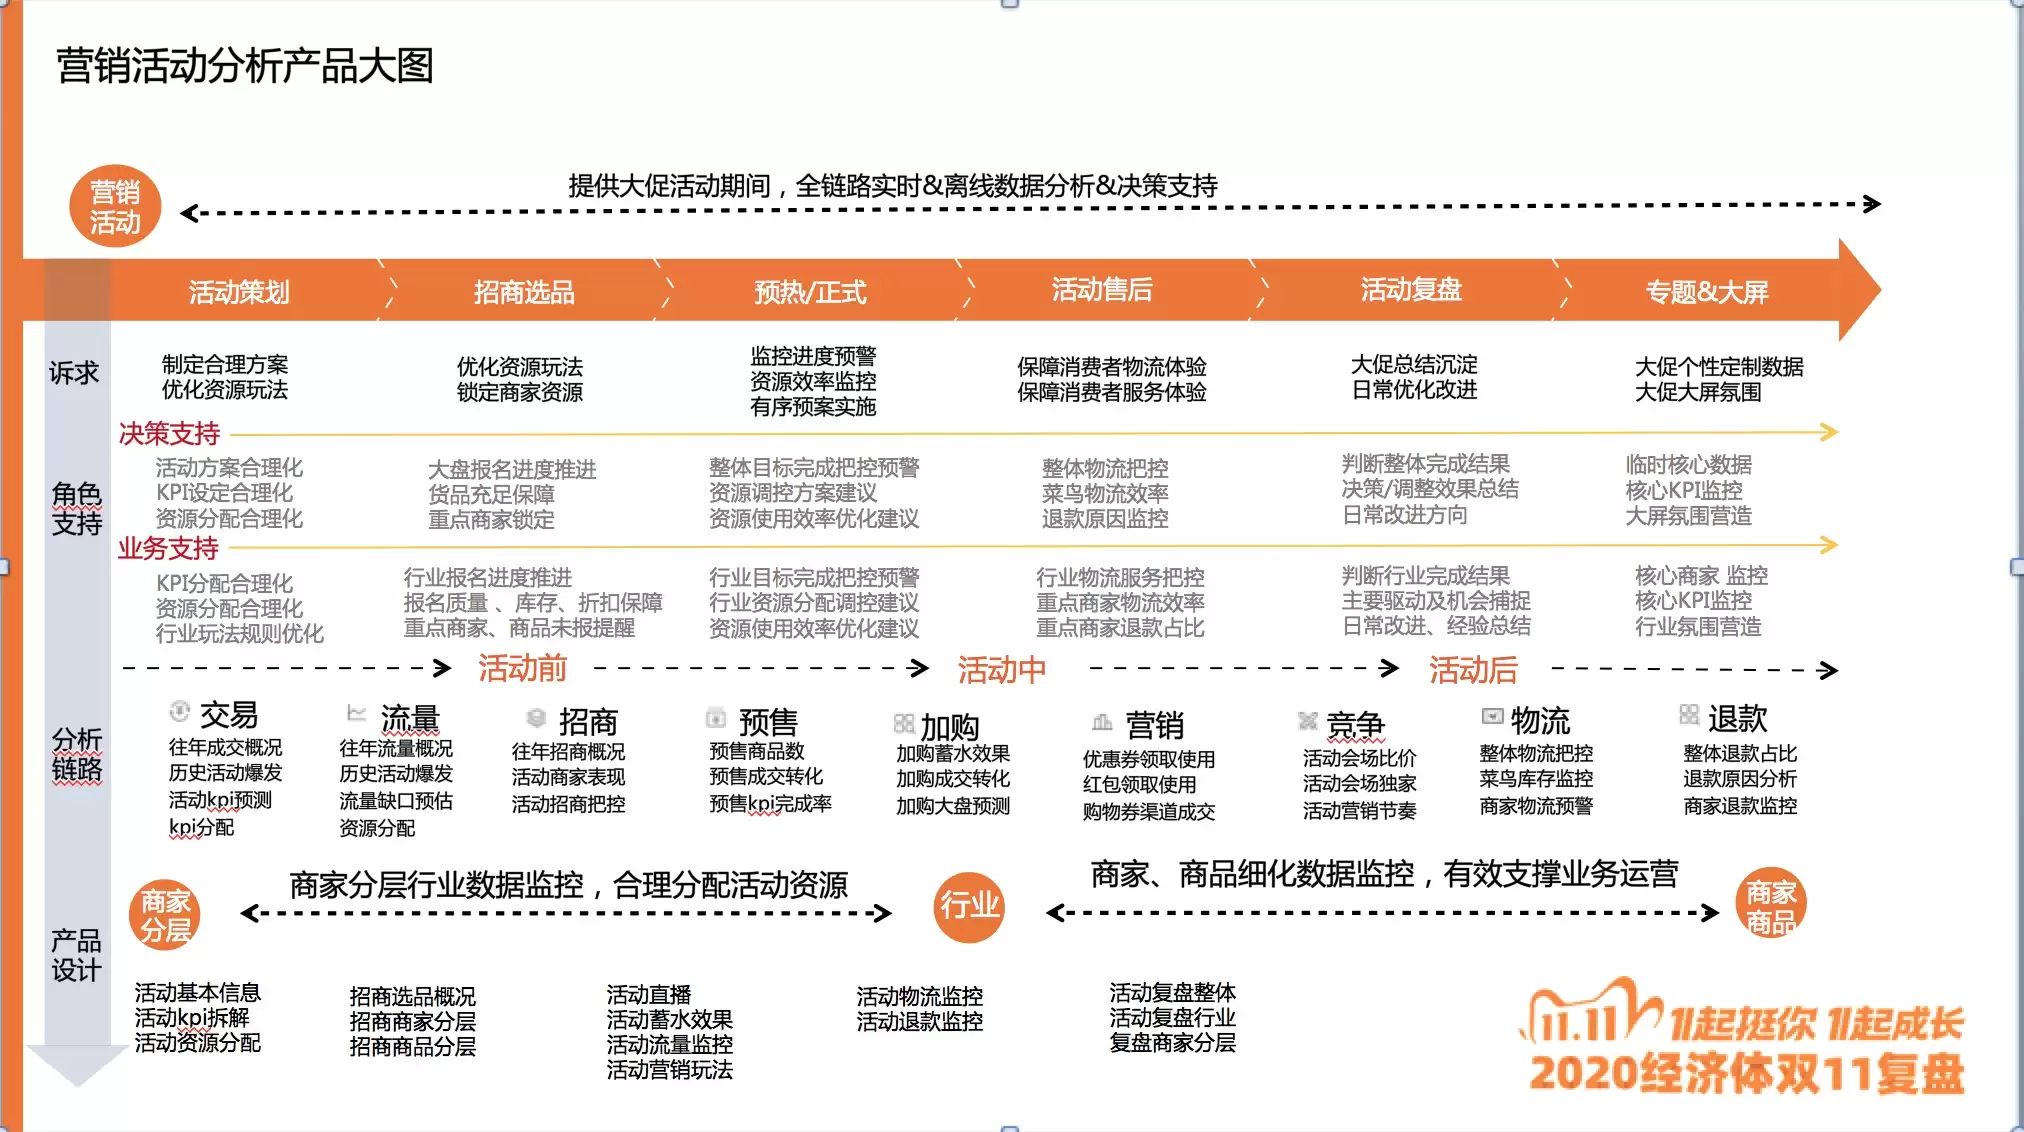
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
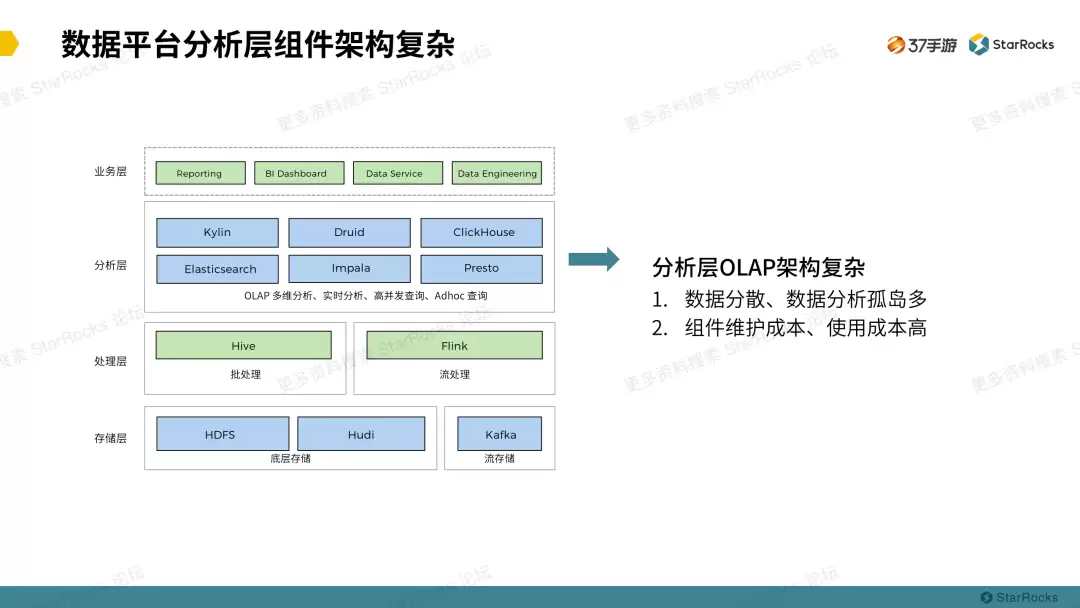
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



