

Scrapy在网站结构分析中的实际应用
随着互联网的普及和发展,越来越多的网站呈现出高度的复杂性和多样性。在这个背景下,网站结构分析显得尤为重要,因为能够帮助我们更好地理解网站的内部结构和组成,进而为相关开发人员提供更加全面和详细的支持。Scrapy是一个用于爬取Web站点和提取结构化数据的Python框架。它基于twisted框架,以异步的方式处理请求。使用Scrapy框架进行网站结构分析,可以
随着互联网的普及和发展,越来越多的网站呈现出高度的复杂性和多样性。在这个背景下,网站结构分析显得尤为重要,因为能够帮助我们更好地理解网站的内部结构和组成,进而为相关开发人员提供更加全面和详细的支持。
Scrapy是一个用于爬取Web站点和提取结构化数据的Python框架。它基于twisted框架,以异步的方式处理请求。使用Scrapy框架进行网站结构分析,可以让我们更好地了解网站的结构和内容,并帮助我们更好地进行数据搜集和处理。
在本篇文章中,我们将介绍在Scrapy框架中应用于网站结构分析的实践。
一、Scrapy的安装和配置
首先,我们需要安装Scrapy。推荐使用pip进行安装,即在命令行中输入:pip install scrapy。
安装完成后,需要进行一些配置。主要包括设置User-Agent和设置爬虫的pipelines。
1.设置User-Agent
在编写爬虫的过程中,我们需要伪造一个User-Agent字符串,使得该爬虫看起来更像一个普通的浏览器,而不是一个爬虫。这样做的好处是避免被网站屏蔽或访问限制。
设置方法是在settings.py文件中加入如下代码:
USER_AGENT = 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/58.0.3029.110 Safari/537.36'
2.设置pipelines
pipelines是Scrapy中数据处理的管道。通过将爬虫获取到的数据传递给pipelines,在pipelines中进行数据的保存和处理。在Scrapy中,一个爬虫可以有多个pipelines,不同的pipeline可以对数据进行不同的操作。
在settings.py文件中加入如下代码:
ITEM_PIPELINES = {
'scrapy_test.pipelines.MyPipeline': 300,
}
其中,300表示pipeline的优先级。Scrapy默认使用的管道中,保存数据到CSV文件的优先级为最高,为500。我们可以在自己的pipeline的优先级低于500,高于其他默认的pipeline。
二、Scrapy的使用
在完成Scrapy的安装和配置后,我们现在可以开始编写我们的爬虫了。在Scrapy中,通过编写spider和items两个基本组件,实现对网站的结构分析和数据提取。
1.编写Spider
在Scrapy中,爬虫是基础组件之一。通过编写爬虫代码,我们可以控制爬虫的访问和抓取流程,从而实现想要的结果。
通过创建一个Spider类,并继承scrapy.Spider,然后在类中实现name,start_url,parse三个属性和方法,可以轻松地实现爬虫的编写。
代码片段:
import scrapy
class MySpider(scrapy.Spider):
name = 'myspider'
start_urls = ['http://www.example.com']
def parse(self, response):
yield {'text': response.css('title::text').get()}
其中的start_urls是Spider开始爬取的网址,parse是当Spider访问start_url网址后,前取到的HTML内容的处理方法。
2.编写Items
Items是Scrapy的另一个基础组件,其主要作用是用于数据提取和结构化处理。
通过定义一个Item类,类似于定义一个表格的字段,可以实现对数据的结构化处理。
代码片段:
import scrapy
class MyItem(scrapy.Item):
title = scrapy.Field()
link = scrapy.Field()
以上代码定义了一个Item类,包含了title和link两个属性。每个属性都是一个scrapy.Field对象,它们定义了获取到的数据的类型。在爬取完成后,Scrapy会将数据保存到一个Python字典中,键名对应Item中存储的属性,键值对应获取到的数据。
三、结果分析和处理
在完成爬虫的编写后,我们就可以通过运行爬虫程序,查看获取到的数据结果。
如果我们需要将数据存储到数据库中,可以通过编写一个Item Pipeline,实现对获取到的数据的进一步处理和保存到数据库中。
代码片段:
import pymongo
class MyPipeline(object):
def __init__(self):
    self.client = pymongo.MongoClient()
    self.db = self.client['mydb']
def process_item(self, item, spider):
    self.db['mydb'].insert(dict(item))
    return item
在以上代码中,我们通过pymongo库连接到了MongoDB数据库,并将获取到的数据保存到了该数据库中。
总结
Scrapy是一个强大的基于Python语言的爬虫框架,它提供了完整的爬取和数据处理的解决方案。在实践中,Scrapy可以方便地实现对网站的结构分析和数据提取,让我们更好地认识网站的内部构成和组成,从而为相关开发人员提供更大的支持。
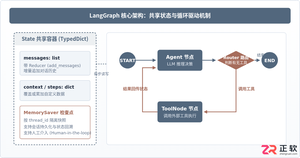
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
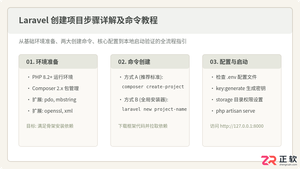
详解使用Composer与Laravel安装器创建Laravel项目的完整步骤、核心命令及环境配置,包含目录权限、环境文件与常见报错排查。
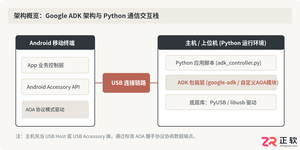
本教程详细介绍 Google ADK(Android Accessory Development Kit)在 Python 环境下的安装与配置方法,涵盖 Python 基础环境检查、虚拟环境搭建、依赖库与包安装、以及硬件通信权限排查。
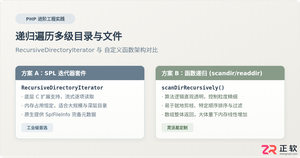
深入解析在PHP中递归遍历多级目录文件的两种核心方案:基于SPL标准库的RecursiveDirectoryIterator高效流式迭代,与基于scandir/opendir的自定义递归函数实现,剖析执行机制、内存表现与实战避坑指南。
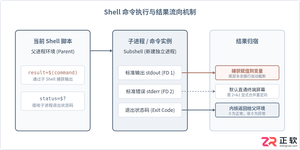
详细讲解在Shell脚本中执行命令并获取执行结果的常用方法,涵盖标准输出捕获、退出状态码判断、错误流重定向、多行结果处理及常见避坑要点。
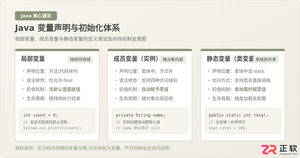
系统解析Java局部变量、成员变量与静态变量的定义语法、声明与初始化机制、生命周期及JVM内存驻留规则,结合图解与代码示例分析常见编译错误与认知误区。
详解如何在Windows 10/11上安装Claude Code。涵盖WSL与Git Bash终端选择、Node.js版本检查、npm全局安装步骤、身份验证流程及claude doctor诊断方法,帮助开发者快速搭建本地AI编码助手。
深入浅出解析TypeScript是什么语言。本文详细介绍TypeScript的语言定义、超集架构、核心运行原理、与JavaScript的核心对比以及四类典型工业级应用场景,帮助读者全面看懂TS的价值与用途。

详解如何在 Windows 电脑上通过 Microsoft Store 安装 Codex 桌面应用,包括启动登录、切换 Codex 模式、关联本地代码项目及终端环境配置的界面操作指引。




WPS Office是一款面向macOS用户的综合办公套件,将文字处理、电子表格、演示文稿、PDF工具、模板与云协作整合在同一应用中。它兼容常见Microsoft Office格式,支持Intel及Apple芯片Mac,基础功能可免费使用,

Shapr3D是一款面向工业设计、机械工程、建筑概念和三维打印工作流的CAD软件。Mac版采用Parasolid建模内核,支持草图约束、实体建模、工程图、可视化渲染及常见CAD格式交换,并可通过账户在多台设备之间同步项目。

REAPER是Cockos开发的数字音频工作站,提供多轨音频与MIDI录制、剪辑、处理、混音和母带制作工具。Mac版兼容Intel与Apple芯片,支持AU、VST、VST3、CLAP等插件格式,并提供高度可定制的工作流程。

Adobe Photoshop 是面向摄影师、设计师和内容创作者的专业图像处理工具,可在 Windows 上完成照片修饰、选区抠图、图层合成、文字排版、绘画及生成式编辑。软件采用订阅授权,由 Creative Cloud 管理安装、更新与许

Adobe InDesign 是面向印刷与数字出版的专业页面排版工具,可制作书籍、杂志、宣传册、海报、交互式 PDF 和电子书。它提供精细的文字样式、多页面管理、印前检查及多格式输出能力,并能与 Photoshop、Illustrator

Adobe Illustrator 是用于绘制矢量图形、插画、图标、徽标和版式的专业设计工具。它以路径和锚点为核心,作品放大后仍能保持清晰,并提供画板、文字、渐变、图像描摹及精确变换等功能,适合品牌视觉、印刷物料、数字界面和商业插画创作。